
游戏客户端架构 / 系统课时
动画为什么不是逐帧贴图
动画为什么不是逐帧贴图
本篇解决一个常见误解:角色抬手并不意味着资源里存着抬手过程的每张画面。通过对比序列帧与骨骼动画,你将理解动画片段保存了什么,以及运行时如何在任意时间点生成角色姿态。
学习目标
- 区分序列帧贴图、动画片段、关键帧和骨骼姿态。
- 用相邻关键帧计算指定时间的采样值。
- 判断什么场景适合序列帧,什么场景适合骨骼动画。
两种动画到底保存什么
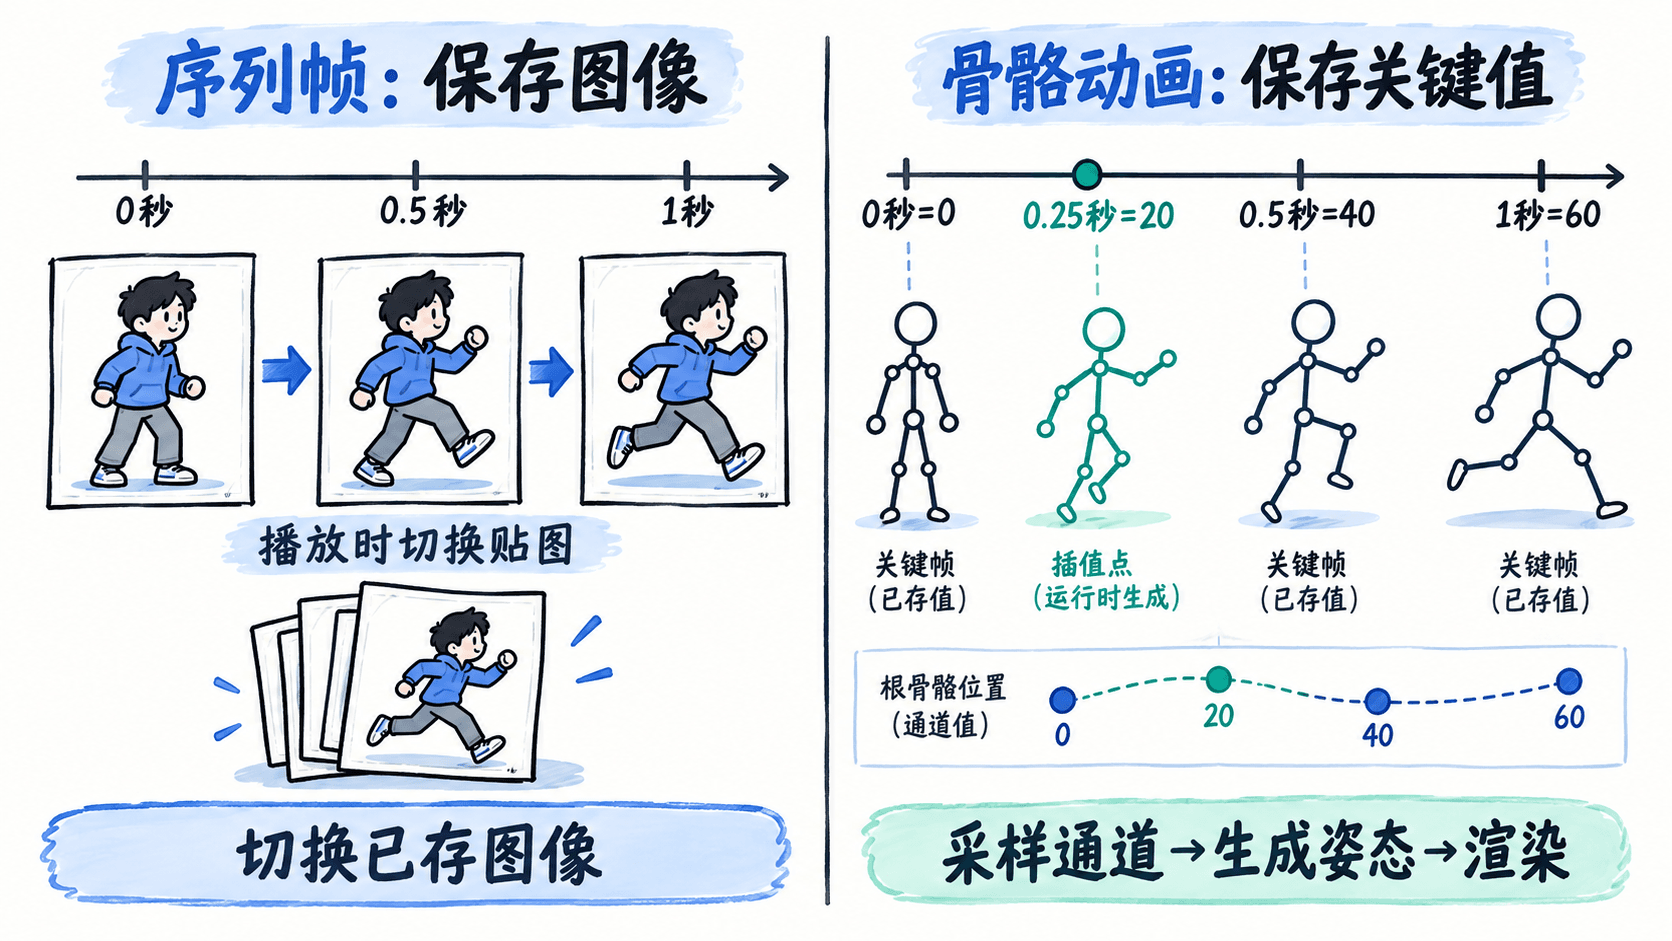
序列帧动画预先准备多张图像,播放时根据时间切换当前图像。它非常适合像素角色、手绘效果和部分粒子特效,是完全有效的游戏动画方式;但动作、视角和装备组合增多时,图像数量可能迅速膨胀。
骨骼动画通常保留一份角色网格和一套骨骼层级,再用随时间变化的位移、旋转、缩放数据驱动骨骼。蒙皮系统依据骨骼姿态计算网格的变形,渲染器才把这一帧绘制为图像。因此,逐帧渲染不等于逐帧储存贴图。
片段、关键帧和姿态如何对应
动画片段(Animation Clip)是一段有时长的动作数据;关键帧记录某个属性在指定时间的值。例如,角色根骨骼的水平位置在 0 秒为 0、0.5 秒为 40、1 秒为 60。它们不是三张画面,只是位置通道上的三个采样锚点。
运行时先找到当前时间落在哪两个关键帧之间,再按插值规则计算中间值。不同骨骼可以有不同的关键帧时间;把所有骨骼在同一时刻的局部变换汇集起来,才得到一份完整的骨骼姿态(Pose)。位移和缩放可按通道线性插值,三维旋转通常使用四元数插值,避免直接混合欧拉角造成不合理转动。
用一次采样验证连续运动
下面只模拟根骨骼的一个位置通道,而不是完整骨骼系统。关键帧之间采用线性插值;首尾范围之外保持边界值,避免读取不存在的区间。将代码保存为 Python 脚本直接运行即可。
keyframes = [(0.0, 0.0), (0.5, 40.0), (1.0, 60.0)]

def sample_position(t):
    # 超出片段时间范围时固定在首末关键值
    if t <= keyframes[0][0]:
        return keyframes[0][1]
    if t >= keyframes[-1][0]:
        return keyframes[-1][1]

    # 在包含当前时间的区间计算插值比例
    for (t0, x0), (t1, x1) in zip(keyframes, keyframes[1:]):
        if t0 <= t <= t1:
            alpha = (t - t0) / (t1 - t0)
            return x0 + (x1 - x0) * alpha
    raise ValueError("关键帧时间未按升序排列")

print(f"x(0.25s) = {sample_position(0.25):.1f}")
print(f"x(0.75s) = {sample_position(0.75):.1f}")
预期输出:
x(0.25s) = 20.0
x(0.75s) = 50.0
在 0.25 秒并没有存放一张“位置为 20”的画面;这是运行时根据相邻关键值计算出来的。实际动作还需要对多根骨骼的多个通道采样,才能构成同一时刻的姿态。
什么时候选用哪种方式
需要精确手绘外形、像素风格或短促特效时,序列帧往往直接可靠;角色需要反复播放、混合跑跳攻击动作、换装备或复用骨骼时,骨骼动画更灵活。某些复杂特效还会使用顶点缓存等逐帧烘焙方式,不必把所有动画都硬归为其中之一。
关键区分在于资产里保存的是什么:保存每张成品图像,就通过时间选择图像;保存随时间变化的姿态参数,就先采样和计算,再得到当前帧画面。