
命令行与文本处理 / 系统课时
并发数量为什么不能无限增加
并发数量为什么不能无限增加
把批处理从串行改成后台并发后,速度通常会先提升,但继续增加任务数会争抢 CPU、内存、文件描述符和网络,并可能把目标系统压垮。本节用一个固定并发上限,把“尽量多跑”改成“保持可控吞吐”。
学习目标
- 解释并发过高导致吞吐下降或失败增多的原因
- 使用 Bash 为后台任务设置固定并发上限
- 根据本机与目标系统的瓶颈调整并发值
并发越高为什么反而变慢
并发任务不是免费的。每启动一个进程,都要占用内存、调度时间、文件描述符和网络连接;如果任务还会访问远端服务器,远端的 SSH 会话数、磁盘 I/O、数据库连接或接口限流也会成为共同瓶颈。
因此,并发数从 1 增加到 2、4、8 时,吞吐可能提高;超过某个点后,进程切换、排队、超时和重试开始增加,总完成时间反而可能变长。并发上限的作用不是让 CPU 永远满载,而是让系统维持稳定的工作集。
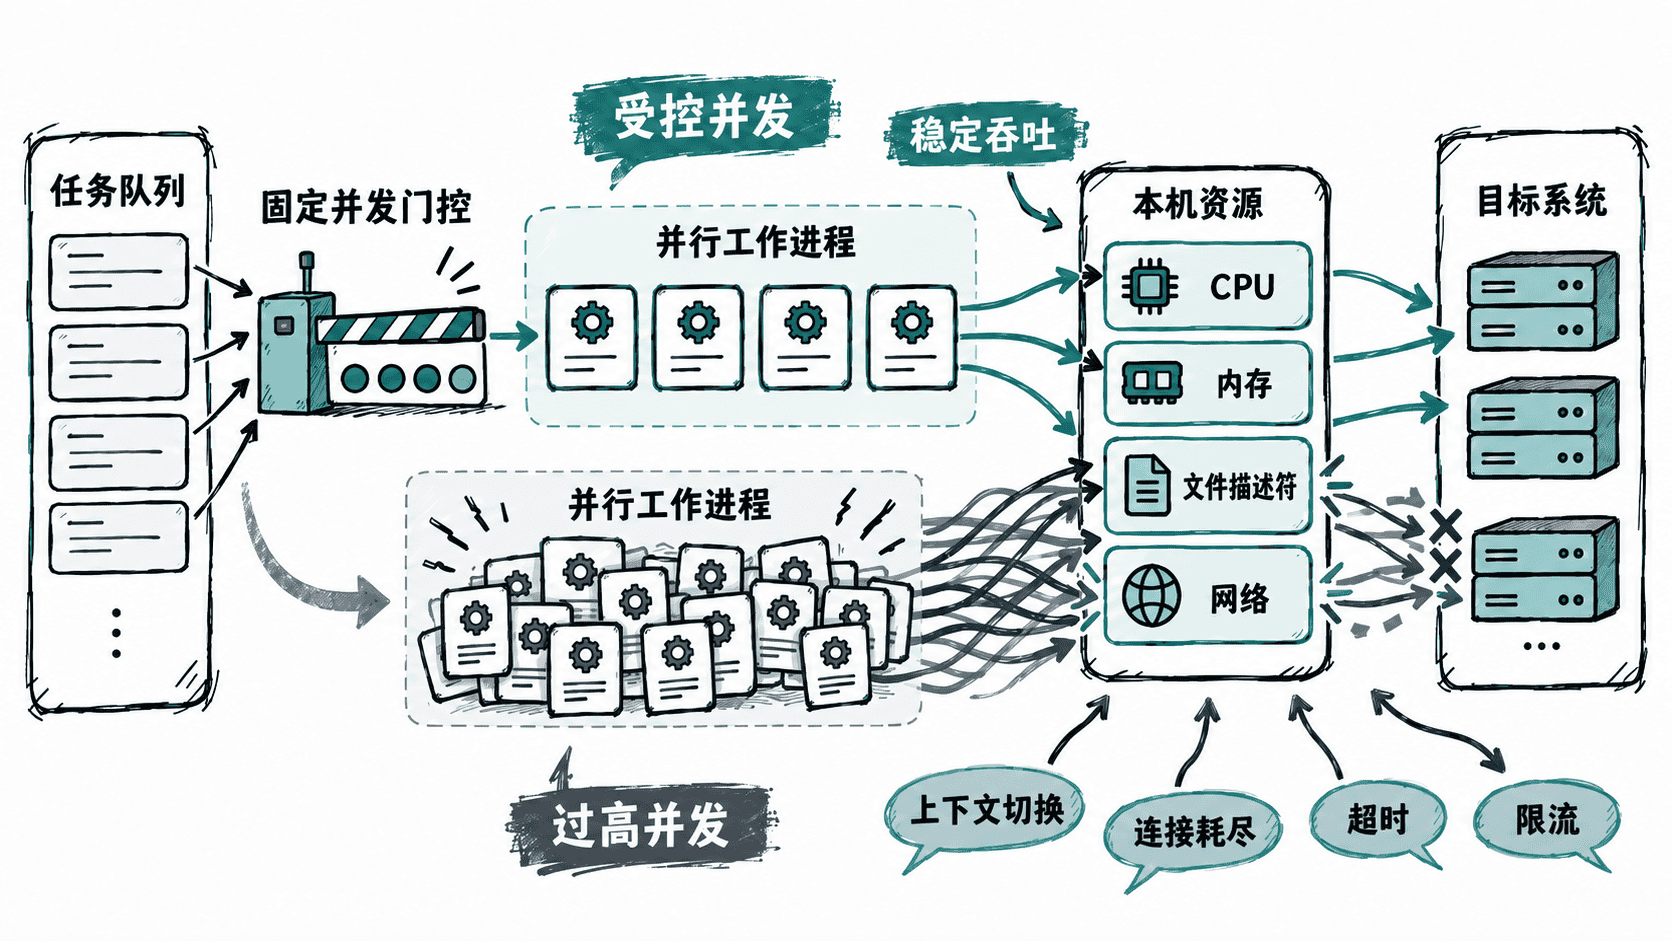
用固定上限控制后台任务
下面的脚本要求 Bash 4.3 或更高版本,因为使用了 wait -n。jobs -rp 统计仍在运行的后台任务;达到上限后,主循环先等待任意一个任务结束,再启动下一个。
bash
#!/usr/bin/env bash
set -u

MAX_CONCURRENCY="${MAX_CONCURRENCY:-2}"

run_one() {
  local id="$1"
  printf 'start %s\n' "$id"

  # 用不同睡眠时间模拟耗时不一致的批处理任务。
  sleep "$((id % 3 + 1))"

  printf 'done %s\n' "$id"
}

for id in 1 2 3 4 5; do
  while (( $(jobs -rp | wc -l) >= MAX_CONCURRENCY )); do
    wait -n
  done

  run_one "$id" &
done

wait
printf 'all done\n'
运行时可以通过环境变量调整上限。
bash
MAX_CONCURRENCY=2 bash concurrency-demo.sh预期输出
text
start 1
start 2
done 1
start 3
done 2
start 4
done 3
start 5
done 4
done 5
all done
任务完成顺序会受调度影响,实际行序可能不同;需要验证的是任意时刻都不会出现超过 2 个尚未结束的任务。
并发上限应该怎么定
没有一个适用于所有脚本的固定数字。可以从 2~4 个并发开始,逐步增加,并观察总耗时、失败率以及本机和目标端资源是否恶化。CPU 密集型任务通常受核心数限制,网络或磁盘任务则可能允许更高并发,但仍受连接数和服务端容量约束。
失败处理不能被并发掩盖
上面的示例只演示并发门控,没有汇总每个后台任务的退出状态。生产脚本如果要求“任一任务失败则整批失败”,还应保存各任务 PID,并逐个 wait 收集退出码,而不是只依赖最后一个 wait。
并发限制的核心是先确定系统能够长期承受的并行工作集,再让任务在这个边界内持续流动。这样通常比一次性启动几十或几百个后台进程更快、更稳定,也更容易排查失败。
按自己的节奏,确认真正理解。