
命令行与文本处理 / 系统课时
自动恢复失败后应该怎么办
自动恢复失败后应该怎么办
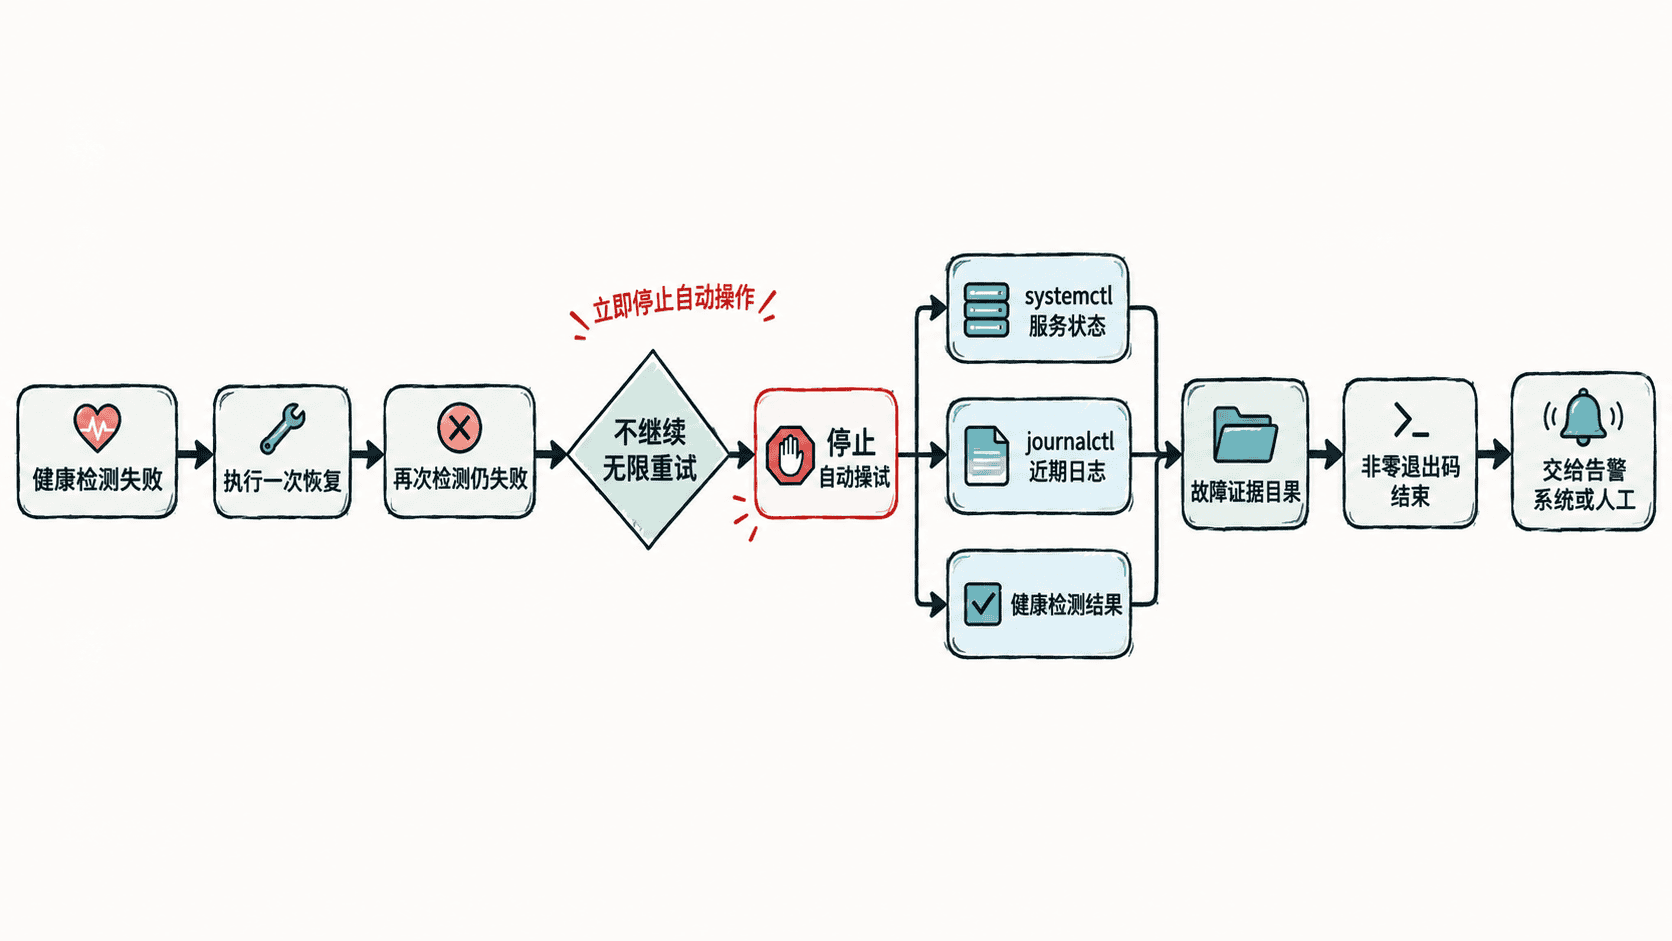
自动恢复脚本最危险的情况不是第一次恢复失败,而是失败后仍不断重启、修改配置或清理现场。本篇把失败后的动作收敛为一条可审计链路:立即停止自动操作,保存服务状态、日志和检测结果,再以失败状态退出,把后续处理交给人工或上层告警系统。
学习目标
- 能在自动恢复失败后停止继续重试,避免扩大故障
- 能保存服务状态、近期日志和健康检测结果作为排障证据
- 能让脚本以明确的非零退出码结束,供 Cron 或监控系统识别
恢复失败后先冻结自动动作
自动恢复通常包含“检测异常 → 尝试恢复 → 再次检测”三个阶段。如果再次检测仍失败,就不应立即进入无限重试。频繁重启可能覆盖关键日志、触发限流,甚至让依赖服务一起抖动。
合理的失败出口应完成四件事:停止新的恢复动作、记录当前状态、保存最近日志、返回非零退出码。需要继续重试时,也应该由上层策略控制次数和间隔,而不是在失败分支中无界循环。
保存可复现的故障现场
下面的脚本用于“恢复动作已经失败”之后。它不会再次执行 restart,而是把证据写入独立目录。运行环境需要使用 systemd,并且当前用户应有读取目标服务状态和日志的权限。
#!/usr/bin/env bash
set -u

SERVICE=${1:-}
REPORT_DIR=${REPORT_DIR:-/tmp/service-recovery-report}

if [[ -z "$SERVICE" ]]; then
  echo "usage: $0 <service-name>" >&2
  exit 2
fi

mkdir -p "$REPORT_DIR"

# 失败后只采集证据,不再执行 restart、reload 等修改性操作。
systemctl status "$SERVICE" --no-pager >"$REPORT_DIR/status.txt" 2>&1 || true
journalctl -u "$SERVICE" -n 100 --no-pager >"$REPORT_DIR/journal.txt" 2>&1 || true

if systemctl is-active --quiet "$SERVICE"; then
  printf 'service=%s\ncheck=active\n' "$SERVICE" >"$REPORT_DIR/check.txt"
else
  printf 'service=%s\ncheck=inactive\n' "$SERVICE" >"$REPORT_DIR/check.txt"
fi

echo "recovery failed; evidence saved to $REPORT_DIR" >&2
exit 1
例如保存为 <PATH>/capture-failure.sh 后执行:
bash <PATH>/capture-failure.sh nginx
echo "exit_code=$?"
预期输出:
recovery failed; evidence saved to /tmp/service-recovery-report
exit_code=1实际服务名和报告路径可能不同。status.txt、journal.txt 与 check.txt 的具体内容取决于故障现场,因此不应在脚本中预设固定日志文本。
为什么要保留非零退出码
脚本最后的 exit 1 不只是表示“执行过错误”,它还是无人值守任务向外部系统传递失败结果的接口。Cron、CI、监控代理或包装脚本都可以据此触发告警,而不是把“证据采集成功”误判成“服务恢复成功”。
同时要区分采集命令失败和恢复失败。示例对 systemctl status、journalctl 使用 || true,是为了尽可能继续收集其他证据;最终退出码仍由服务恢复结果决定。
交给人工前检查什么
故障目录至少应回答三个问题:服务现在是什么状态、故障前后出现了哪些日志、最后一次健康检测是什么结果。如果还需要主机资源、端口监听或依赖连接信息,可以在同一证据采集阶段追加只读命令,但不要顺手删除文件、修改配置或再次重启服务。
当恢复失败后能够稳定留下证据并以非零状态退出,自动化脚本的职责就已经完成:它既没有掩盖故障,也没有通过失控重试继续改变现场。