
命令行与文本处理 / 系统课时
服务异常后可以自动重启吗
服务异常后可以自动重启吗
服务异常后自动执行 systemctl restart 可以缩短恢复时间,但前提是故障条件足够明确,并且必须限制一定时间内的重启次数。否则配置错误、依赖不可用等持续故障可能让服务陷入“失败—重启—再次失败”的无限循环。
学习目标
- 设计“检测失败后再重启”的受控恢复流程
- 使用时间窗口和次数上限阻止无限重启
- 在重启后再次验证服务状态,并为人工介入保留明确结果
自动重启需要哪些保护
可靠的恢复脚本不能只写一句 systemctl restart。执行恢复前至少需要确认当前服务确实不健康,恢复后还要重新验证,并记录本时间窗口已经尝试了多少次。
一个实用的决策顺序是:先检查服务状态;健康则立即结束;异常则读取重启计数;达到上限后停止自动操作;尚未达到上限才执行重启;最后再次检查状态。这样故障不会因为脚本不断重试而被掩盖。
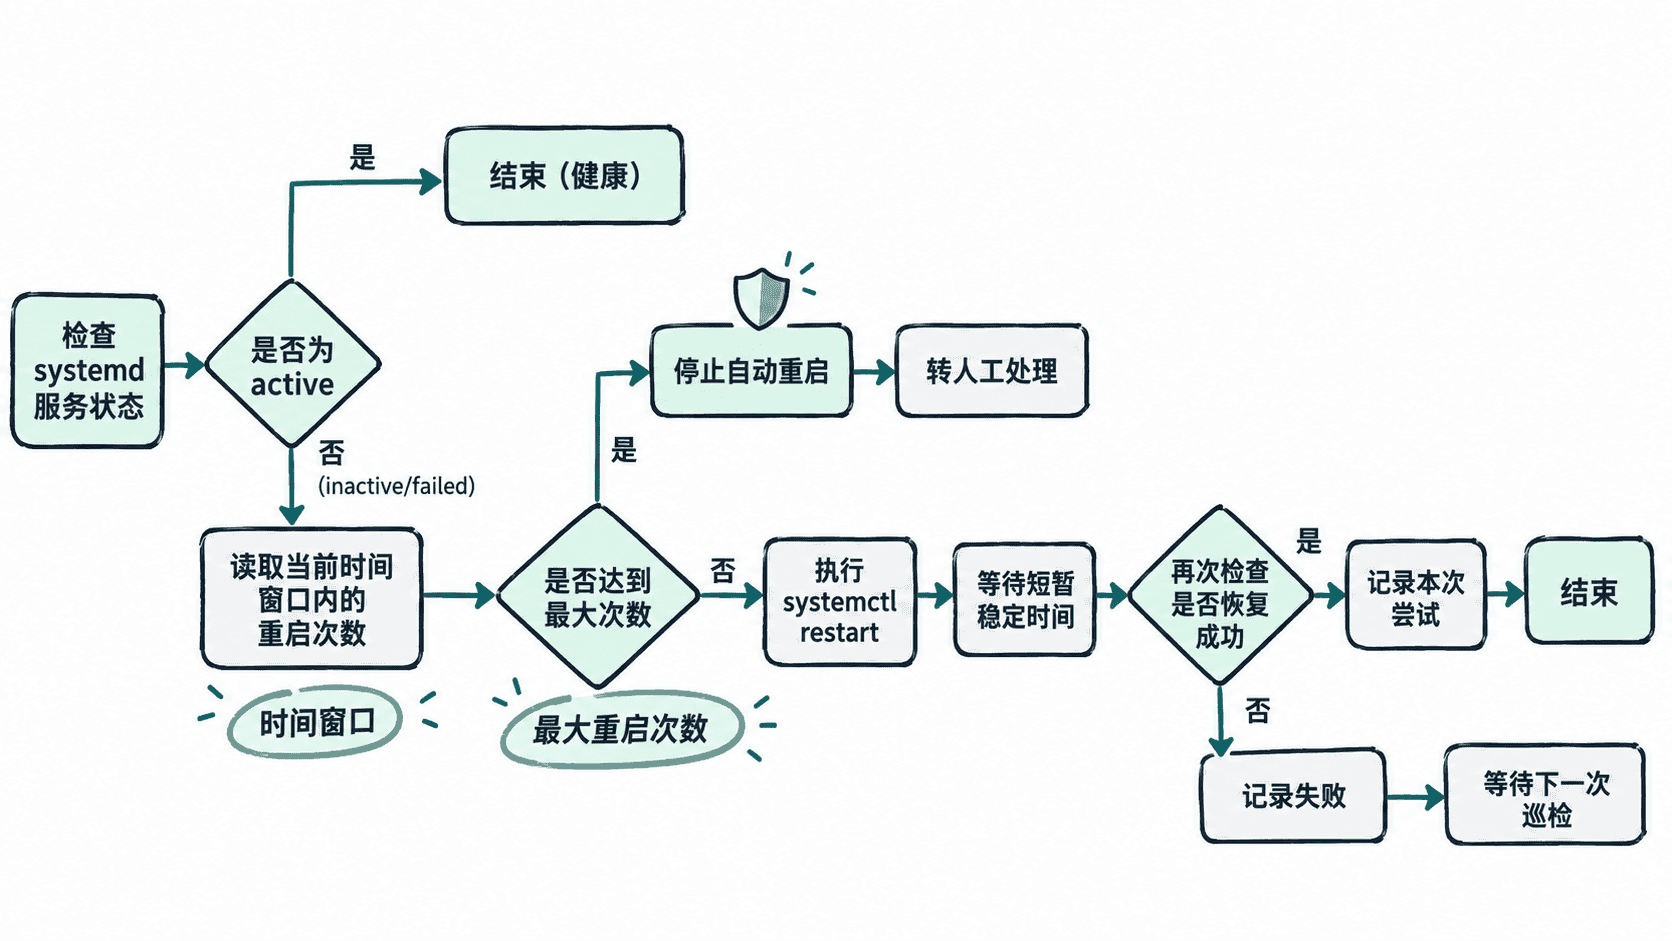
实现带次数上限的恢复脚本
下面的脚本以 systemd 服务为对象,在 10 分钟窗口内最多尝试重启 3 次。状态文件保存在 /run/service-watchdog;因为需要操作 systemd 和写入该目录,脚本应由 root 或具备等效权限的执行环境运行。
#!/usr/bin/env bash
set -u

service="${1:?usage: $0 <systemd-service>}"
max_restarts=3
window_seconds=600
verify_delay=2
state_dir="/run/service-watchdog"
state_file="$state_dir/${service}.state"

if (( EUID != 0 )); then
  echo "error: must run as root"
  exit 3
fi

mkdir -p "$state_dir"

if systemctl is-active --quiet "$service"; then
  rm -f "$state_file"
  echo "healthy service=$service"
  exit 0
fi

now="$(date +%s)"
window_start="$now"
count=0

if [[ -r "$state_file" ]]; then
  read -r saved_start saved_count < "$state_file" || true
  if [[ "${saved_start:-}" =~ ^[0-9]+$ && "${saved_count:-}" =~ ^[0-9]+$ ]]; then
    window_start="$saved_start"
    count="$saved_count"
  fi
fi

if (( now - window_start >= window_seconds )); then
  window_start="$now"
  count=0
fi

if (( count >= max_restarts )); then
  echo "restart_suppressed service=$service attempts=$count/$max_restarts"
  exit 1
fi

count=$((count + 1))
printf '%s %s\n' "$window_start" "$count" > "$state_file"

if ! systemctl restart "$service"; then
  echo "restart_failed service=$service attempt=$count/$max_restarts"
  exit 1
fi

sleep "$verify_delay"

if systemctl is-active --quiet "$service"; then
  echo "restart_ok service=$service attempt=$count/$max_restarts"
  exit 0
fi

echo "restart_failed service=$service attempt=$count/$max_restarts"
exit 1
预期输出
例如目标服务为 nginx,第一次恢复成功时:
restart_ok service=nginx attempt=1/3如果同一 10 分钟窗口已经完成 3 次自动重启,下一次巡检不会继续执行重启,而是输出:
restart_suppressed service=nginx attempts=3/3服务原本就处于 active 状态时输出:
healthy service=nginx为什么重启成功后还要验证
systemctl restart 命令返回成功,只能说明 systemd 接受并完成了这次启动操作,不代表应用已经能够正常提供业务。如果进程启动后立即退出,或者应用虽然 active 但 HTTP 接口不可用,单看重启命令的退出码会产生错误结论。
本例重新使用 systemctl is-active 做最低限度验证。对于 Web 服务,更稳妥的做法是在重启后调用真实健康检查 URL:只有进程状态和 HTTP 检查都通过,才把恢复判定为成功。检测逻辑与恢复逻辑应保持清晰边界,便于后续增加更严格的验证条件。
次数上限解决什么问题
限制重启次数并不是为了减少恢复能力,而是为了在持续故障时及时停止破坏性动作。例如配置文件语法错误、数据库长期不可达、磁盘已满时,重复重启通常无法修复根因,还可能持续制造日志、连接请求和资源抖动。
时间窗口则让限制能够自动恢复。本例中的“10 分钟最多 3 次”表示旧的失败记录在窗口结束后会重新计数,而不是服务一生只能自动重启 3 次。生产环境应根据故障恢复速度、启动耗时和告警响应时间确定窗口与上限。
什么时候应该停止自动处理
达到重启上限后,脚本应把结果交给告警系统或人工处置,而不是改用更激进的命令继续尝试。如果多个服务存在依赖关系,还应先确认依赖服务、磁盘、端口、配置和外部资源是否正常,再决定恢复顺序。
自动恢复真正需要保证的是“有限、可验证、可停止”。只要恢复次数有边界、每次操作后都重新检查,并在持续失败时明确退出,就能避免巡检脚本从故障处理工具变成新的故障来源。