
游戏 AI / 系统课时
NPC 综合场景如何验收决策链
NPC 综合场景如何验收决策链
综合验收不是再看某一个评分公式,而是把多敌人、队友受伤、任务目标、遮挡和目标死亡放进同一条时间线,观察候选收集、过滤、评分、切换与行为消费是否连续一致。本篇给出一个最小可执行验收场景和逐步检查方法。
学习目标
- 构造能覆盖多种动态变化的决策验收场景。
- 用时间线记录输入变化、候选状态和最终目标,定位链路断点。
- 通过自动断言验证关键场景下的目标选择结果。
先把验收场景设计成连续事件
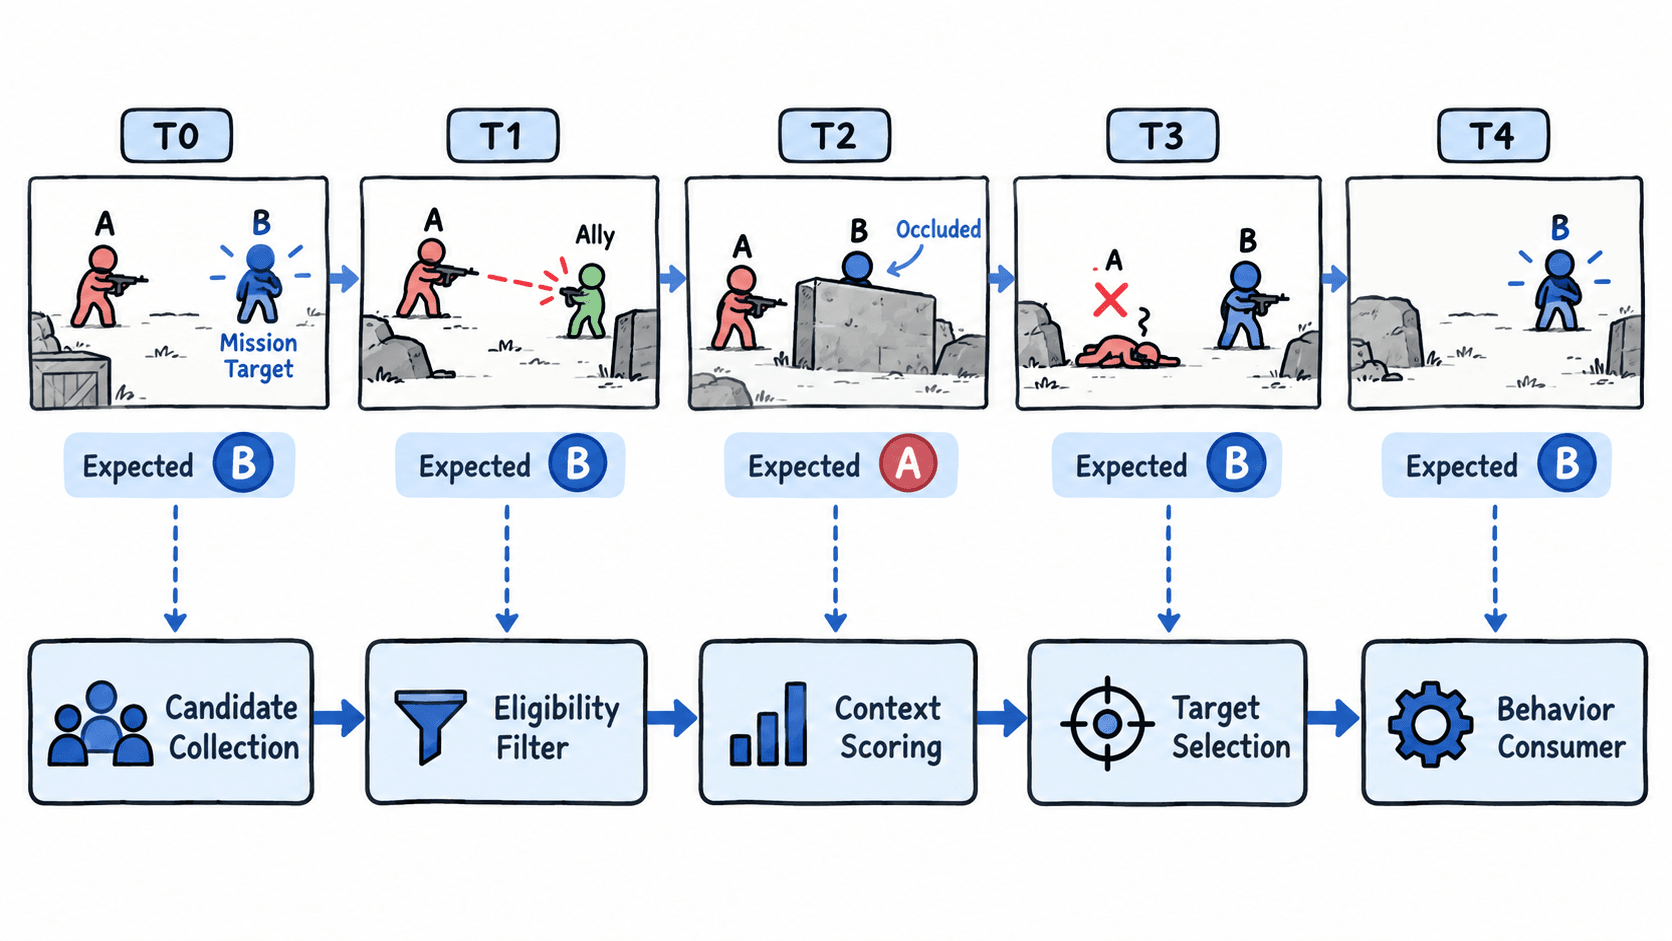
一个有效场景应让同一批候选在几次评估中连续变化,而不是为每个规则单独开一个测试。可以安排两个敌人 A、B,其中 B 是任务目标;随后让 A 伤害队友、B 被遮挡、A 死亡,最后 B 再次可见。
这样一次运行就能覆盖任务加权、威胁变化、遮挡修正、死亡过滤和重新选择。每个评估点都应记录“输入发生了什么”和“为什么选这个目标”,否则只能看到结果,无法判断是过滤层、评分层还是行为层出了问题。
用一个小型模型跑完整链路
下面的 Python 示例把规则压缩成可检查的最小模型:死亡目标直接过滤;任务目标加 30 分;队友被攻击时对应敌人威胁提高;遮挡不是硬过滤,而是扣 20 分。它不是某个引擎的 API,而是用于验证决策链顺序的独立测试模型。
MISSION_BONUS = 30
OCCLUDED_PENALTY = 20

def choose_target(candidates, mission_target):
    scored = []

    for item in candidates:
        if not item["alive"] or not item["attackable"]:
            continue

        score = item["threat"]
        if item["id"] == mission_target:
            score += MISSION_BONUS
        if not item["visible"]:
            score -= OCCLUDED_PENALTY

        scored.append((score, item["id"]))

    if not scored:
        return None

    scored.sort(key=lambda pair: (-pair[0], pair[1]))
    return scored[0][1]

frames = [
    ("T0", 40, 50, True, True, True, "B"),
    ("T1", 75, 50, True, True, True, "B"),
    ("T2", 75, 50, True, False, True, "A"),
    ("T3", 75, 50, False, False, True, "B"),
    ("T4", 75, 50, False, True, True, "B"),
]

for name, threat_a, threat_b, alive_a, visible_b, attackable_b, expected in frames:
    candidates = [
        {"id": "A", "threat": threat_a, "alive": alive_a, "attackable": True, "visible": True},
        {"id": "B", "threat": threat_b, "alive": True, "attackable": attackable_b, "visible": visible_b},
    ]

    actual = choose_target(candidates, mission_target="B")
    print(f"{name}: expected={expected} actual={actual}")
    assert actual == expected
预期输出:
T0: expected=B actual=B
T1: expected=B actual=B
T2: expected=A actual=A
T3: expected=B actual=B
T4: expected=B actual=B
这个模型故意保持简单,重点不是调出“最好玩的数值”,而是保证每个输入变化都能对应到明确的决策结果。真实系统还可以把切换阈值、最短锁定时间、强制目标等规则接入,但验收记录仍应保持同样的可解释性。
按层检查,而不是只看最终目标
当实际结果与预期不一致时,应沿决策链从前往后检查。先确认候选是否存在,再确认死亡、阵营和可攻击状态是否正确过滤,然后核对任务加成、威胁和遮挡修正,最后确认选择结果有没有被状态机或行为层覆盖。
尤其要区分“决策已经选对,但行为没有执行”和“决策本身选错”。前者应查行为命令适配、状态转换和目标消费;后者才回到候选、过滤和评分。把这两个问题混在一起,会导致不断改评分参数却修不好真正的执行错误。
验收通过要满足什么
综合场景至少应做到三件事:同一输入可以重复得到同一结果;每次切换都能给出可追踪原因;目标死亡或失效后不会继续被行为层消费。若系统支持日志,建议记录评估时刻、候选 ID、过滤原因、分项得分、最终目标和切换原因。
测试通过后,再把候选数量、刷新频率、遮挡变化速度和紧急事件密度逐步提高。只要动态场景下仍能维持“输入可解释、选择可复现、行为可验证”,这条决策链才算完成真正的综合验收。