
游戏 AI / 系统课时
NPC 群体同时选目标会怎样
NPC 群体同时选目标会怎样
当几十甚至几百个 NPC 在同一帧同时做感知、过滤和评分时,单个 NPC 看似很轻的决策会叠加成明显尖峰。本篇用可复现的小例子拆解“集中刷新”问题,并给出刷新错峰、共享查询结果与验收指标的组合方案。
学习目标
- 识别群体 NPC 同帧决策产生计算尖峰的原因。
- 设计固定频率错峰刷新,避免所有 NPC 同时进入昂贵评分阶段。
- 区分可以共享的数据与必须保留在单个 NPC 内的决策状态。
为什么集中刷新会形成尖峰
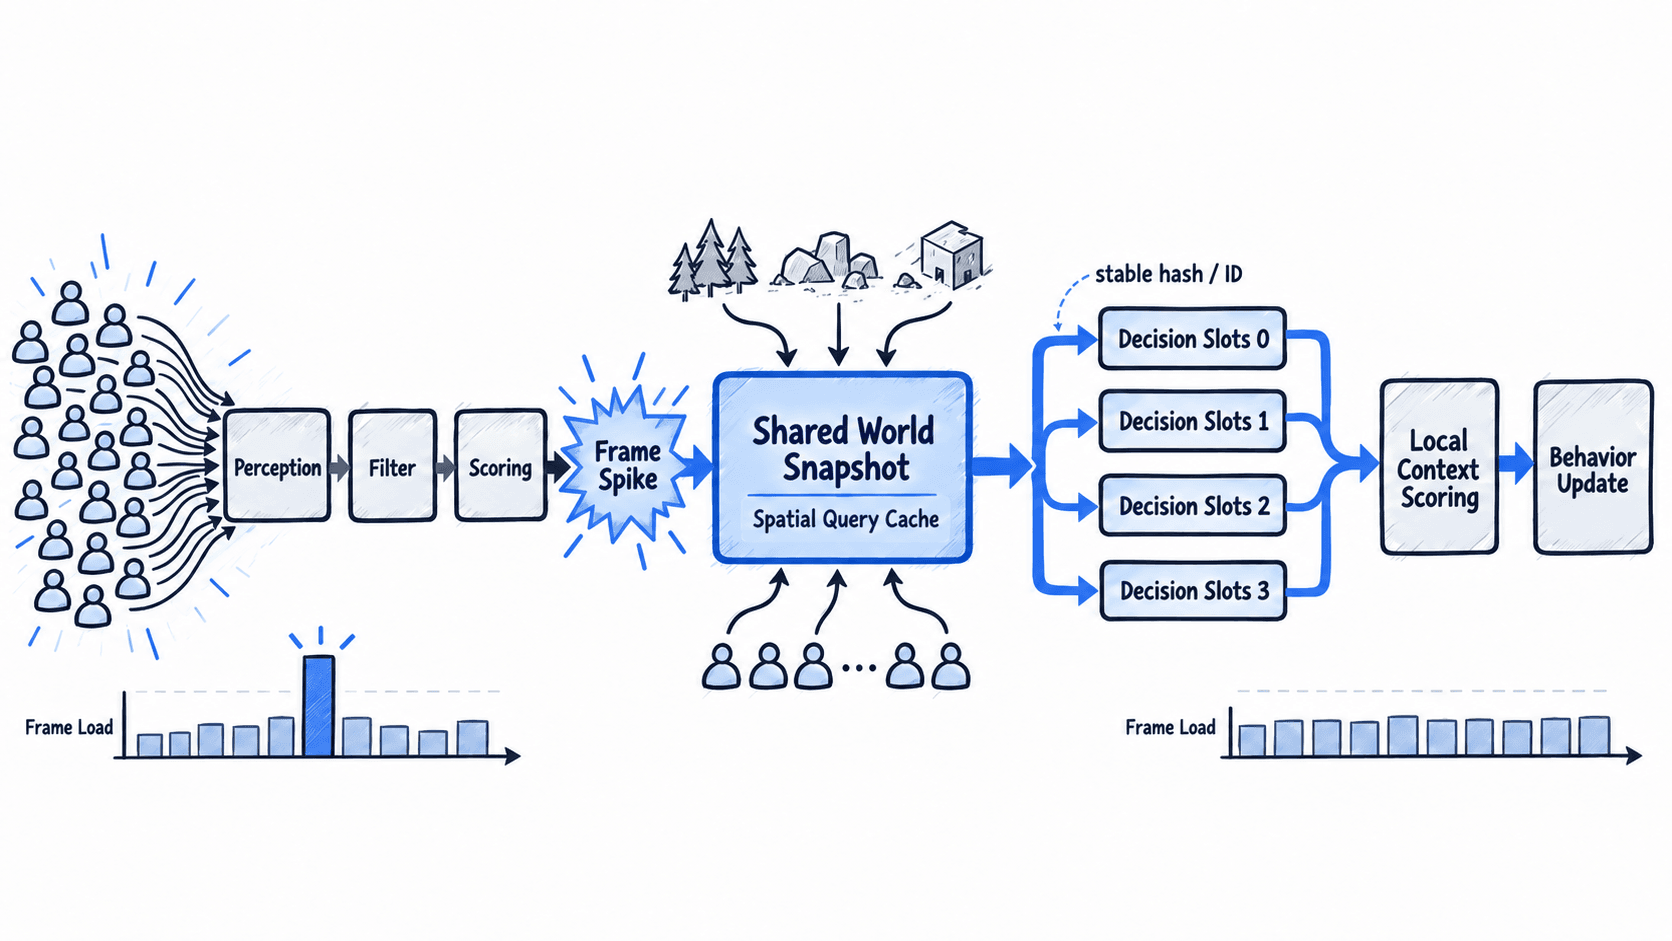
如果 100 个 NPC 都按“每 200 ms 刷新一次”执行,但它们在同一时刻创建,那么计时器往往会保持同步。结果不是每帧分摊约 5 个 NPC,而是某一帧几乎 100 个 NPC 一起完成空间查询、候选过滤、视线检测和评分。
真正昂贵的通常不是一次加减法,而是查询候选、路径或视线判断,以及大量临时对象和容器操作。优化目标因此不是简单“降低刷新频率”,而是让工作量在时间上更均匀。
用稳定分桶把刷新错开
最简单的做法是把 NPC 按稳定 ID 分到若干刷新槽位,每帧只处理其中一个槽位。下面用可运行的 Python 模拟 12 个 NPC 分成 4 组,连续 8 帧轮流刷新。
NPC_COUNT = 12
SLOTS = 4

groups = {slot: [] for slot in range(SLOTS)}

for npc_id in range(NPC_COUNT):
    slot = npc_id % SLOTS
    groups[slot].append(f"NPC-{npc_id:02d}")

for frame in range(8):
    active_slot = frame % SLOTS
    names = ",".join(groups[active_slot])
    print(f"frame={frame} slot={active_slot} refresh={names}")
预期输出:
frame=0 slot=0 refresh=NPC-00,NPC-04,NPC-08
frame=1 slot=1 refresh=NPC-01,NPC-05,NPC-09
frame=2 slot=2 refresh=NPC-02,NPC-06,NPC-10
frame=3 slot=3 refresh=NPC-03,NPC-07,NPC-11
frame=4 slot=0 refresh=NPC-00,NPC-04,NPC-08
frame=5 slot=1 refresh=NPC-01,NPC-05,NPC-09
frame=6 slot=2 refresh=NPC-02,NPC-06,NPC-10
frame=7 slot=3 refresh=NPC-03,NPC-07,NPC-11
实际项目可以把“每帧一个槽位”替换为“固定时间片一个槽位”,但要保持两个原则:分桶依据稳定,且不要让所有 NPC 因场景加载、复活或战斗开始重新对齐到同一时刻。
哪些数据适合共享
群体优化常见的第二步是减少重复查询。空间分区查询、当前帧的敌对单位快照、静态阵营关系等,通常可以在同一世界区域内共享;但当前目标、切换冷却、任务上下文和最近受击者属于个体状态,不能因为共享查询就合并。
可以把链路拆成两层:共享层负责“世界里可能有哪些候选”,个体层负责“这个 NPC 此刻该不该选它”。这样既减少重复工作,也不会把不同 NPC 的战术意图错误地同步。
怎么确认优化真的有效
验收时不要只看平均帧率,而要记录决策阶段每帧耗时、单帧进入决策的 NPC 数量、空间查询次数和昂贵检查次数。优化前后应重点观察尖峰是否被摊平,而不是只看总计算量是否略有下降。
当群体规模增加时,如果“同帧刷新 NPC 数量”仍接近总数,说明错峰没有生效;如果共享查询次数仍与 NPC 数量近似线性增长,说明公共数据还没有真正被复用。最终目标是让负载随时间稳定分布,同时保留紧急事件触发的即时决策通道,避免为了性能把受击、目标死亡等关键响应也延迟掉。