
游戏 AI / 系统课时
NPC 行为变化会怎样反过来影响选择
NPC 行为变化会怎样反过来影响选择
目标选择不是一次性计算。NPC 开始移动、开火、受伤或进入冷却后,自身运行时状态已经变化,下一轮决策就应该使用新的状态快照。关键是把这些变化作为输入反馈给决策层,而不是让行为状态机直接改写目标。
学习目标
- 把冷却、生命值、受伤和弹药等行为状态纳入下一轮决策
- 区分瞬时事件与可持续状态,避免重复加权
- 用状态快照建立可测试的决策反馈回路
行为执行会改变下一轮决策条件
例如 NPC 当前选择近处敌人并开火,随后弹药降为 0;或者追击过程中自身生命值跌到 15%。如果决策层仍使用旧快照,它可能继续输出 ATTACK,即使 NPC 已经无法射击或应该优先撤退。
因此每轮决策前都应该读取一份新的 RuntimeSnapshot。它描述“此刻 NPC 能做什么、承受了什么”,而不是保存“应该选谁”的结论。目标仍然由评分、优先级和硬规则计算得出。
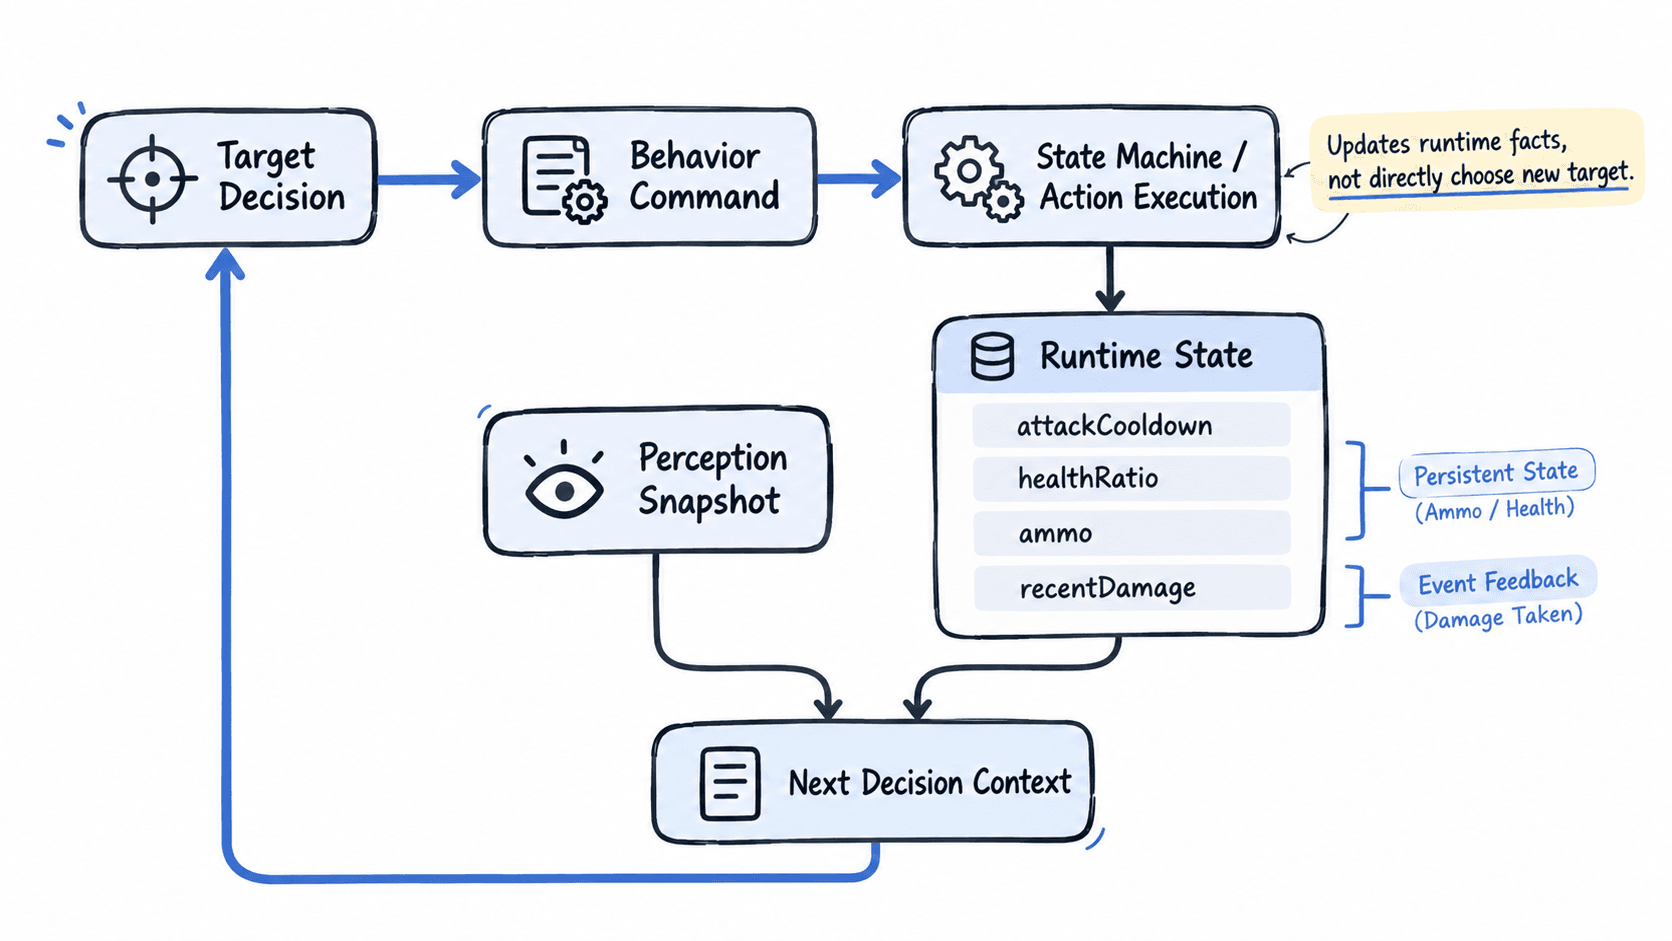
下面的可运行示例用同一组候选演示:有弹药且生命值健康时选择攻击高威胁目标;弹药耗尽或生命值过低后,新的运行时快照让意图发生变化。
import java.util.List;

public class RuntimeFeedbackDemo {

    record RuntimeSnapshot(
            double healthRatio,
            int ammo,
            long attackCooldownMs,
            double recentDamage
    ) {}

    record Candidate(String id, double threat, double distance) {}

    record Decision(String targetId, String intent) {}

    static Decision decide(RuntimeSnapshot runtime, List<Candidate> candidates) {
        if (runtime.healthRatio() < 0.20) {
            return new Decision(null, "RETREAT");
        }
        if (runtime.ammo() <= 0) {
            return new Decision(null, "RELOAD");
        }
        if (runtime.attackCooldownMs() > 0) {
            return new Decision(null, "HOLD");
        }

        Candidate best = candidates.stream()
                .max((a, b) -> Double.compare(
                        score(a, runtime),
                        score(b, runtime)
                ))
                .orElse(null);

        return best == null
                ? new Decision(null, "IDLE")
                : new Decision(best.id(), "ATTACK");
    }

    static double score(Candidate candidate, RuntimeSnapshot runtime) {
        double distancePenalty = candidate.distance() * 2.0;
        double pressureBonus = runtime.recentDamage() * 0.1;
        return candidate.threat() - distancePenalty + pressureBonus;
    }

    public static void main(String[] args) {
        List<Candidate> candidates = List.of(
                new Candidate("enemy-a", 80, 8),
                new Candidate("enemy-b", 60, 2)
        );

        System.out.println(decide(
                new RuntimeSnapshot(0.80, 10, 0, 20),
                candidates
        ));
        System.out.println(decide(
                new RuntimeSnapshot(0.80, 0, 0, 20),
                candidates
        ));
        System.out.println(decide(
                new RuntimeSnapshot(0.15, 10, 0, 20),
                candidates
        ));
    }
}
预期输出:
Decision[targetId=enemy-a, intent=ATTACK]
Decision[targetId=null, intent=RELOAD]
Decision[targetId=null, intent=RETREAT]
示例故意把规则写得简单:重点不是这组权重本身,而是说明运行时事实必须在下一轮被重新读取。生产系统通常还会把“是否有掩体”“技能资源”“移动状态”等加入快照,但原则不变。
瞬时事件和持续状态不要混为一谈
healthRatio、ammo、attackCooldownMs 属于持续状态,可以在每轮决策直接读取。recentDamage 则更接近时间窗口事件:它应该随时间衰减或在窗口结束后清零,否则一次受伤会永久影响后续评分。
受伤事件还可能同时产生两种效果:一是更新生命值,这是持续事实;二是提高攻击者的短期威胁,这是事件驱动的修正。二者如果都被当成永久加分,就会造成“受过一次伤后永远追着同一个人”的异常。
反馈回路必须有单向职责
推荐的数据流是:行为系统更新事实,状态采集器形成快照,决策系统读取快照并生成新命令,状态机再执行新命令。任何模块都可以报告事实,但只有决策层负责把这些事实转成目标和意图。
这样可以避免两个常见问题。第一,攻击状态因为“没子弹”直接把目标改成补给点,而决策日志完全不知道为什么切换;第二,决策层仍认为当前目标有效,状态机却已经私自进入撤退,导致上层和执行层状态不一致。
当行为变化确实需要立即重算时,可以发出事件触发提前决策,例如低血量越过阈值、弹药变为 0、受到高额伤害。触发只代表“现在重新算一次”,并不代表事件发送者拥有选择结果。
用快照让反馈逻辑可测试
把所有本轮需要的运行时数据收进不可变快照,还有一个工程收益:可以直接保存输入并重放。线上出现“NPC 明明残血却继续追击”时,只要拿到当时的候选集和 RuntimeSnapshot,就能在测试环境复现决策,而不必重建整场战斗。
快照也应该带有明确采样时机。最稳妥的做法是在一次决策开始时读取完整状态,然后整个评估过程只使用这份快照,避免评分到一半时弹药、血量或冷却又被其他线程修改。下一轮再读取新值,就能兼顾一致性和实时性。
最终应形成一个清晰闭环:行为改变运行时事实,事实进入下一轮决策,但行为层不直接决定目标。这个边界一旦守住,冷却、低血量、受伤、弹药乃至任务阶段都可以继续扩展,而不会把状态机和目标选择重新耦合在一起。