
游戏 AI / 系统课时
NPC 选中的目标怎样交给状态机
NPC 选中的目标怎样交给状态机
目标选择完成后,最容易出现的架构问题是状态机再次计算距离、威胁或优先级,结果让“决策层选 A、行为层却追 B”。这一课把决策结果收敛成稳定输出接口,让状态机只负责执行,不重复做目标选择。
学习目标
- 定义决策系统到行为状态机之间的最小输出契约
- 区分“选谁”和“怎么做”,避免状态机重复评分
- 处理目标失效、无需目标和强制行为等边界
决策结果应该是一份命令,而不是半成品
决策层的职责是根据候选、上下文和规则得出“当前应该围绕谁做什么”。状态机的职责则是把这个意图转换成移动、攻击、施法或待机状态。两层之间最好传递不可变的决策结果,而不是把候选列表或评分器直接暴露给状态机。
一个实用的最小输出可以包含 targetId、intent 和少量执行上下文。targetId 表示已经选定的对象;intent 表示本轮希望进入的行为方向;执行上下文只携带状态机真正需要的参数,例如期望攻击距离,而不是整份评分明细。
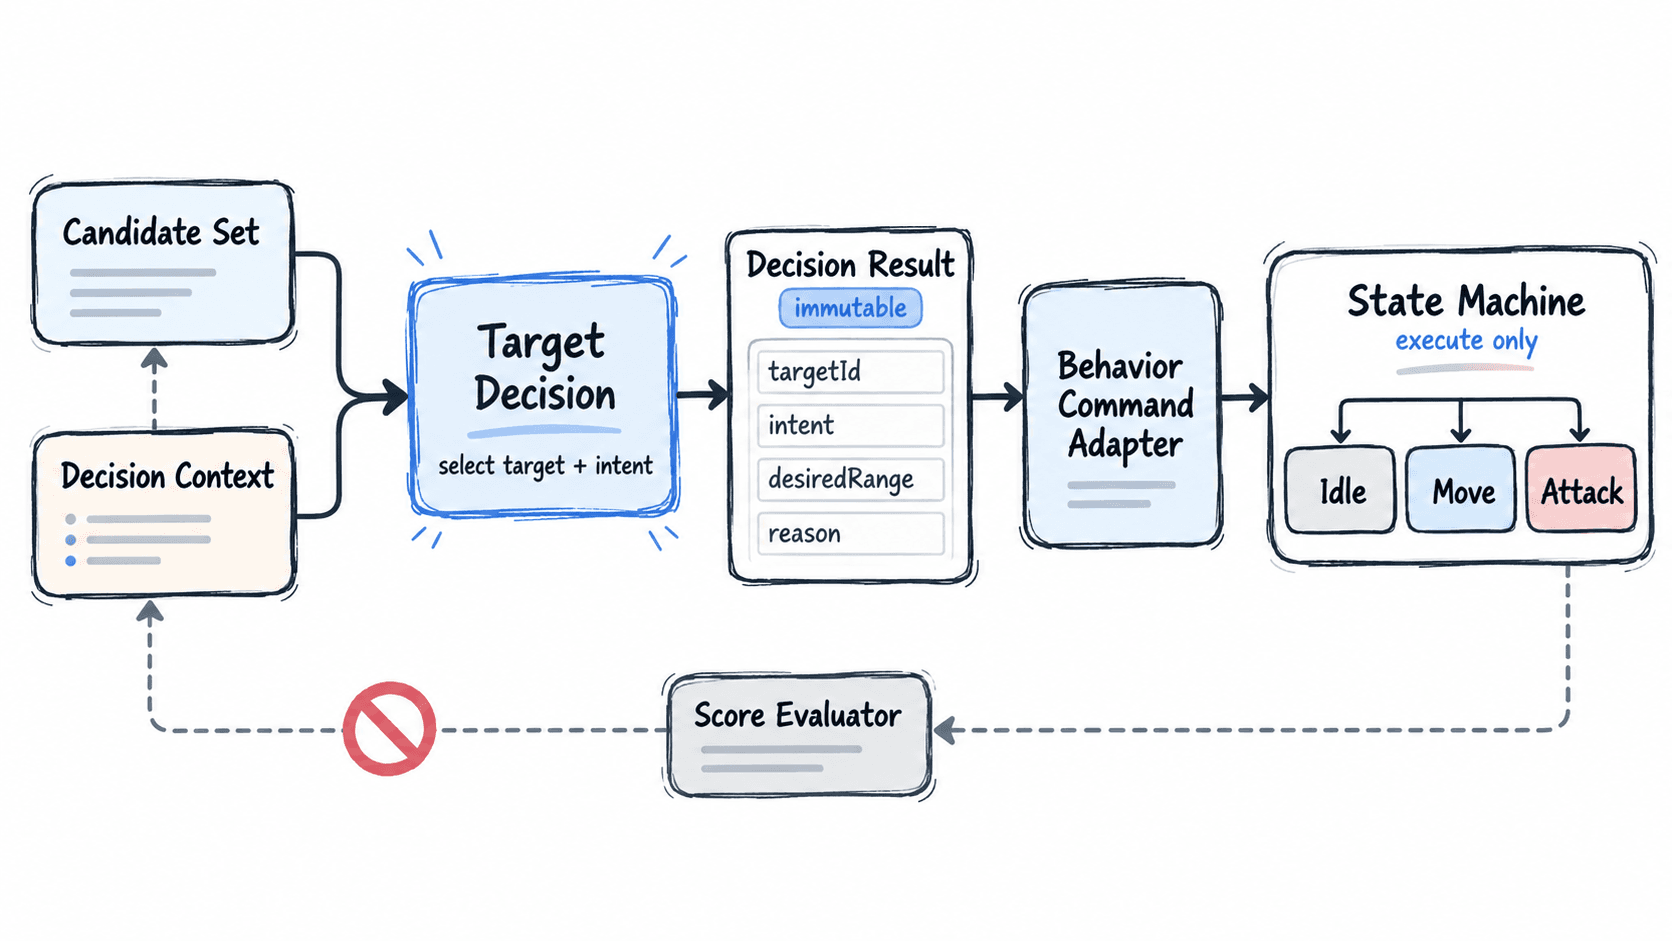
可以把接口收敛成下面这样。示例用一个适配器把决策结果转换为状态机命令,状态机只根据命令切换状态。
import java.util.Objects;

public class DecisionToStateMachineDemo {

    enum Intent {
        IDLE, APPROACH, ATTACK
    }

    record DecisionResult(String targetId, Intent intent, double desiredRange, String reason) {
        DecisionResult {
            if (intent != Intent.IDLE) {
                Objects.requireNonNull(targetId, "non-idle decision requires targetId");
            }
        }
    }

    record BehaviorCommand(String targetId, Intent intent, double desiredRange) {}

    static BehaviorCommand toCommand(DecisionResult result) {
        return new BehaviorCommand(
                result.targetId(),
                result.intent(),
                result.desiredRange()
        );
    }

    static String nextState(BehaviorCommand command) {
        return switch (command.intent()) {
            case IDLE -> "IdleState";
            case APPROACH -> "MoveToTargetState";
            case ATTACK -> "AttackTargetState";
        };
    }

    public static void main(String[] args) {
        DecisionResult result = new DecisionResult(
                "enemy-42",
                Intent.ATTACK,
                2.5,
                "highest stable score"
        );

        BehaviorCommand command = toCommand(result);
        System.out.println(command);
        System.out.println("nextState=" + nextState(command));
    }
}
预期输出:
BehaviorCommand[targetId=enemy-42, intent=ATTACK, desiredRange=2.5]
nextState=AttackTargetState
这里的 reason 可以保留在决策结果中用于日志和调试,但没有必要传给状态机。这样既能解释“为什么选它”,又不会让执行层依赖决策内部细节。
状态机只执行,不重新决定目标
状态机拿到 ATTACK + enemy-42 后,可以检查动画是否结束、技能是否进入前摇、角色是否已经到达攻击距离,但不应该重新遍历附近敌人并比较威胁值。否则同一帧会出现两套决策源,问题通常表现为目标跳变、状态反复切换或日志无法解释。
职责可以简单划分为:决策层回答“谁最合适、当前意图是什么”;行为层回答“为了完成这个意图,现在该进入哪个状态、状态内下一步动作是什么”。距离是否足够攻击如果属于行为执行条件,可以在状态内判断;但“因为另一个敌人更近,所以改打它”仍然属于决策层。
目标失效要回到决策入口
真实运行中,目标可能死亡、离场、不可达,或者因为任务规则变化而不再合法。状态机发现这些事实后,应产生明确事件,例如 TARGET_INVALID、PATH_FAILED 或 ATTACK_BLOCKED,再由决策系统重新收集候选并输出新结果。
这条反馈路径很重要:状态机可以发现执行层事实,却不拥有目标选择权。这样“发现问题”和“决定换谁”仍然由不同模块负责,线上排查时也能沿事件链找到真正的切换原因。
如果当前决策是 IDLE,则 targetId 可以为空;如果是强制脚本目标,也仍然通过同一个 DecisionResult 输出,只需要让决策层在生成结果前完成优先级覆盖。统一出口比给状态机增加多套特殊入口更容易维护。
接口稳定后再扩展行为上下文
后续需要加入攻击姿态、技能偏好、移动容差时,优先增加状态机执行确实需要的字段,并保持这些字段是“决策结果”,而不是“让状态机继续算”的原始素材。候选表、评分权重、威胁明细和任务优先级都应该留在决策系统内部。
判断接口是否干净有一个简单标准:只看 BehaviorCommand,状态机就能开始执行;只看决策日志,又能解释为什么生成这条命令。两边不需要共享评分器,也不需要各自维护一套目标选择规则。