
游戏 AI / 系统课时
NPC 如何打印每次选择依据
NPC 如何打印每次选择依据
NPC 选错目标时,仅打印“最终选了谁”几乎无法定位问题。本课把一次决策拆成可复盘的证据链:输入了哪些候选、谁被过滤、各自得分和优先级是多少、平局如何处理,最后为什么得到当前目标。
学习目标
- 能为一次目标选择设计完整且可关联的调试记录。
- 能区分过滤原因、评分明细、优先级与最终结果。
- 能控制日志粒度,避免为了排错把运行时日志打成噪声。
一次决策必须有同一个追踪标识
调试日志最怕每个阶段各打一行,却无法确认它们是否属于同一次决策。应在进入目标评估时生成或取得 decisionId,并把它贯穿候选快照、过滤、评分、排序和最终结果。
记录内容至少覆盖五类事实:候选标识、是否通过硬过滤、失败原因、评分与优先级、最终动作。若发生“保持当前目标”,还要明确记录是因为锁定时间、切换阈值还是挑战者确实分数不足。
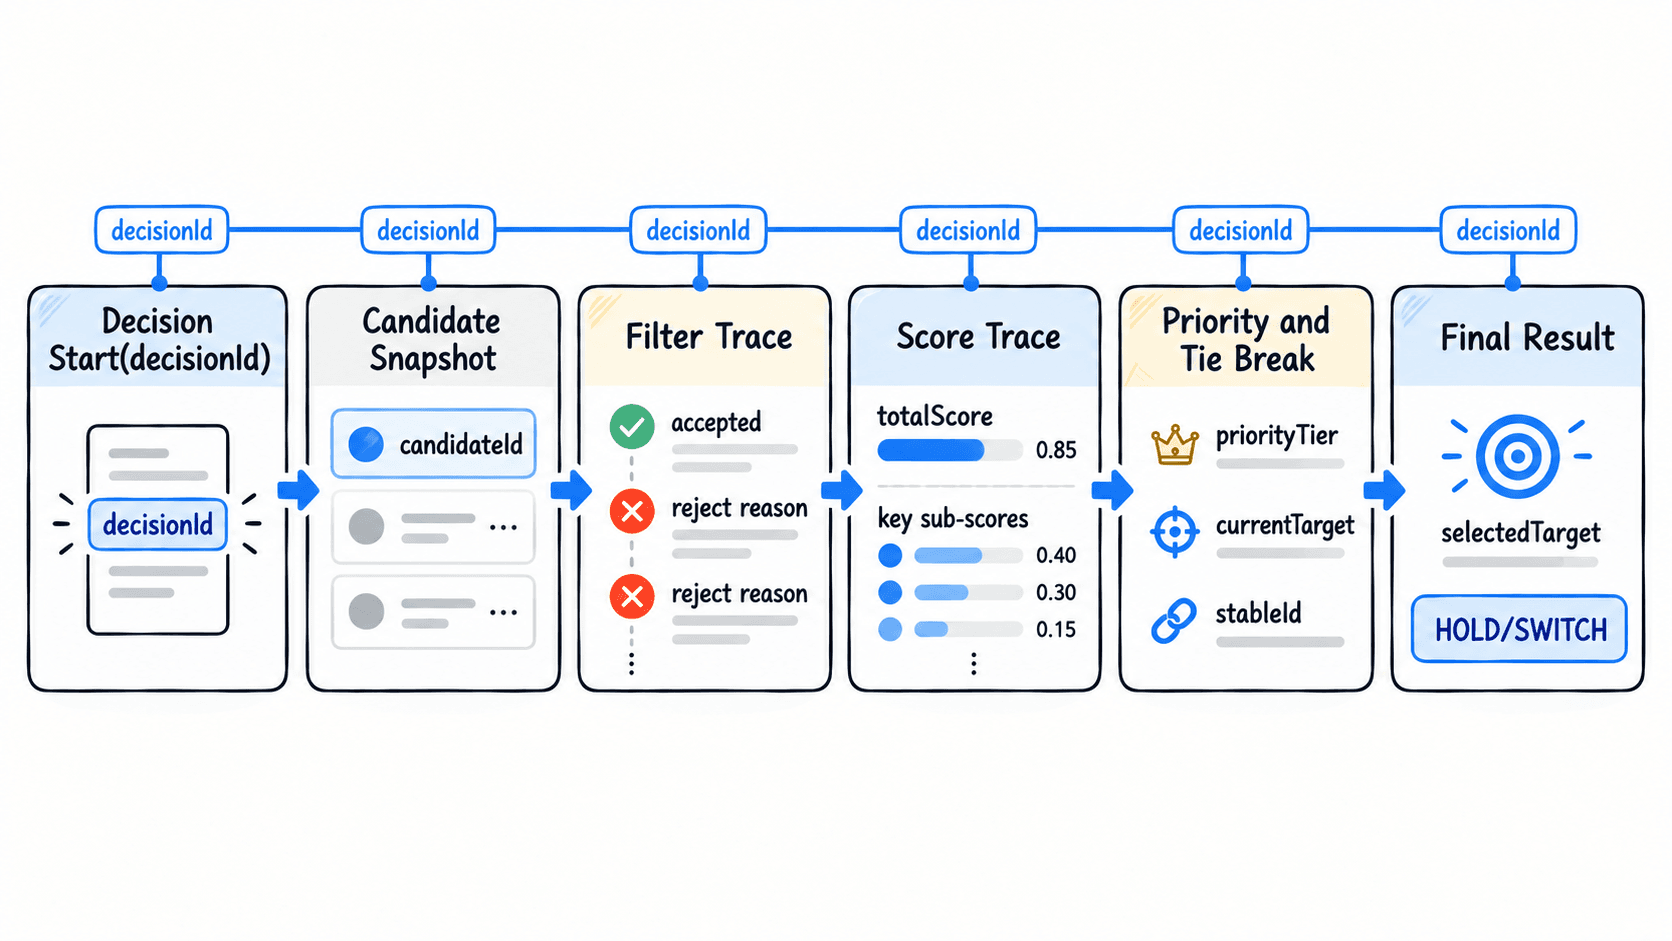
日志结构最好围绕“事实”而不是自然语言长句。字段稳定后,既方便肉眼检索,也方便后续送入日志平台聚合。
打印候选、过滤和评分明细
下面示例使用 Java 17,把三个候选经过硬过滤和评分后输出。为了让示例可直接运行,日志使用标准输出;真实项目可替换成已有日志框架,但字段含义应保持一致。
import java.util.ArrayList;
import java.util.Comparator;
import java.util.List;

public class DecisionTraceDemo {
    record Candidate(
            String id,
            boolean alive,
            boolean hostile,
            int priority,
            double threat,
            double distance) {}

    record Ranked(Candidate candidate, double score) {}

    public static void main(String[] args) {
        String decisionId = "decision-120";
        List<Candidate> candidates = List.of(
                new Candidate("enemy-a", true, true, 1, 0.70, 8.0),
                new Candidate("enemy-b", true, true, 2, 0.55, 3.0),
                new Candidate("enemy-c", false, true, 3, 0.95, 2.0));

        List<Ranked> ranked = new ArrayList<>();

        System.out.println("decision.start id=" + decisionId
                + " candidateCount=" + candidates.size());

        for (Candidate c : candidates) {
            if (!c.alive()) {
                System.out.println("candidate.reject decisionId=" + decisionId
                        + " candidate=" + c.id() + " reason=DEAD");
                continue;
            }
            if (!c.hostile()) {
                System.out.println("candidate.reject decisionId=" + decisionId
                        + " candidate=" + c.id() + " reason=NOT_HOSTILE");
                continue;
            }

            // 分数只表达软偏好;priority 作为更高层级的排序条件。
            double score = c.threat() * 100.0 - c.distance() * 2.0;
            ranked.add(new Ranked(c, score));
            System.out.printf(
                    "candidate.accept decisionId=%s candidate=%s priority=%d score=%.1f%n",
                    decisionId, c.id(), c.priority(), score);
        }

        Ranked winner = ranked.stream()
                .max(Comparator
                        .comparingInt((Ranked r) -> r.candidate().priority())
                        .thenComparingDouble(Ranked::score)
                        .thenComparing(r -> r.candidate().id()))
                .orElse(null);

        System.out.println("decision.result decisionId=" + decisionId
                + " selected=" + (winner == null ? "NONE" : winner.candidate().id()));
    }
}
预期输出:
decision.start id=decision-120 candidateCount=3
candidate.accept decisionId=decision-120 candidate=enemy-a priority=1 score=54.0
candidate.accept decisionId=decision-120 candidate=enemy-b priority=2 score=49.0
candidate.reject decisionId=decision-120 candidate=enemy-c reason=DEAD
decision.result decisionId=decision-120 selected=enemy-b
这里 enemy-a 的分数更高,但 enemy-b 的优先级更高,所以最终选择 enemy-b。如果只打印总分而不打印优先级,就很容易误判为排序错误。
把“为什么没选”也作为结果记录
排查目标选择时,未入选信息往往比胜者更重要。候选至少要能区分三种状态:硬过滤失败、进入排序但排名较低、满足切换条件前被保持策略阻止。
过滤原因应使用稳定枚举,例如 DEAD、NOT_HOSTILE、OUT_OF_RANGE、NOT_ATTACKABLE,不要只写“invalid”。评分阶段则保留少量关键分项,例如 threat、distance、mission bonus,而不是把所有中间变量全部打印。
最终记录也不应只有 selectedTarget。如果系统支持目标黏滞,可增加 action=HOLD|SWITCH、previousTarget、challenger 和 switchReason,这样一次目标抖动能沿时间线连续复盘。
控制日志成本并验证可复盘性
开发环境可以记录全部候选;线上环境更适合按 NPC、决策异常或采样开关启用详细日志。高频 NPC 每帧打印完整候选会产生大量 I/O,也可能反过来影响帧时间,因此应让详细追踪默认关闭,并支持按实体短时开启。
验证日志是否够用,可以拿一次已知决策做反推:只看这一组日志,不打开调试器,能否回答“有哪些候选、谁被拒绝、剩余候选如何比较、最终为什么选它”。如果仍需要猜测,就说明证据链还有缺口。
一套好日志的目标不是“信息越多越好”,而是让每次选择都能被确定性复盘:同一个 decisionId 下,输入、过滤、评分、优先级和最终动作彼此对得上,排错才会从猜测变成验证。