
游戏 AI / 系统课时
NPC 奖励和惩罚项怎么加入
NPC 奖励和惩罚项怎么加入
只比较距离、威胁或基础收益,往往不足以表达 NPC 当前真正想做的事。本节把低血量、任务目标、危险区域等上下文转成可控的奖励和惩罚项,在不破坏基础评分含义的前提下形成组合评分,并通过具体代码验证修正项如何改变最终目标。
学习目标
- 区分基础评分与上下文奖励、惩罚项的职责
- 设计不会轻易压过主评分的组合规则
- 用评分明细验证目标为什么获得更高或更低的最终分数
先保留一个可解释的基础分
组合评分最容易犯的错误,是把所有条件都直接塞进一个大公式,最后只剩一个无法解释的数字。更稳妥的做法是先计算基础分,再单独叠加上下文修正。
例如 NPC 已经根据距离、威胁、目标价值得到基础分 ,随后再加入低血量奖励 、任务目标奖励 和危险区域惩罚 :
这里最重要的不是公式本身,而是每一项都能回答一个明确问题:为什么这个候选应该被额外鼓励,或者为什么应该被额外压低。
低血量奖励适合表达“优先收割”;任务目标奖励用于让剧情或关卡目标在普通候选中更有竞争力;危险区域惩罚则让 NPC 避免为了一个稍高的基础分冲进火焰、陷阱或明显不利的位置。
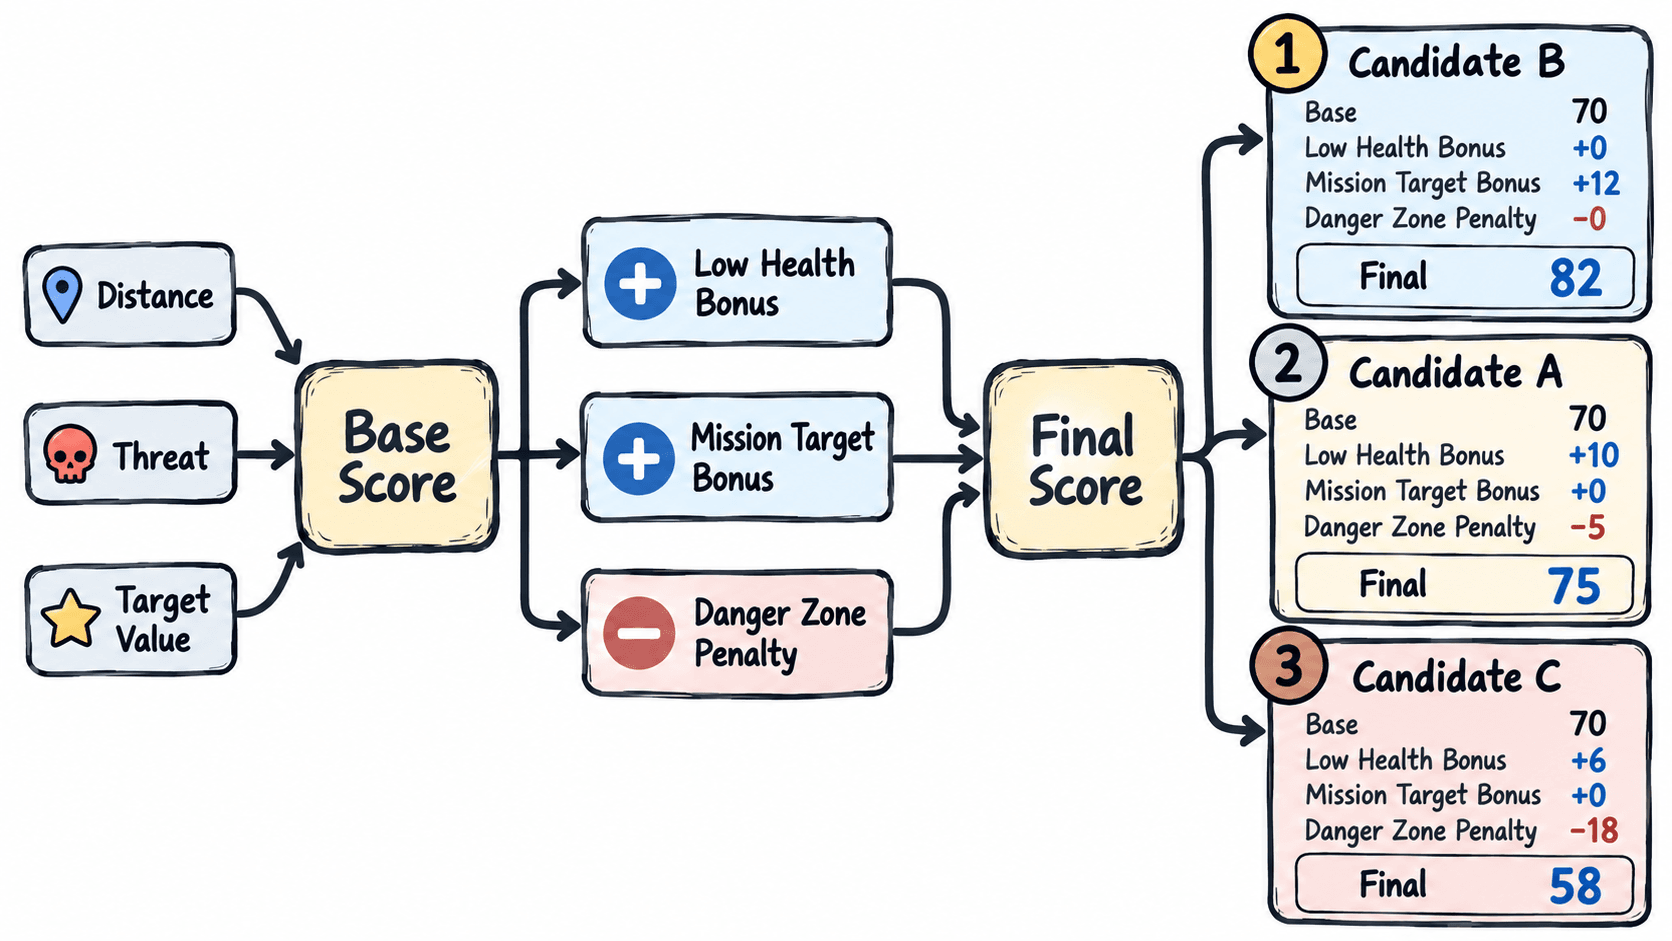
修正项不要无限放大
奖励和惩罚项本质上是在改变候选排序。如果一个任务奖励是 +1000,而正常基础分只有 0~100,那么它实际上已经不是“加成”,而是强制目标,只是换了一个不够明确的写法。
设计权重时可以先给基础分确定稳定范围,例如 0~100,再限制普通上下文修正只占其中一小部分。低血量奖励可以是 +20,任务目标奖励可以是 +30,危险区域惩罚可以是 -25。这样修正项能够改变接近候选之间的顺序,却不会轻易推翻悬殊的基础评分。
还要避免同一语义重复计分。例如基础评分已经把“目标剩余生命值”计算进去,就不要再用几乎相同的低血量奖励重复放大,否则一个因素会被计算两次。
把每个修正项单独计算
下面的 JavaScript 示例给三个候选计算组合分。每个修正项保持独立,因此调试时能直接知道分数变化来自哪里。
const config = {
  lowHealthThreshold: 0.3,
  lowHealthBonus: 20,
  missionTargetBonus: 30,
  dangerZonePenalty: 25
};

function evaluateCandidate(candidate) {
  const breakdown = {
    base: candidate.baseScore,
    lowHealthBonus: 0,
    missionBonus: 0,
    dangerPenalty: 0
  };

  // 修正项分别记录,避免最后只剩一个无法解释的总分。
  if (candidate.targetHealthRate <= config.lowHealthThreshold) {
    breakdown.lowHealthBonus = config.lowHealthBonus;
  }
  if (candidate.isMissionTarget) {
    breakdown.missionBonus = config.missionTargetBonus;
  }
  if (candidate.inDangerZone) {
    breakdown.dangerPenalty = config.dangerZonePenalty;
  }

  const finalScore =
    breakdown.base +
    breakdown.lowHealthBonus +
    breakdown.missionBonus -
    breakdown.dangerPenalty;

  return { id: candidate.id, finalScore, breakdown };
}

const candidates = [
  { id: "raider", baseScore: 60, targetHealthRate: 0.2, isMissionTarget: false, inDangerZone: false },
  { id: "quest-guard", baseScore: 55, targetHealthRate: 0.8, isMissionTarget: true, inDangerZone: false },
  { id: "sniper", baseScore: 90, targetHealthRate: 0.5, isMissionTarget: false, inDangerZone: true }
];

const ranked = candidates
  .map(evaluateCandidate)
  .sort((a, b) => b.finalScore - a.finalScore);

for (const item of ranked) {
  console.log(`${item.id}: ${item.finalScore}`);
}
预期输出:
quest-guard: 85
raider: 80
sniper: 65
sniper 的基础分最高,但危险区域让它被扣掉 25 分;quest-guard 基础分只有 55,却因为任务目标奖励上升到 85。这正是上下文修正应承担的职责:改变当前情境下的偏好,而不是重新定义所有基础指标。
调参时先看明细再看总分
实际调试时不要只记录 finalScore。至少应保留基础分和所有生效修正项,否则出现“NPC 为什么突然追另一个人”时,很难判断究竟是基础模型变化,还是某个上下文规则意外触发。
可以重点检查三类异常:某个修正项是否远大于正常基础分差值;多个修正项是否重复表达同一含义;奖励条件结束后是否及时撤销。如果一个候选从危险区域离开,下一轮评估就应去掉对应惩罚,而不是把旧分数永久累积下来。
组合评分适合处理“倾向性规则”。只要基础分保持稳定、修正项有明确语义和合理上限,并能输出评分明细,后续增加护送目标加成、掩体奖励或区域风险惩罚时,都可以沿用同一套结构而不让评分模型失控。