
大模型应用开发 / 系统课时
多步骤链的编排
多步骤链的编排
实际业务往往需要连续完成多个加工步骤,例如先总结、再翻译、最后格式化。本课学习如何用 LCEL 把多个处理步骤组合为一条顺序执行的链。
学习目标
- 掌握多步骤顺序链的编排方式
- 理解数据在链条中逐步传递的过程
- 能够在链中插入自定义处理函数
主示例
以下链条先总结原文,再将总结翻译成英文:
import os
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_openai import ChatOpenAI

model = ChatOpenAI(model=os.environ["OPENAI_MODEL"], timeout=30, max_retries=1)
parser = StrOutputParser()

summarize = ChatPromptTemplate.from_template("请用一句话总结:{text}") | model | parser
translate = ChatPromptTemplate.from_template("将下面内容翻译成英文:{summary}") | model | parser

full_chain = (
    {"summary": summarize}
    | translate
)

result = full_chain.invoke({"text": "LangChain 支持把多个步骤组合成一条处理链。"})
print(result)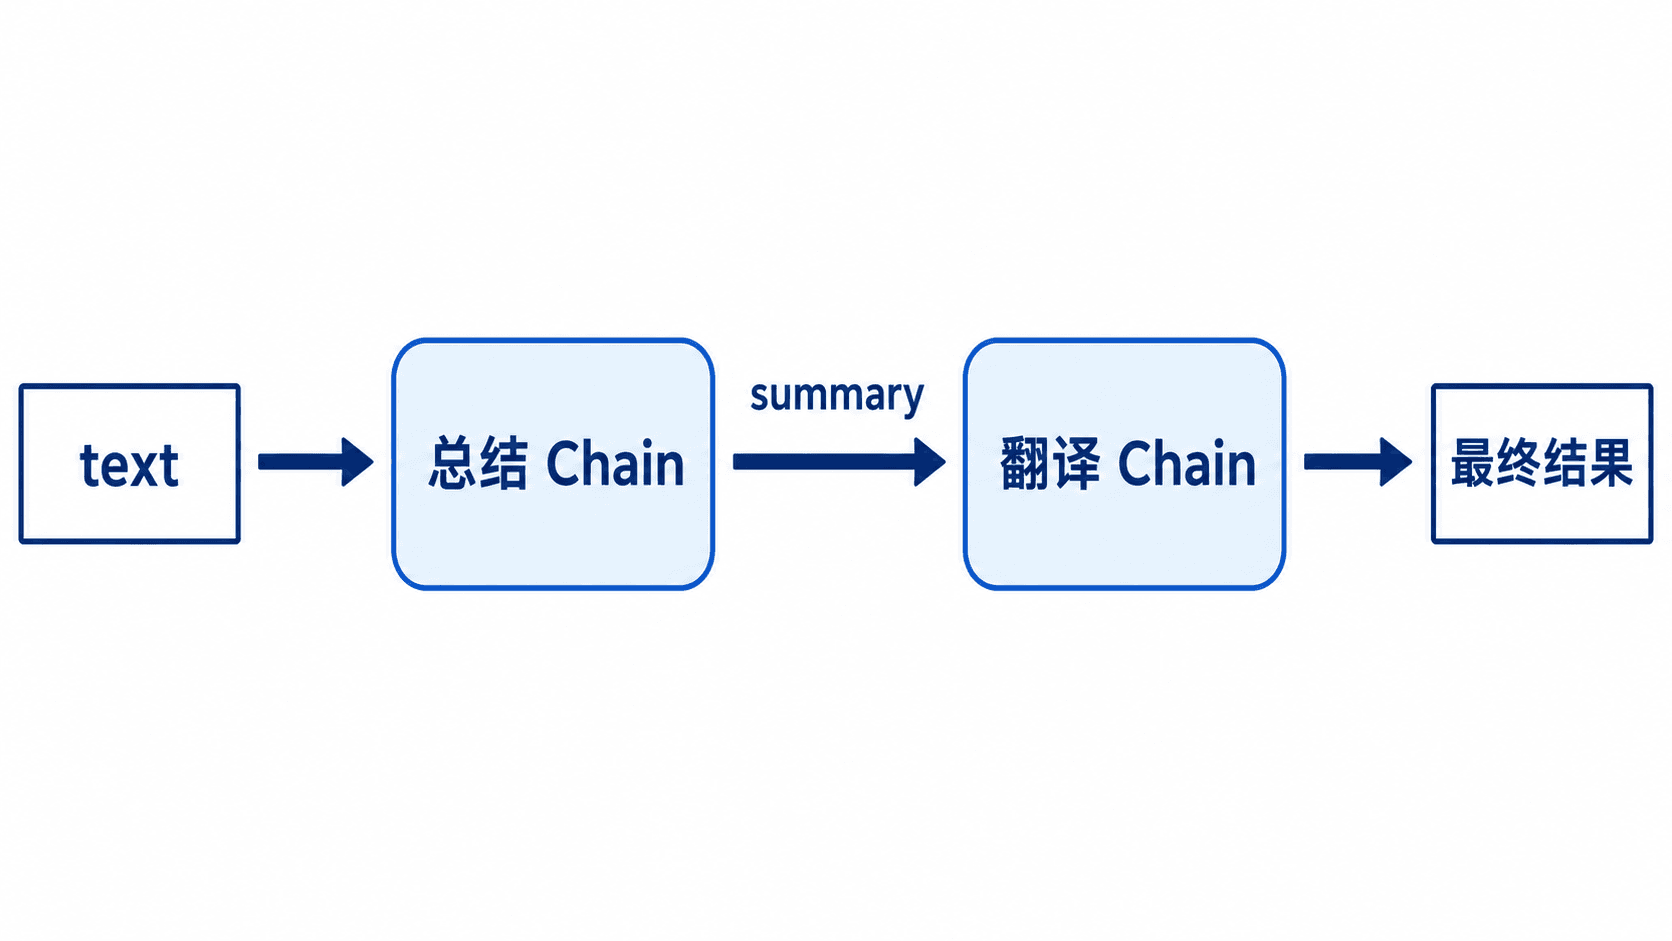
输出验证
预期输出为英文翻译结果:
LangChain supports combining multiple steps into a single processing chain.上图展示了数据如何从原始文本依次流经"总结"和"翻译"两个节点,最终得到英文结果。
关键边界
{"summary": summarize} 这种字典写法会把 summarize 子链的输出映射为下一步的输入变量名,字典的键必须与下一个模板中使用的变量名一致;链条越长,建议拆分成命名清晰的子链再组合,便于单独测试和复用。
字典映射不会自动保留原输入
这里 summarize 子链接收原始 text 字典,输出摘要字符串;映射将字符串包装为 summary 字段,translate 读取该字段。映射的输出只包含显式定义的键,原文 text 不会自动保留。若后续还需要原文,应显式增加保留分支,避免误以为所有历史变量一直存在。
总结与翻译存在先后依赖,不能把两条链直接放进互不依赖的并行分支。字典形式可以同时计算多个键,但本例只有一个 summary 键;它的主要作用是重命名与包装数据,而不是使两个模型调用并发。
排查失败时先单独运行 summarize.invoke,确认得到摘要字符串;再将固定摘要传给 translate.invoke。第一步 text 键缺失属于模板输入错误,第二步缺少 summary 属于映射契约错误;服务超时则应记录发生在哪一次模型请求。不要只捕获最外层异常然后返回空字符串。
主示例共发起两次模型请求,延迟和费用需要累计。缩短原文不一定减少第二次调用的等待,摘要质量不好也会传播到翻译。验收分别检查摘要保留事实、翻译不新增事实,以及最终输出语言正确;已有流程图继续用于定位数据经过的两个阶段。
如果添加写数据库或发消息的自定义步骤,应明确其幂等键与重试范围。纯文本加工可以重算,外部写入可能重复发生,两者不能使用同样的整链重试策略。