
大模型应用开发 / 系统课时
构建 RAG 问答链
构建 RAG 问答链
本课将检索器、提示词和聊天模型组合为完整 RAG 问答链。完成后,用户问题会先检索知识库,再把命中文档作为上下文交给模型,从而生成有依据的回答。
学习目标
- 理解 RAG 的检索、组装上下文和生成三个阶段
- 使用 LCEL 组合检索器、提示词、模型与输出解析器
- 为无依据回答、来源追踪和上下文长度设置边界
RAG 的执行链路
RAG 不会修改模型参数,而是在每次提问时临时检索外部知识。问题先进入检索器,命中文档被格式化后填入提示词,模型最后依据问题和上下文生成答案。
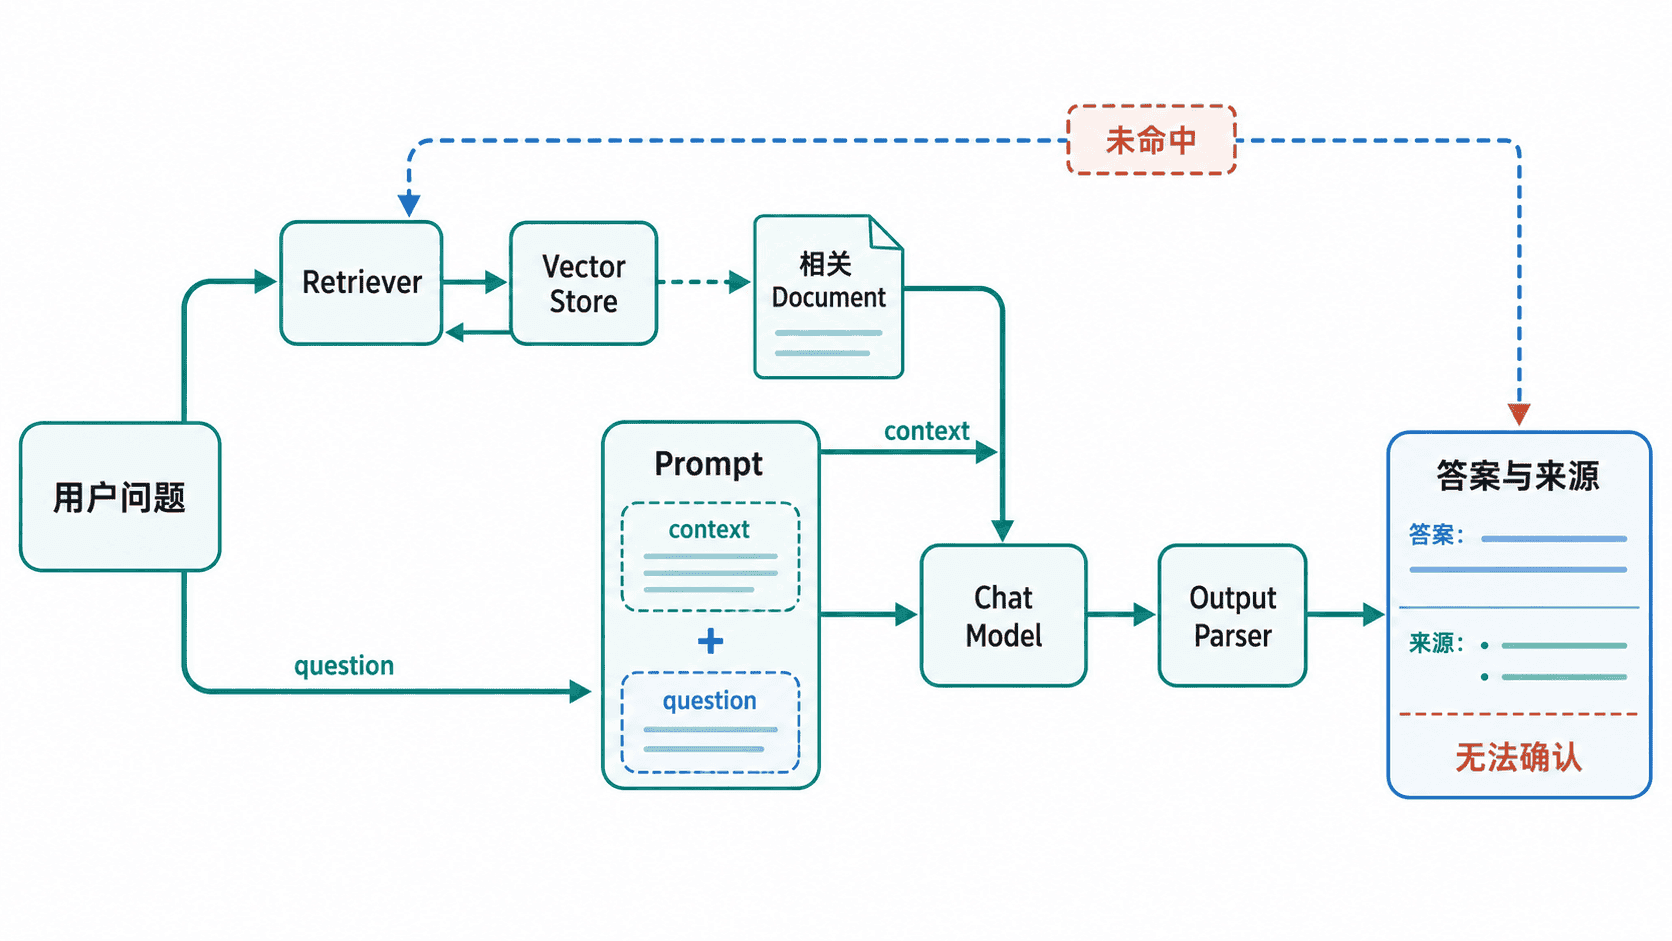
检索质量决定模型能看到什么,提示词决定模型如何使用资料,模型只负责组织回答。若检索结果本身错误,再强的模型也可能生成看似合理但依据错误的答案。
组合最小 RAG 链
下面使用关键词嵌入建立一个离线向量库,并用 FakeListChatModel 作为可重复的测试模型。它用于验证链路是否连接正确;生产环境应替换为真实聊天模型,并对答案进行评估。
python
from langchain_core.documents import Document
from langchain_core.embeddings import Embeddings
from langchain_core.language_models import FakeListChatModel
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough
from langchain_core.vectorstores import InMemoryVectorStore

KEYWORDS = ["退款", "到账", "发票"]

class KeywordEmbeddings(Embeddings):
    def _embed(self, text: str) -> list[float]:
        return [float(text.count(word)) for word in KEYWORDS]

    def embed_documents(self, texts: list[str]) -> list[list[float]]:
        return [self._embed(text) for text in texts]

    def embed_query(self, text: str) -> list[float]:
        return self._embed(text)

documents = [
    Document(
        page_content="退款审核通过后,资金按原支付路径返回,通常 1 到 3 个工作日到账。",
        metadata={"source": "refund-policy"},
    ),
    Document(
        page_content="电子发票可在订单详情页申请。",
        metadata={"source": "invoice-guide"},
    ),
]
store = InMemoryVectorStore(embedding=KeywordEmbeddings())
store.add_documents(documents)
retriever = store.as_retriever(search_kwargs={"k": 1})

def format_documents(docs: list[Document]) -> str:
    return "\n".join(doc.page_content for doc in docs)

prompt = ChatPromptTemplate.from_messages(
    [
        (
            "system",
            "只根据给定上下文回答;上下文没有答案时,明确说无法从知识库确认。\n"
            "上下文:\n{context}",
        ),
        ("human", "{question}"),
    ]
)
model = FakeListChatModel(
    responses=["退款将在原支付路径返回,通常 1 到 3 个工作日到账。"]
)
rag_chain = (
    {
        "context": retriever | format_documents,
        "question": RunnablePassthrough(),
    }
    | prompt
    | model
    | StrOutputParser()
)
print(rag_chain.invoke("退款多久能到账?"))
预期输出如下。
text
退款将在原支付路径返回,通常 1 到 3 个工作日到账。这个链通过字典并行准备 context 和 question,再依次经过提示词、模型和字符串解析器。替换真实模型时,链的输入输出结构可以保持不变。
加入回答边界
生产 RAG 至少应补充三类约束:没有高质量命中时拒绝猜测;保留文档来源并随答案返回;限制上下文总长度,避免重复块挤占模型窗口。需要多轮追问时,还应把“根据历史改写问题”和“基于知识库回答”分成两个步骤。
验收时不要只观察语言是否流畅,而要检查答案中的关键事实能否在命中文档中找到。对于金额、期限、权限和合规规则,应优先返回原始来源或结构化字段,避免模型自行补全。
按自己的节奏,确认真正理解。