
大模型应用开发 / 系统课时
向量存储与检索器
向量存储与检索器
本课将把文档写入向量存储,并将其封装为统一检索器。完成后,你可以用自然语言问题召回相关文档,同时理解嵌入模型、向量存储和检索器之间的职责边界。
学习目标
- 理解文本向量化与相似度检索的基本链路
- 使用
InMemoryVectorStore写入并查询文档 - 通过
as_retriever为后续 RAG 链提供统一接口
三个组件如何协作
嵌入模型把文本转换为定长向量;向量存储保存向量、原文和元数据;检索器接收问题并返回 Document 列表。检索器只负责找资料,不负责生成最终答案。
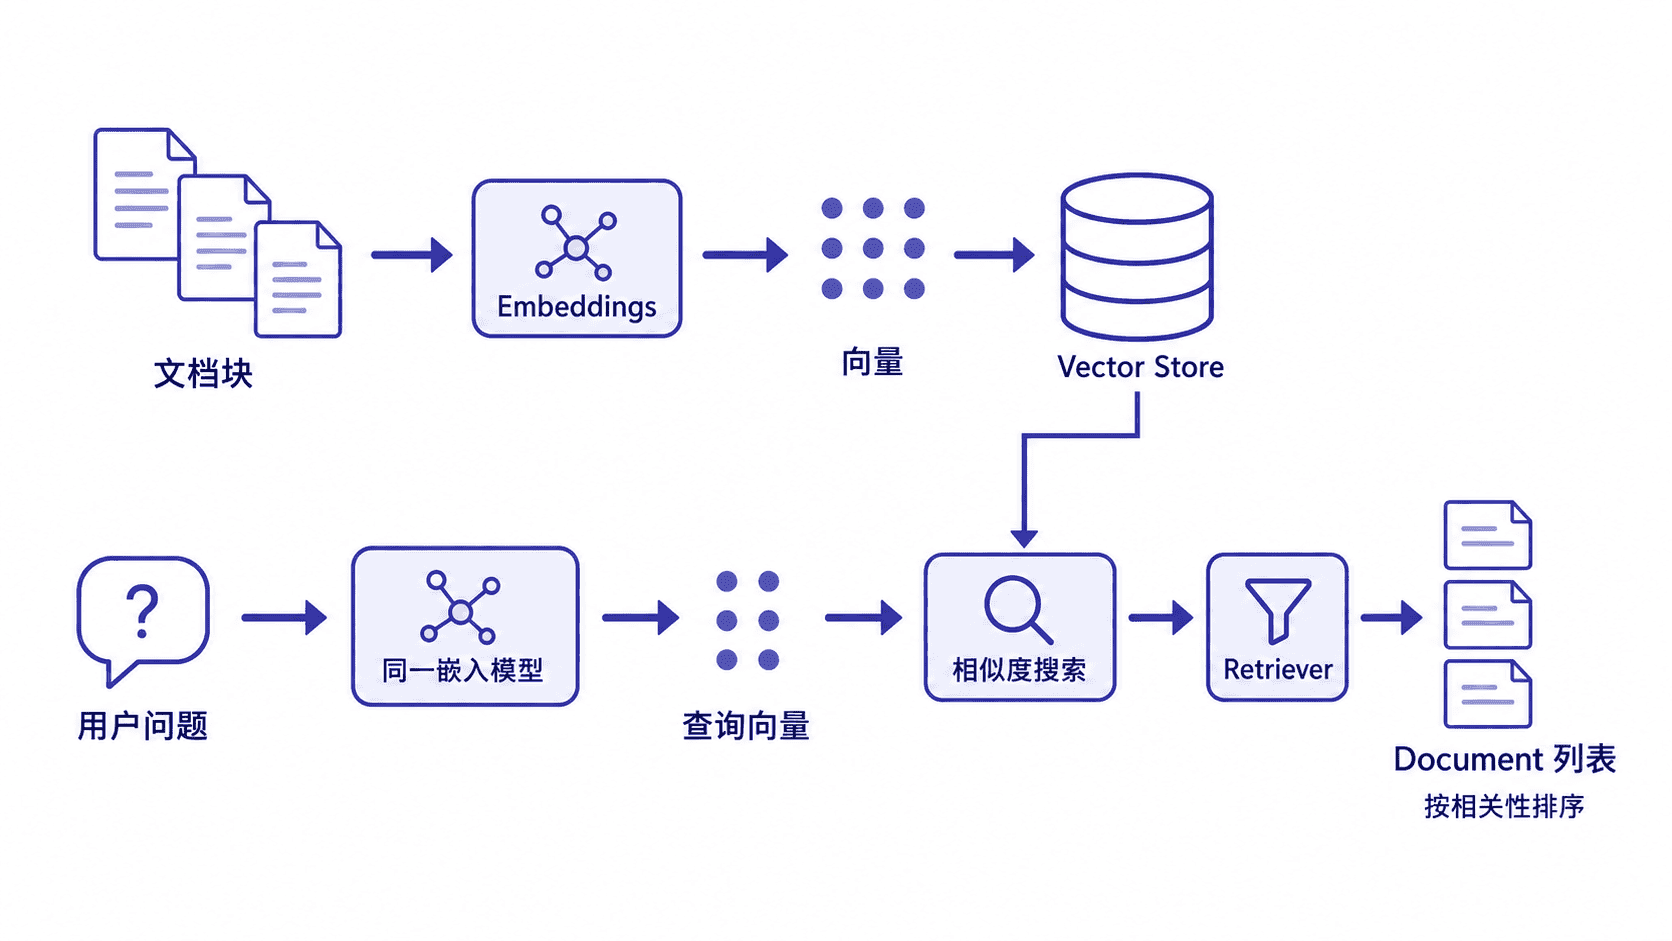
索引阶段和查询阶段必须使用兼容的嵌入空间。若更换嵌入模型或向量维度,通常需要重建索引,否则旧向量与新查询向量不可直接比较。
构建可验证的检索器
为了让示例离线可运行,下面实现一个只识别三个业务关键词的教学嵌入模型。它用于验证 LangChain 接口与数据流,不代表生产语义检索质量;上线时应替换为真实嵌入模型。
python
from langchain_core.documents import Document
from langchain_core.embeddings import Embeddings
from langchain_core.vectorstores import InMemoryVectorStore

VOCABULARY = ["密码", "退款", "发票"]

class KeywordEmbeddings(Embeddings):
    def _embed(self, text: str) -> list[float]:
        # 每个维度表示一个关键词出现次数,保证示例结果可重复。
        return [float(text.count(word)) for word in VOCABULARY]

    def embed_documents(self, texts: list[str]) -> list[list[float]]:
        return [self._embed(text) for text in texts]

    def embed_query(self, text: str) -> list[float]:
        return self._embed(text)

documents = [
    Document(
        page_content="忘记密码时,可通过登录页的重置密码入口完成验证。",
        metadata={"title": "重置密码"},
    ),
    Document(
        page_content="退款申请审核通过后,资金按原支付路径返回。",
        metadata={"title": "退款说明"},
    ),
    Document(
        page_content="电子发票可在订单详情页申请并下载。",
        metadata={"title": "发票申请"},
    ),
]
vector_store = InMemoryVectorStore(embedding=KeywordEmbeddings())
vector_store.add_documents(documents)
retriever = vector_store.as_retriever(search_kwargs={"k": 2})
results = retriever.invoke("忘记密码后应该怎么处理?")
print(results[0].metadata["title"])
预期输出如下。
text
重置密码这里先通过 add_documents 建立索引,再通过 as_retriever 暴露统一检索接口。后续即使把内存存储替换为 Chroma、Qdrant 或其他实现,RAG 链仍可继续调用 retriever.invoke(query)。
选择检索策略
k 决定最多返回多少个文档。值过小可能遗漏答案,值过大则会把噪声和重复内容送入模型。生产环境还可结合相关度阈值、元数据过滤、最大边际相关性或混合检索改善结果。
检索效果不能只看第一条结果。建议准备一组真实问题,记录命中文档、排序位置和是否包含答案,再调整切分、嵌入模型和检索参数。向量库只解决相似内容查找,权限过滤和数据隔离仍需由业务层明确实现。
按自己的节奏,确认真正理解。