
大模型应用开发 / 系统课时
性能与成本优化
性能与成本优化
本课建立一条可执行的优化路径:先测量延迟与 Token,再减少重复调用和无效上下文,最后通过批处理与模型分级提升吞吐。目标不是盲目追求最低价格,而是在质量、响应时间、并发能力和费用之间取得可验证的平衡。
学习目标
- 区分首字延迟、总耗时、吞吐量和 Token 成本
- 使用模型缓存与
batch处理重复或独立请求 - 根据任务难度选择模型,并通过回归样例验证质量
先建立可比较的基线
每次优化前固定一组代表性输入,记录端到端耗时、模型耗时、输入与输出 Token、成功率和答案质量。成本可概括为“输入 Token 费用加输出 Token 费用”,但实际单价由提供商和模型决定,不能只用请求次数估算。
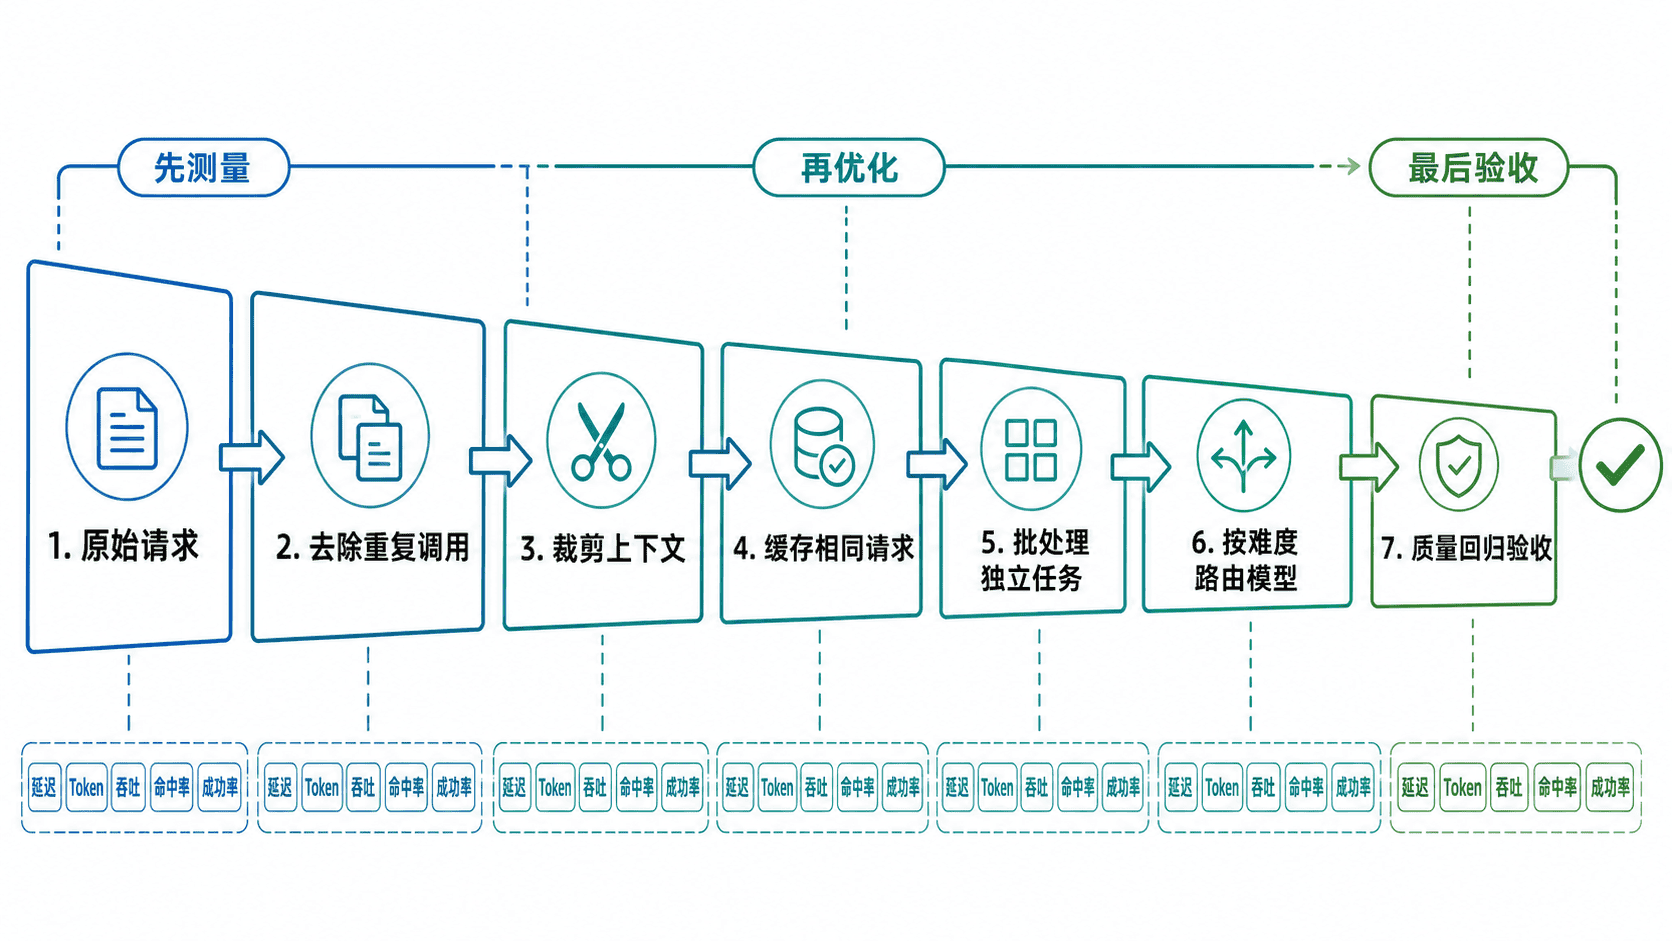
优先处理最明显的浪费:重复请求、重复嵌入、过长历史消息、无关检索文档和不必要的多轮 Agent 循环。只有确认瓶颈位于模型调用后,缓存或换模型才会产生预期收益。
使用缓存与批处理
下面对完全相同的直接模型调用启用进程内缓存,并用 batch 并行处理三个互相独立的问题。示例需要配置 MODEL_NAME 和对应提供商的 API Key;进程内缓存仅适合本地验证,生产环境应换成可共享且有淘汰策略的缓存。
import os

from langchain.chat_models import init_chat_model
from langchain_core.caches import InMemoryCache
from langchain_core.globals import set_llm_cache

def main() -> None:
    model = init_chat_model(os.environ["MODEL_NAME"], temperature=0)
    set_llm_cache(InMemoryCache())

    prompt = "用一句话说明什么是向量检索。"
    first = model.invoke(prompt)
    second = model.invoke(prompt)
    print(first.content == second.content)

    prompts = [
        "用一句话说明缓存命中。",
        "用一句话说明批处理。",
        "用一句话说明模型路由。",
    ]
    responses = model.batch(
        prompts,
        config={"max_concurrency": 3},
    )
    print(len(responses))
    print(all(bool(item.content) for item in responses))

if __name__ == "__main__":
    main()
预期输出:
True
3
True第一次相同请求会访问模型,第二次可复用缓存结果。batch 的默认实现通常在客户端并行发起独立调用,它不同于提供商专用的离线批量 API;并发数仍要受限流、连接池和下游容量约束。
按收益顺序选择手段
先裁剪无关上下文与历史消息,因为它同时降低延迟和输入费用;再缓存确定性高、重复率高且允许短期复用的结果;随后把互相独立的分类、抽取或评测任务批量处理。对于简单分类、格式转换和路由,可尝试较小模型;复杂推理或高风险输出再升级模型。
缓存键必须包含会影响结果的模型名、Prompt 版本、温度、工具版本和业务权限范围。用户数据或实时价格等内容需要短 TTL 或直接禁用缓存。Agent 内部消息可能包含动态状态,不能假设所有 Agent 调用都能稳定命中普通模型缓存。
用质量回归决定是否上线
任何降本方案都要在固定样例集上比较准确率、格式通过率、工具调用成功率和人工评分。只有费用下降而质量不退化到业务阈值以下,才算有效优化。建议把基线与优化版本放在同一追踪项目中,用标签区分版本,避免凭主观感受判断。