
大模型应用开发 / 系统课时
调试与调用链追踪
调试与调用链追踪
本课为 LangChain 调用开启追踪,并建立一套从顶层请求向下定位的调试顺序。完成后,你能在一次运行中看到模型调用、工具或检索子步骤的耗时与输入输出,不再只依赖最终报错猜测问题来源。
学习目标
- 为一次 LangChain 调用启用 LangSmith 追踪并指定项目
- 使用运行名称、标签和元数据提高链路可检索性
- 按父子调用顺序定位慢调用、错误参数和异常输出
先理解追踪树
一次应用请求通常包含多个子运行:顶层链或 Agent 调用模型,模型可能触发工具,工具又可能访问检索器或外部接口。追踪系统把这些步骤组织成树,因此应先确认哪一个节点失败,再查看该节点的输入、输出、耗时和错误。
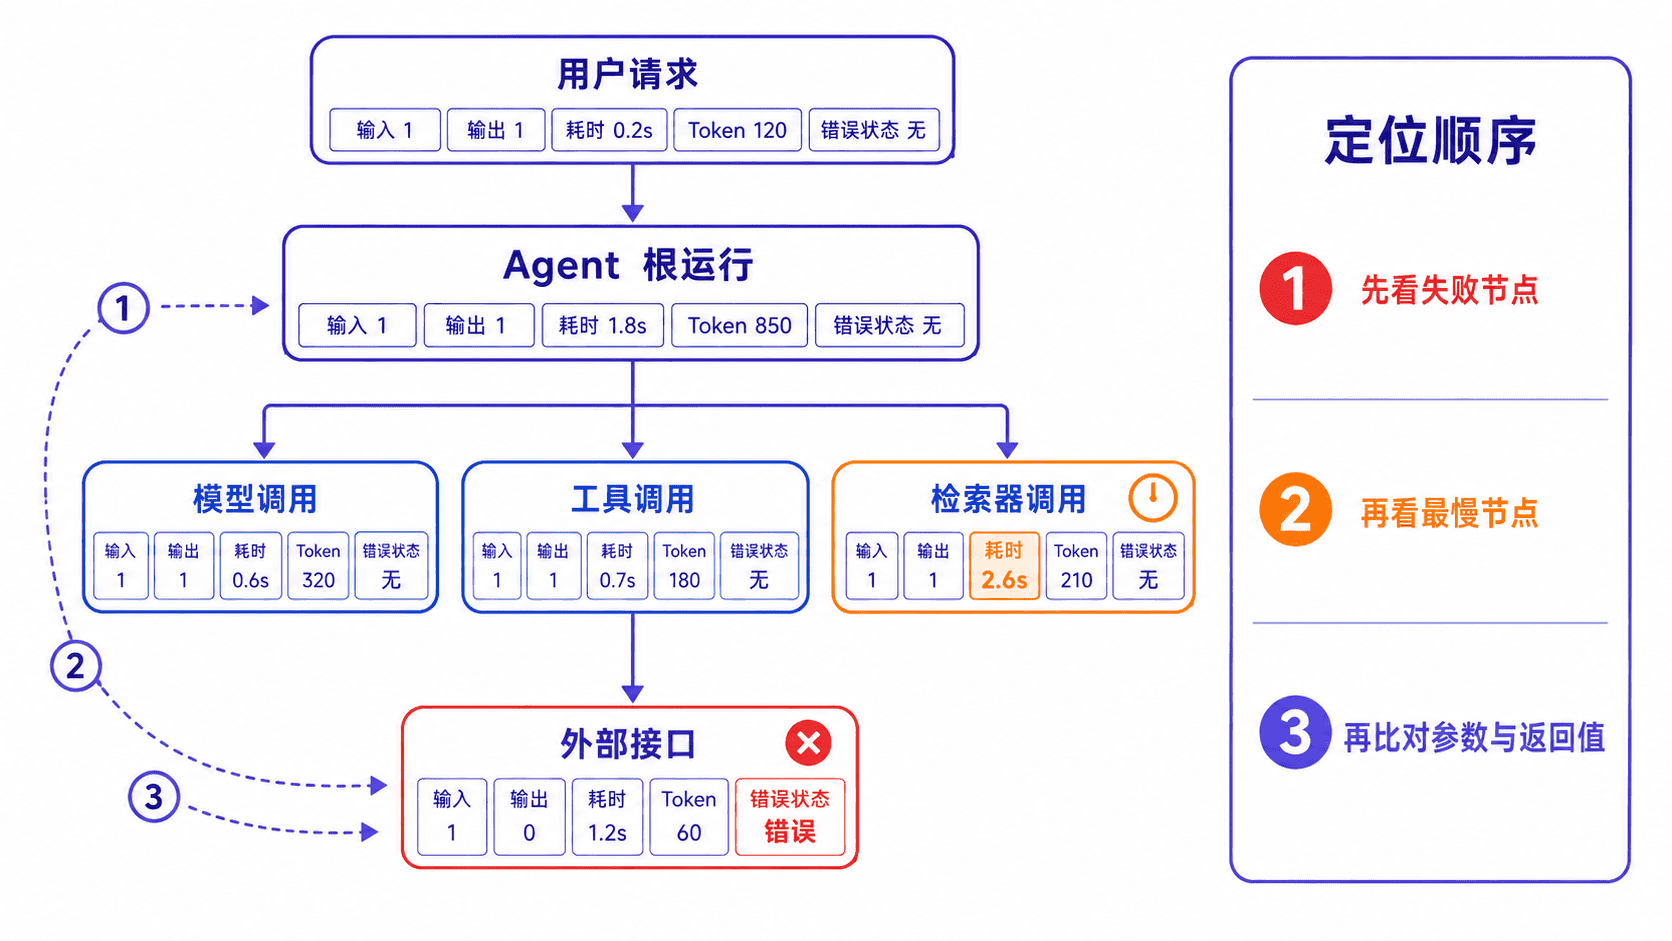
如果只记录一条最终日志,无法判断错误发生在提示词、模型选择、工具参数还是数据源。追踪的价值是保留因果关系,而不是简单增加日志数量。
开启追踪并运行一次调用
运行前需要配置 LANGSMITH_API_KEY、模型提供商 API Key 和 MODEL_NAME。下面的程序启用追踪,指定项目名称,并为调用增加运行名、标签和业务元数据。敏感信息不应写入元数据。
import os

from langchain.chat_models import init_chat_model

def main() -> None:
    required = ["LANGSMITH_API_KEY", "MODEL_NAME"]
    missing = [name for name in required if not os.getenv(name)]
    if missing:
        raise RuntimeError(f"missing environment variables: {', '.join(missing)}")

    os.environ["LANGSMITH_TRACING"] = "true"
    os.environ.setdefault("LANGSMITH_PROJECT", "anystack-langchain-debug")

    model = init_chat_model(os.environ["MODEL_NAME"], temperature=0)
    response = model.invoke(
        "只回复 trace-ok",
        config={
            "run_name": "trace_smoke_test",
            "tags": ["tutorial", "smoke-test"],
            "metadata": {"environment": "local"},
        },
    )

    print(type(response).__name__)
    print(bool(response.content))

if __name__ == "__main__":
    main()
预期输出:
AIMessage
True
同时,追踪项目中应出现名为 trace_smoke_test 的运行记录。实际模型文本、运行时间和 Token 数会变化,但运行名称、标签和元数据应与代码一致。
按固定顺序定位问题
先看根运行是否收到正确用户输入,再检查第一个异常或耗时突增的子节点。模型节点重点核对系统指令、消息顺序、停止原因和 Token 使用量;工具节点重点核对工具名、参数 Schema、返回值与异常;检索节点重点核对查询文本、召回数量、文档来源和相关性。
调试时一次只改变一个变量。例如先固定模型和输入,只调整检索参数;确认召回正常后,再修改提示词。若同时更换模型、Prompt 和数据源,即使结果变好也无法判断真正原因。
控制追踪数据边界
追踪可能包含用户问题、检索文档和工具参数,因此上线前要制定脱敏与采样策略。密码、访问令牌、支付凭证和完整个人信息不得进入追踪;高流量场景可对正常请求采样,对错误和高延迟请求保留完整链路。