
大模型应用开发 / 系统课时
输出解析器
输出解析器
模型默认返回的是自由文本,直接在业务代码中做字符串解析既繁琐又脆弱。本课学习使用输出解析器,把模型响应转换为结构化、可直接使用的数据。
学习目标
- 理解输出解析器在链路中的作用位置
- 掌握字符串解析器与结构化解析器的用法
- 能够将解析器与提示词、模型组合成完整链路
规则与接口
StrOutputParser 负责把模型返回对象转换为纯字符串;PydanticOutputParser 则可以结合预定义的数据模型,把模型输出解析为带字段校验的对象,并自动生成对应的格式说明注入提示词。
主示例
import os
from langchain_core.output_parsers import PydanticOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI
from pydantic import BaseModel, Field

class BookInfo(BaseModel):
    title: str = Field(description="书名")
    author: str = Field(description="作者")

parser = PydanticOutputParser(pydantic_object=BookInfo)
prompt = ChatPromptTemplate.from_messages([
    ("system", "请提取书籍信息。{format_instructions}"),
    ("human", "{text}")
]).partial(format_instructions=parser.get_format_instructions())

model = ChatOpenAI(model=os.environ["OPENAI_MODEL"], timeout=30, max_retries=1)
chain = prompt | model | parser

result = chain.invoke({"text": "《三体》是刘慈欣创作的科幻小说。"})
print(result)
输出验证
预期输出为一个 BookInfo 对象:
title='三体' author='刘慈欣'可以直接通过 result.title、result.author 访问字段,无需再手写字符串解析逻辑。
关键边界
结构化解析依赖模型严格按照指定格式输出,如果模型返回内容不符合约定格式,解析会抛出校验错误;遇到这种情况通常需要在提示词中加强格式约束,或捕获异常后重试。
格式正确不等于事实正确
StrOutputParser 适合后续只需要纯文本的链;PydanticOutputParser 适合必须访问字段且检查类型的业务。解析器不会凭空让模型遵守约定,format_instructions 只是提示;真正的校验发生在解析输出时。缺少必填字段或无法解码的内容,应进入错误处理,而不是保存半个对象。
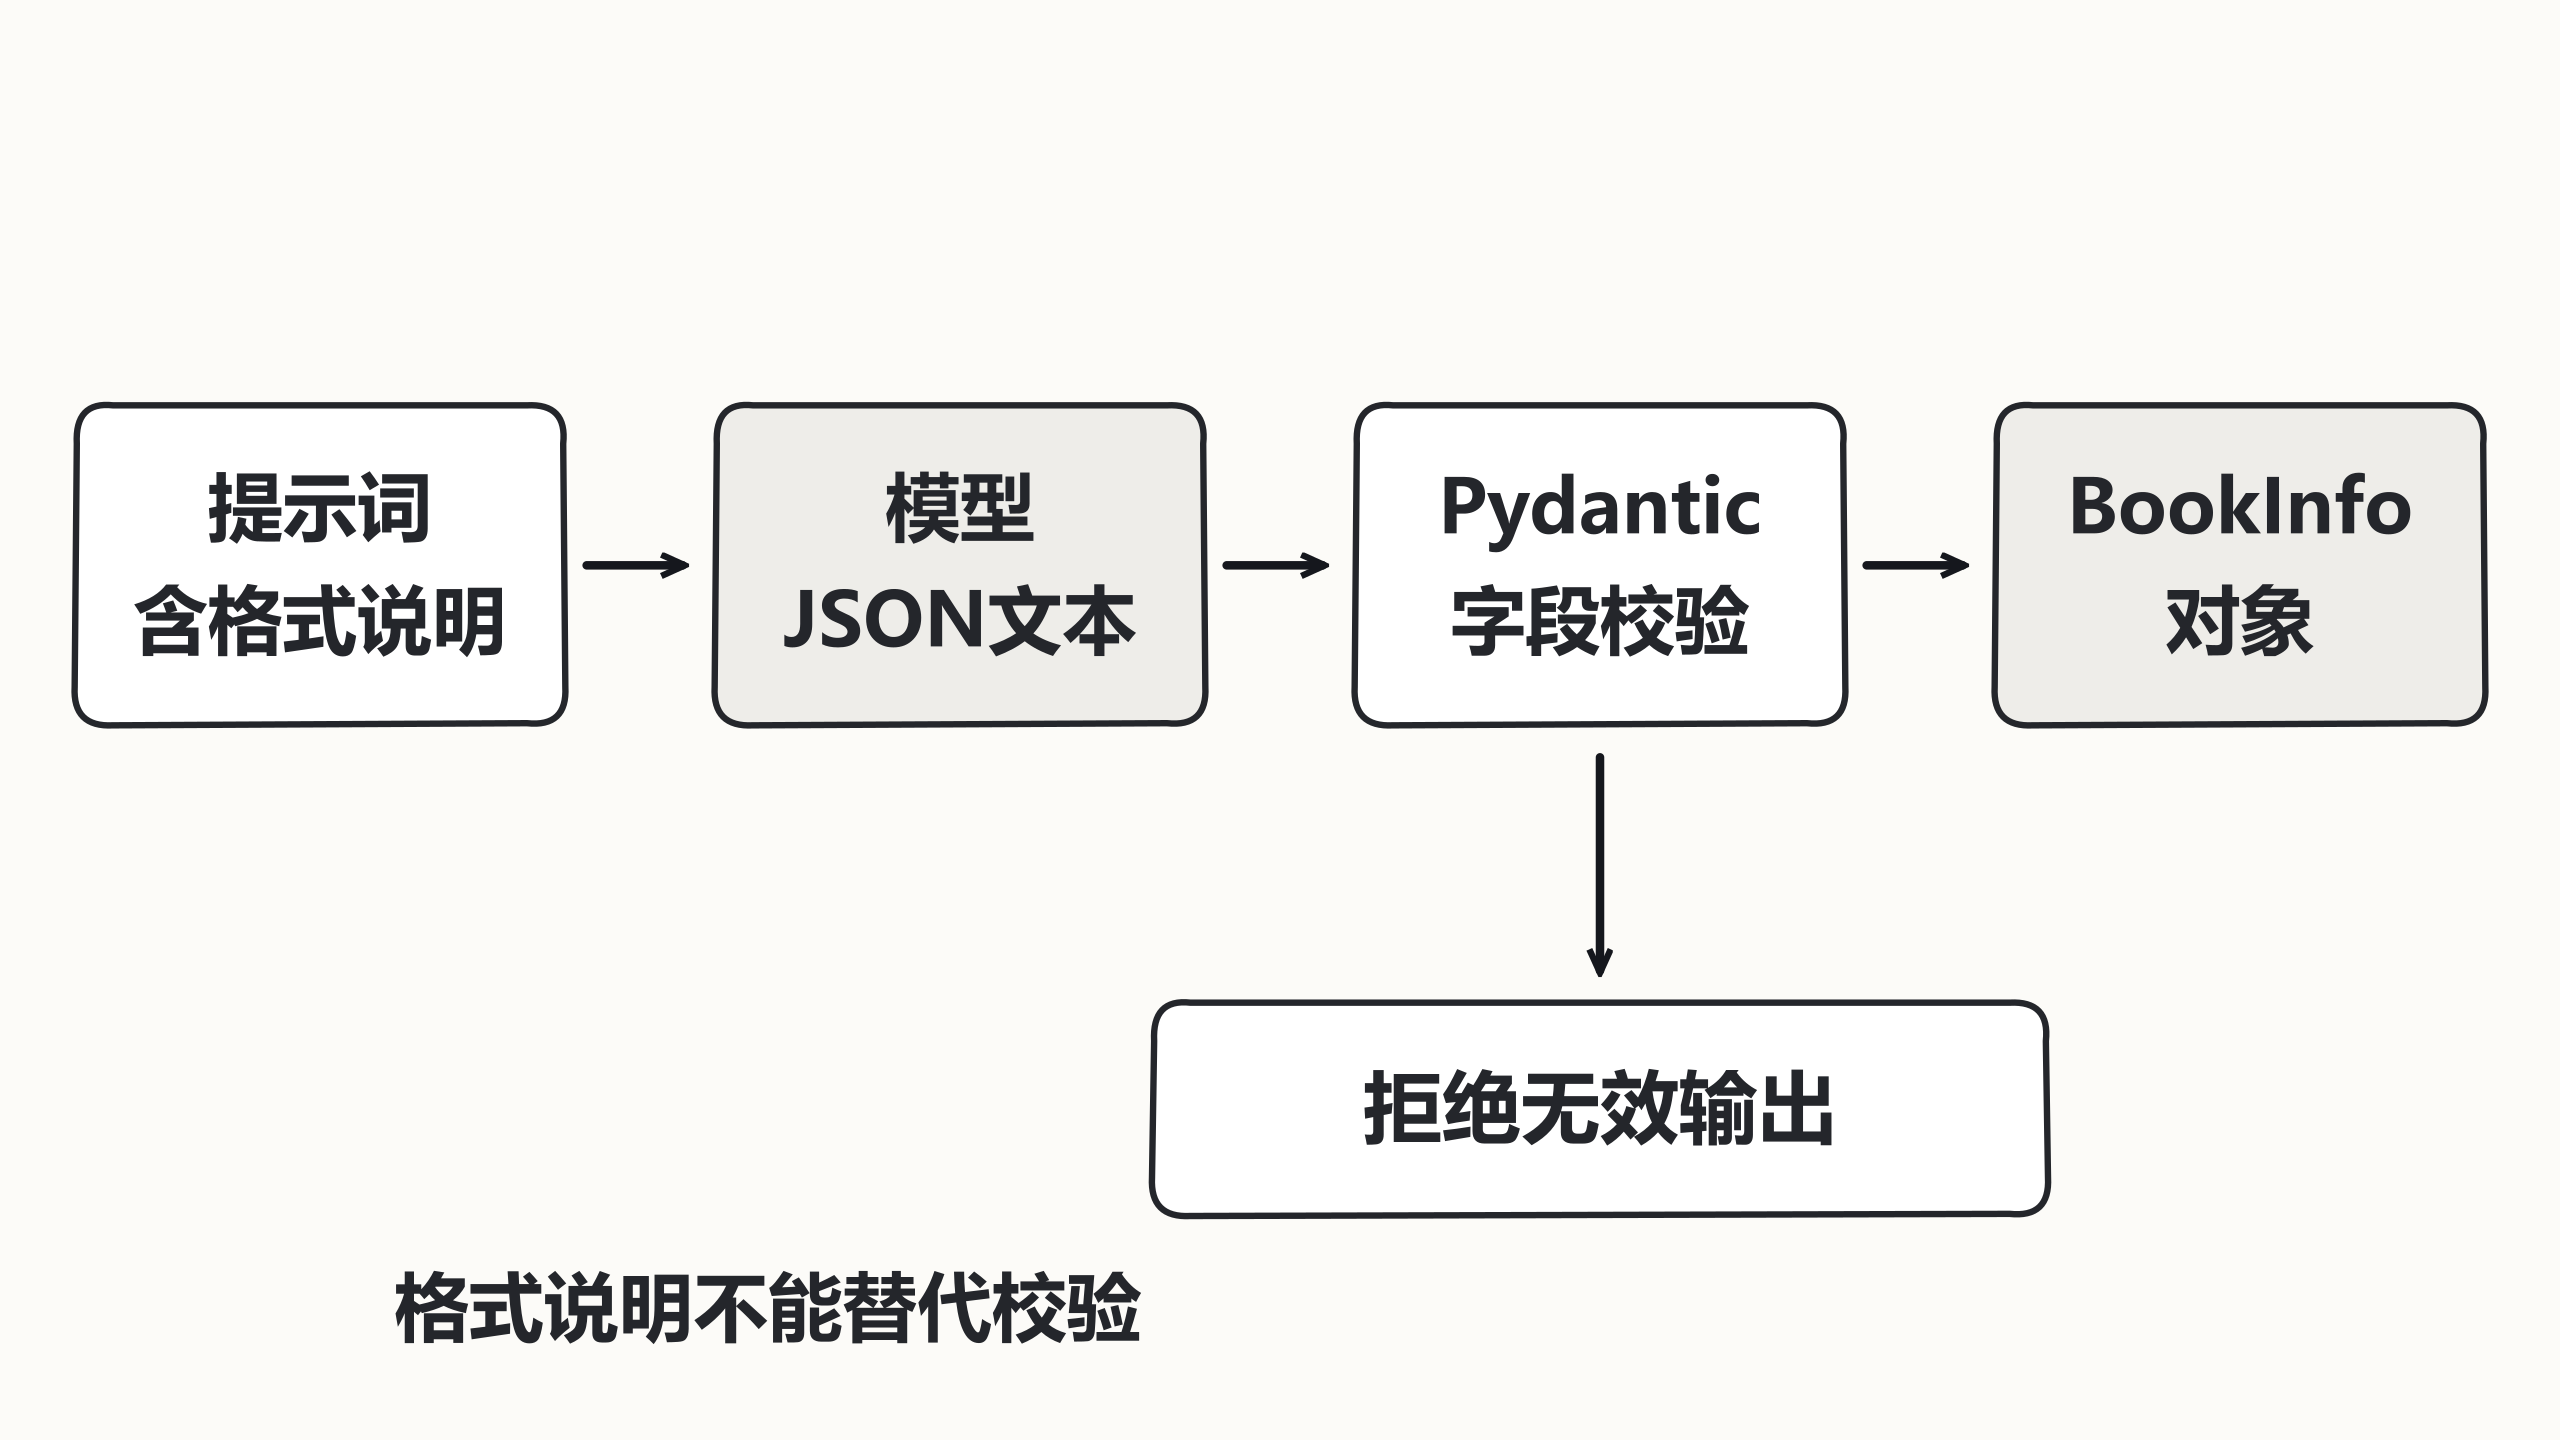
主示例保留书名与作者两个字段。若业务需要非空、长度上限或禁止额外字段,应在 Pydantic 模型中显式配置,而不是认为 str 自动保证非空。字段校验只证明数据满足结构,不证明作者姓名是事实,也不证明原文包含该信息。
可以直接用 parser.invoke 传入固定 JSON 测试解析,绕开网络与模型随机性;再测试缺少 author、错误字段类型及无效 JSON,确认全部拒绝。真实模型集成测试则检查正常提取和资料不足时的行为,不应只断言最终字符串含有“书名”。
重试应有上限,并保留失败阶段与异常类型。不要把模型无依据补出的作者写入数据;输入缺信息时,先由业务定义返回空值、拒绝或要求补充,再调整数据模型。支持原生结构化输出的模型还可使用对应能力,但仍需验证业务语义。