
大模型应用开发 / 系统课时
文档加载与切分
文档加载与切分
本课解决 RAG 数据准备的第一步:把本地文本读取为统一的 Document 对象,再切成可独立检索的文本块。完成后,你将能保留来源元数据,并验证分块非空、来源可追踪。
学习目标
- 理解文档加载器输出的内容与元数据
- 使用递归字符切分器生成带重叠的文本块
- 根据检索效果调整块大小与重叠长度
从原始文件到文本块
文档加载器负责读取文件、网页或业务系统数据,并统一转换为 Document。其中 page_content 保存正文,metadata 保存来源、页码等追踪信息。切分器随后把长文档拆成多个块,同时继承原文档元数据。
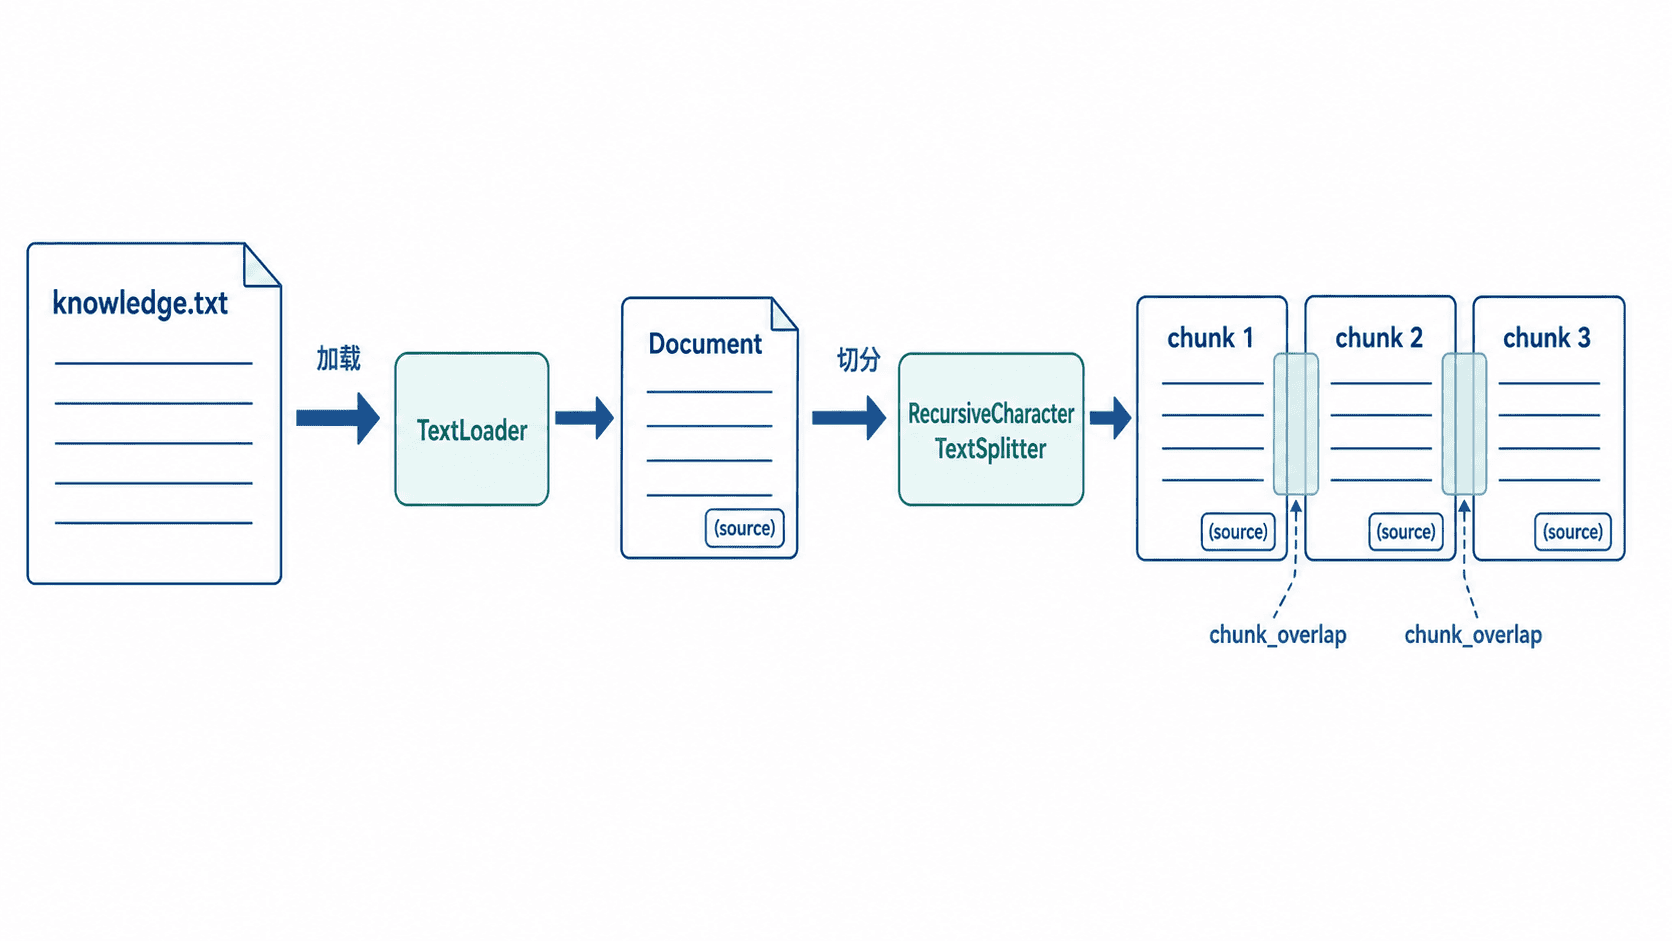
块太大时,一次检索会带入过多无关内容;块太小时,完整语义可能被截断。重叠区域用于保留边界附近的上下文,但重叠过大也会增加索引量和重复召回。
完成加载与切分
下面程序会先创建示例文件,再使用 TextLoader 加载,并按字符递归切分。示例可独立运行,不依赖外部文档。
python
from pathlib import Path
from langchain_community.document_loaders import TextLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter

file_path = Path("knowledge.txt")
file_path.write_text(
    "订单创建后进入待支付状态。支付成功后,系统生成交易流水并发送通知。"
    "若支付超时,订单会被关闭,后续支付请求应返回订单已失效。"
    "退款成功后,系统生成负数流水,并按原支付路径退回资金。",
    encoding="utf-8",
)
loader = TextLoader(str(file_path), encoding="utf-8")
documents = loader.load()
splitter = RecursiveCharacterTextSplitter(
    chunk_size=45,
    chunk_overlap=10,
    separators=["。", ",", "\n", " ", ""],
)
chunks = splitter.split_documents(documents)
# 只验证稳定属性,避免把具体分块数量写死在测试中。
print(documents[0].metadata["source"])
print(len(chunks) >= 2)
print(all(bool(chunk.page_content.strip()) for chunk in chunks))
预期输出如下。
text
knowledge.txt
True
True
split_documents 会保留原始元数据,因此每个块仍可追溯到 knowledge.txt。实际项目还应补充文档 ID、版本号、更新时间或页码,便于回答时展示来源并支持增量更新。
调整切分参数
调整参数时不要只看字符数量,应同时观察召回结果。操作手册可按标题和段落切分,接口文档可优先保留完整接口定义,代码文件则应使用适合语言结构的切分策略。
可以先使用中等块大小建立基线,再围绕真实问题检查三件事:目标答案是否位于同一块、召回内容是否包含过多噪声、相邻块是否大量重复。只有评估结果变差时才需要继续调参。
常见错误与验证
常见错误包括文件编码不匹配、空文档被写入索引、元数据在自定义处理时丢失,以及把表格或代码按普通段落粗暴截断。入库前至少应检查文档数、空块比例、块长度分布和来源字段。
对于 PDF、网页等格式,加载结果还可能包含页眉、导航栏或重复页脚。此时应先清洗,再切分;否则向量库会稳定地召回这些噪声内容。
按自己的节奏,确认真正理解。