
通信工程 / 系统课时
校准采样率噪声功率与EbN0
校准采样率噪声功率与EbN0
把 BPSK 和 QPSK 链路设为同样的 6 dB Eb/N0,却得到相差数倍的误码率,通常是能量和噪声口径没有统一。这里用八倍采样的收发链路,逐项校准符号能量、实复噪声方差和匹配滤波器,并用可复现的误码统计验收。
学习目标
- 从符号能量、每符号比特数与码率推算 AWGN 方差。
- 在改变每符号采样数时保持离散符号能量不变。
- 用噪声实测方差和 BPSK/QPSK 误码率发现 3 dB、9 dB 的标定错误。
从信息比特能量反推噪声
先明确比较的是信息比特能量。若调制阶数为 、每符号承载 个编码比特、编码率为 ,则 。设 ,在平均符号能量 时,噪声谱密度参数为 。本例均不编码,即 。
对于实数 AWGN,样本服从均值为零、方差 的高斯分布;对于复基带 AWGN,I、Q 两个实维各有方差 ,因此复噪声功率 。复噪声总方差不能误填到每个实维上;即使 BPSK 用复数数组承载,也遵循同一实维规则。
| dB、 | 每个实维的噪声方差 | ||
|---|---|---|---|
| 实数 BPSK | 1 | 0.2512 | 0.1256 |
| 复数 QPSK | 2 | 0.1256 | 0.0628 |
让八倍采样保持单位符号能量
取符号率 symbol/s、采样率 sample/s,每符号 个样本。BPSK 的符号为 ;QPSK 的 I、Q 分量各为 ,两者都满足 。
本例使用矩形脉冲:每个符号重复八次,但每个样本写成 。于是单个符号的离散能量 。接收端再用八个系数都为 的单位能量匹配滤波器求和抽样。白噪声经过这一投影后,每个实维的方差仍为 ,无需再人为乘八。
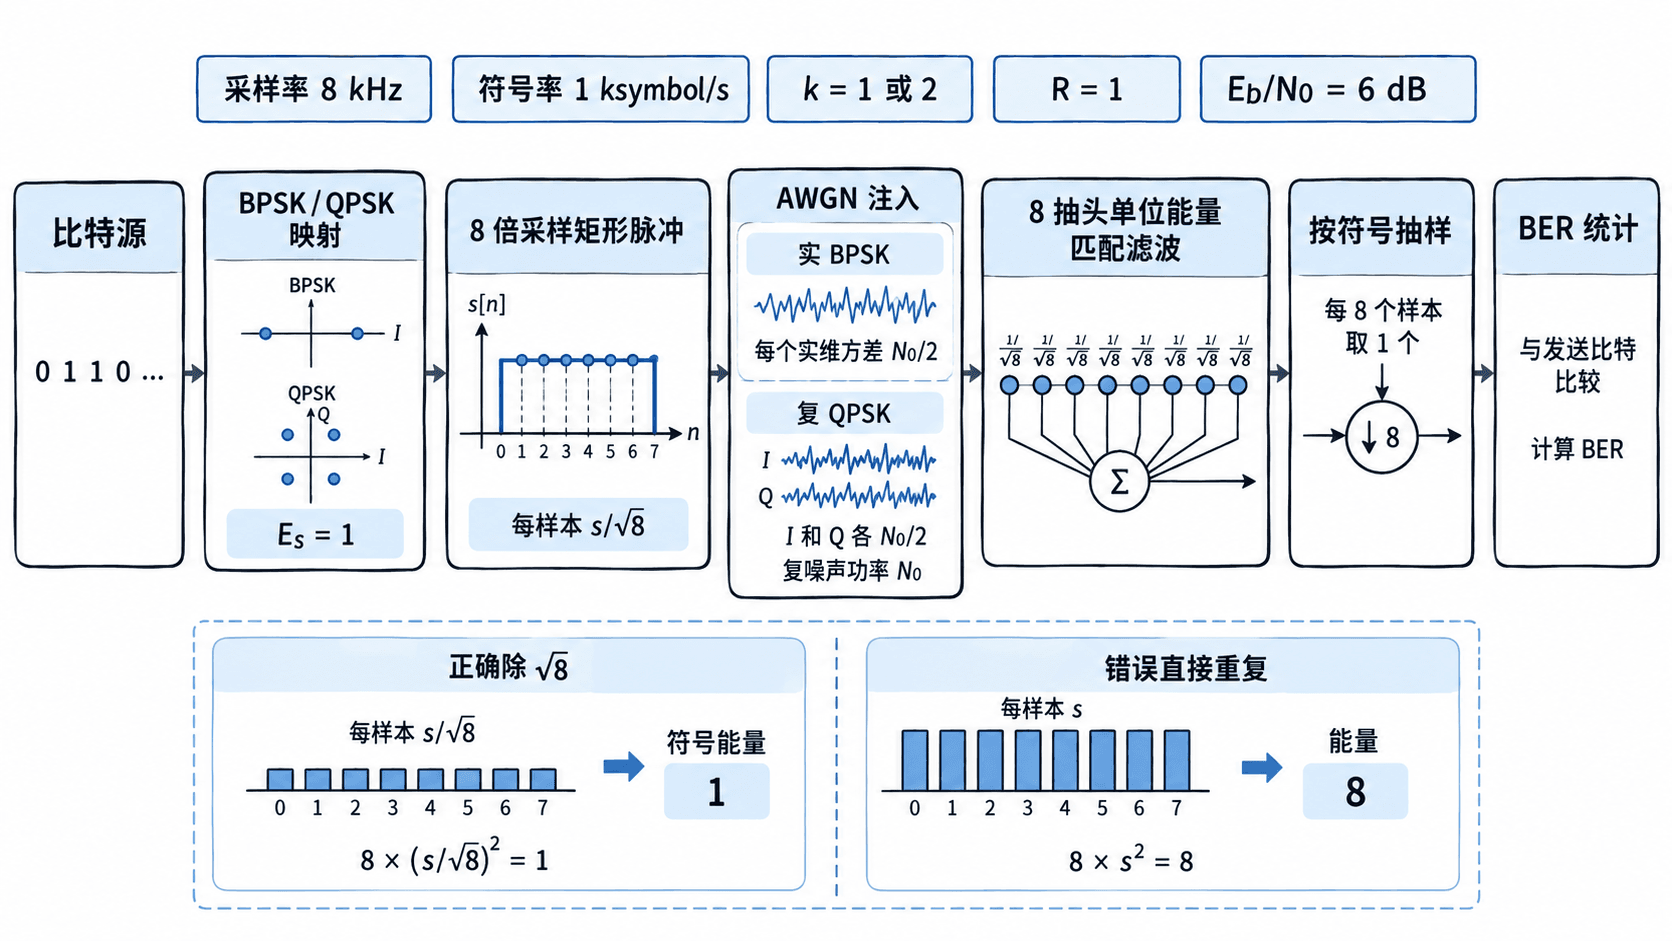
若直接把符号值重复八次、不除以 ,单符号离散能量就变成八倍;仍按 生成噪声,会让实际链路的 虚高约 dB。另一种按样本平均功率定义噪声的工具,必须同时代入采样数,不能只复制一个方差公式。
用同一脚本检查实数和复数链路
环境为 Python 3 与 NumPy。下面固定随机种子,发出各 200000 个符号,先按每符号八个单位能量样本加噪,再匹配滤波和硬判决;QPSK 每符号对应两个比特。
import numpy as np

rng = np.random.default_rng(2026)
ebn0_db = 6.0
gamma = 10 ** (ebn0_db / 10)
sps = 8
count = 200_000

for name, k in [("BPSK", 1), ("QPSK", 2)]:
    bits = rng.integers(0, 2, size=(count, k))
    if k == 1:
        symbols = (1 - 2 * bits[:, 0]).astype(float)
    else:
        symbols = ((1 - 2 * bits[:, 0]) +
                   1j * (1 - 2 * bits[:, 1])) / np.sqrt(2)

    # 矩形脉冲与接收求和滤波器均采用单位能量归一化。
    waveform = np.repeat(symbols, sps) / np.sqrt(sps)
    n0 = 1 / (k * gamma)  # 此例 Es=1、编码率 R=1。
    sigma = np.sqrt(n0 / 2)

    if k == 1:
        noise = rng.normal(0, sigma, waveform.size)
        variance = np.var(noise)
    else:
        noise = (rng.normal(0, sigma, waveform.size) +
                 1j * rng.normal(0, sigma, waveform.size))
        variance = np.var(noise.real)

    received = (waveform + noise).reshape(count, sps).sum(axis=1) / np.sqrt(sps)
    if k == 1:
        decided = (received < 0).astype(int)[:, None]
    else:
        decided = np.column_stack(
            (received.real < 0, received.imag < 0)
        ).astype(int)

    ber = np.mean(decided != bits)
    print(f"{name}: 实维方差={variance:.4f}, 目标={n0/2:.4f}, BER={ber:.4f}")
预期输出(固定种子;不同 NumPy 版本的末位可能略有差异):
BPSK: 实维方差=0.1257, 目标=0.1256, BER=0.0025
QPSK: 实维方差=0.0628, 目标=0.0628, BER=0.0024
用数值偏差判断错误位置
在相干硬判决、Gray 映射和理想 AWGN 条件下,两者的理论比特误码率均为 。统计存在随机波动,不要求每次恰好得到理论值;先核对实维方差,再看误码率是否落在约 0.0020~0.0028 的范围。
- 差约 3 dB:把复噪声的总功率 当成 I、Q 各自的方差,或在 QPSK 的 换算中漏掉 。
- 差约 9 dB:把八倍采样的矩形脉冲直接重复但没有重算 ,却沿用单位能量的噪声设置。
- 更换采样数后 BER 改变:逐段核对成形脉冲能量、接收滤波器系数平方和、抽样相位,以及加噪位于滤波器之前还是之后。
先关闭噪声,确保匹配滤波后的理想符号与发端一致;再开启噪声核对方差和误码率。这样能把标定错误与同步、信道畸变分开。