
通信工程 / 系统课时
把采样值编码为PCM比特流
把采样值编码为PCM比特流
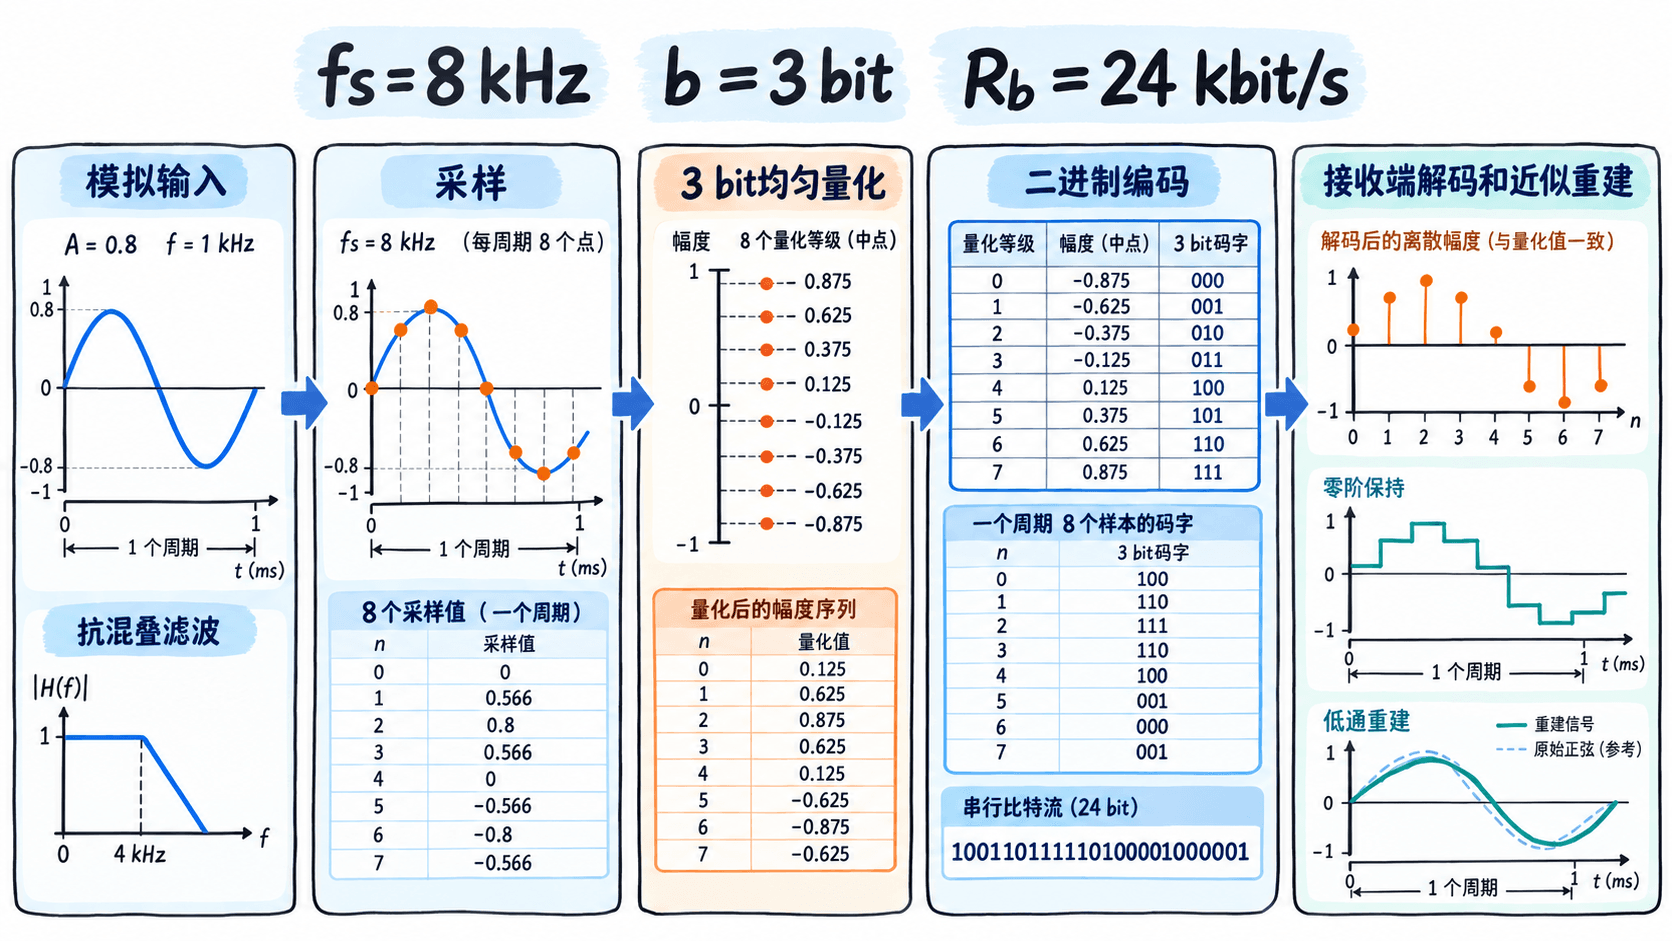
模拟信号经过采样和量化后,还需要转换成能够存储和传输的二进制码字。脉冲编码调制(PCM)把这些环节连接为完整的数字表示过程。本篇使用 8 kHz 采样率和 3 位均匀量化构建最小 PCM 示例,得到实际比特流、计算码率,再从码字恢复近似采样波形。
学习目标
- 说明 PCM 中采样、量化、二进制编码、解码和波形重建的顺序与作用。
- 使用 Python 把连续时间信号的采样值转换为 PCM 比特流,并解码恢复量化幅度。
- 根据采样率、量化位数和声道数计算原始 PCM 码率,区分理想重建与量化失真。
PCM 如何把波形变成比特
PCM 是 Pulse Code Modulation 的缩写,中文为脉冲编码调制。它把模拟信号在离散时刻的幅度转换成固定长度的二进制码字。接收端依照同一量化规则进行反向映射,获得近似采样值。
对于一个最高有效频率低于 4 kHz 的模拟信号,可以选择 8 kHz 采样率。实际系统需要在采样前通过抗混叠低通滤波器限制带宽,防止高于奈奎斯特频率的成分折叠到基带。
一条基础 PCM 链路包含以下处理:
- 抗混叠滤波:限制模拟输入频带,避免采样产生混叠。
- 采样:每隔 秒取一次幅度。8 kHz 采样率对应 0.125 ms 的采样间隔。
- 量化:把采样幅度映射到有限个离散等级,例如 3 位对应 8 个等级。
- 编码与传输:将每个量化等级转换成固定长度的二进制码字,再按规定顺序排列为比特流。
- 解码与重建:接收端将码字还原为量化幅度,经过数模转换及低通重建滤波获得近似连续波形。
本篇使用中升型均匀量化器,输入幅度范围为 ,每个区间用中点幅度重建。码字采用无符号偏移二进制索引:最低量化等级编码为 000,最高等级编码为 111。
用 Python 完成编码与解码
下面构造一个幅度为 0.8、频率为 1 kHz 的正弦信号,以 8 kHz 采样率获取 8 个采样值,正好覆盖一个完整周期对应的采样数据。为了使码字容易阅读,示例故意只使用 3 位量化。
量化区间固定为 ,因此量化步长为 。编码器先计算区间索引,再把索引格式化为 3 位二进制字符串;解码器根据索引恢复该区间的中点幅度。
代码使用 Python 3.9 或更新版本,只依赖标准库,可以直接运行。
import math

fs = 8000
f_signal = 1000
bits = 3
levels = 1 << bits
step = 2.0 / levels

samples = [0.8 * math.sin(2 * math.pi * f_signal * n / fs) for n in range(8)]

def encode(value):
    # 使用无符号偏移二进制索引,对超出量化范围的输入进行饱和处理。
    index = math.floor((value + 1.0) / step)
    return max(0, min(levels - 1, index))

codes = [encode(value) for value in samples]
bit_groups = [format(code, f"0{bits}b") for code in codes]
decoded = [-1.0 + (code + 0.5) * step for code in codes]

# 重复每个量化值4次模拟零阶保持,并不等同于模拟低通重建。
held = [value for value in decoded for _ in range(4)]

print("编码:", " ".join(bit_groups))
print("重建采样:", [round(value, 3) for value in decoded])
print("保持段:", [round(value, 3) for value in held[:8]])
print("码率:", fs * bits, "bit/s")
预期输出:
编码: 100 110 111 110 100 001 000 001
重建采样: [0.125, 0.625, 0.875, 0.625, 0.125, -0.625, -0.875, -0.625]
保持段: [0.125, 0.125, 0.125, 0.125, 0.625, 0.625, 0.625, 0.625]
码率: 24000 bit/s
输出中,每组 3 位代表一个采样值,空格只是为了方便人工阅读。实际连续比特流为 100110111110100001000001,总共 24 位。接收端只有知道量化位数、码字起点和映射规则,才能正确分组并解码。
例如第一个采样值是 0,对应区间索引 4,编码为 100,解码后得到 0.125;第三个采样值是 0.8,对应索引 7,编码为 111,解码后得到 0.875。这说明 PCM 解码恢复的是量化等级对应的幅度,而不是精确的原始采样值。
计算PCM比特率与数据量
对于固定长度编码的线性 PCM,忽略帧头、网络协议、纠错及其他封装开销,原始码率由采样率、每采样位数和声道数决定:
其中 是每个声道每秒的采样数, 是每个采样值的量化位数, 是声道数。
| 采样配置 | 原始 PCM 码率 | 1 秒数据量 |
|---|---|---|
| 8 kHz、3 bit、单声道 | 24 kbit/s | 3000 B |
| 8 kHz、8 bit、单声道 | 64 kbit/s | 8000 B |
| 8 kHz、8 bit、双声道 | 128 kbit/s | 16000 B |
| 48 kHz、16 bit、双声道 | 1536 kbit/s | 192000 B |
在本例中,每秒有 8000 个采样值,每个采样值编码为 3 位,因此码率为 24000 bit/s。8 个采样码字合计 24 位,对应 1 ms 的采样数据。码字固定长度并不意味着数据一定按字节边界对齐:3 位样本在实际封装时,必须规定跨字节打包和解包方式。
如果将位数改为 8 位,同时保持 8 kHz 单声道,原始码率增加到 64 kbit/s。位数提高通常可以减小量化误差,但每秒产生的数据量也随之增加。
检查重建波形为什么不完全相同
PCM 接收端首先从码字恢复量化等级,再根据量化表还原幅度。代码中得到的 decoded 就是重建采样序列,它与 samples 一一对应,但数值不完全相同。
由于采用中升型量化,零输入位于两个相邻重建等级的边界上,按照本例的索引规则被映射到正侧中点 0.125。这不是程序计算错误,而是量化器类型和边界规则共同决定的结果。若改用包含零重建等级的中平型量化器,零输入的结果和整张码表都会改变。
held 把每个重建样本重复 4 次,只用于直观模拟零阶保持的台阶效果。真实的数模转换器按照采样周期输出保持电平,再由模拟重建滤波器抑制采样镜像频率成分。低通滤波能够平滑台阶,却不能准确恢复量化时已经丢失的幅度细节。
验证这条链路时,可以检查三个条件:
- 编码与解码使用同样的位数、量化范围及码字映射,解码后的样本数必须等于编码前的样本数。
- 在没有过载的前提下,本例每个重建样本与原始采样值之间的误差绝对值不应超过 。
- 原始信号必须满足采样带宽要求。对于 8 kHz 采样率,1 kHz 正弦可以正常采样;但如果输入存在高于 4 kHz 的频率成分,且未经过适当抗混叠滤波,就可能发生混叠,增加量化位数也无法修复。
这条最小链路已经覆盖了 PCM 的基本工作过程:采样决定时间分辨率,量化位数决定幅度等级数量,编码规则决定码字如何表示与解析,重建滤波则负责将离散采样转换为近似连续信号。实际音频系统还需要进一步明确样本格式、声道排列、字节序与容器封装。