
通信工程 / 系统课时
仿真BPSK误码率并校验理论曲线
仿真BPSK误码率并校验理论曲线
用固定随机种子生成 BPSK 比特,在多个 下加入高斯噪声并逐位计错,再把仿真 BER 与相干判决理论值画在同一张半对数图上。通过改变统计比特数,还能判断高信噪比处曲线为何会抖动。
学习目标
- 将以 dB 表示的 换算成正确的 AWGN 噪声标准差。
- 运行完整的 BPSK 误码率仿真,得到数值和半对数曲线。
- 依据实际错误数与理论概率,识别抽样波动和模型错误。
先把信噪比对应到噪声强度
采用匹配滤波后的实数判决模型:比特 0 映射为 -1,比特 1 映射为 +1,每比特判决一次,平均比特能量 。信道输出为 ,噪声满足 ;接收端以 0 为门限, 判为 1,否则判为 0。这里模拟的是理想同步后的判决采样值,不涉及载波同步或过采样。
若给定的 dB 数值为 ,先求线性比值 。由 可得 ,因此一维高斯噪声的标准差为 。standard_normal 生成的是标准差为 1 的噪声,必须乘以 ;把方差 直接作为乘数会使曲线偏离理论值。
理想相干 BPSK 的理论 BER 为 。例如 0 dB 时约为 0.07865,8 dB 时约为 0.0001909,这两个值适合用于快速校验。
生成比特、判决并绘制曲线
使用 Python 3.10+,安装 NumPy 和 Matplotlib(命令为 python -m pip install numpy matplotlib)。把下列程序保存为 bpsk_ber.py,执行 python bpsk_ber.py。每个信噪比点发送 100 万比特;固定随机种子便于重复实验。
import math
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

rng = np.random.default_rng(2026)
snr_db = [0, 2, 4, 6, 8]
n_bits = 1_000_000
measured, theoretical = [], []

for db in snr_db:
    gamma = 10 ** (db / 10)
    sigma = math.sqrt(1 / (2 * gamma))
    bits = rng.integers(0, 2, n_bits, dtype=np.int8)
    symbols = 2 * bits - 1
    # AWGN 的实数判决噪声方差为 N0/2。
    noisy = symbols + sigma * rng.standard_normal(n_bits)
    wrong = (noisy >= 0) != bits
    errors = int(np.count_nonzero(wrong))
    ber = errors / n_bits
    theory = 0.5 * math.erfc(math.sqrt(gamma))
    measured.append(ber)
    theoretical.append(theory)
    print(f"{db:2d} dB | errors={errors:6d} | BER={ber:.6e} | theory={theory:.6e}")
    if db == 8:
        # 比较同一组误码样本的不同统计长度。
        for n in (10_000, 100_000, n_bits):
            print(f"  first {n:7d} bits: {int(np.count_nonzero(wrong[:n]))} errors")

plt.semilogy(snr_db, theoretical, label="Theory", linestyle="--")
plt.semilogy(snr_db, measured, "o-", label="Monte Carlo")
plt.xlabel("Eb/N0 (dB)")
plt.ylabel("BER")
plt.ylim(1e-5, 1)
plt.grid(True, which="both")
plt.legend()
plt.tight_layout()
plt.savefig("bpsk_ber.png", dpi=160)
预期输出(以下为 NumPy 2.3.x 的一次参考运行,其他版本的随机误码计数可能略有不同):
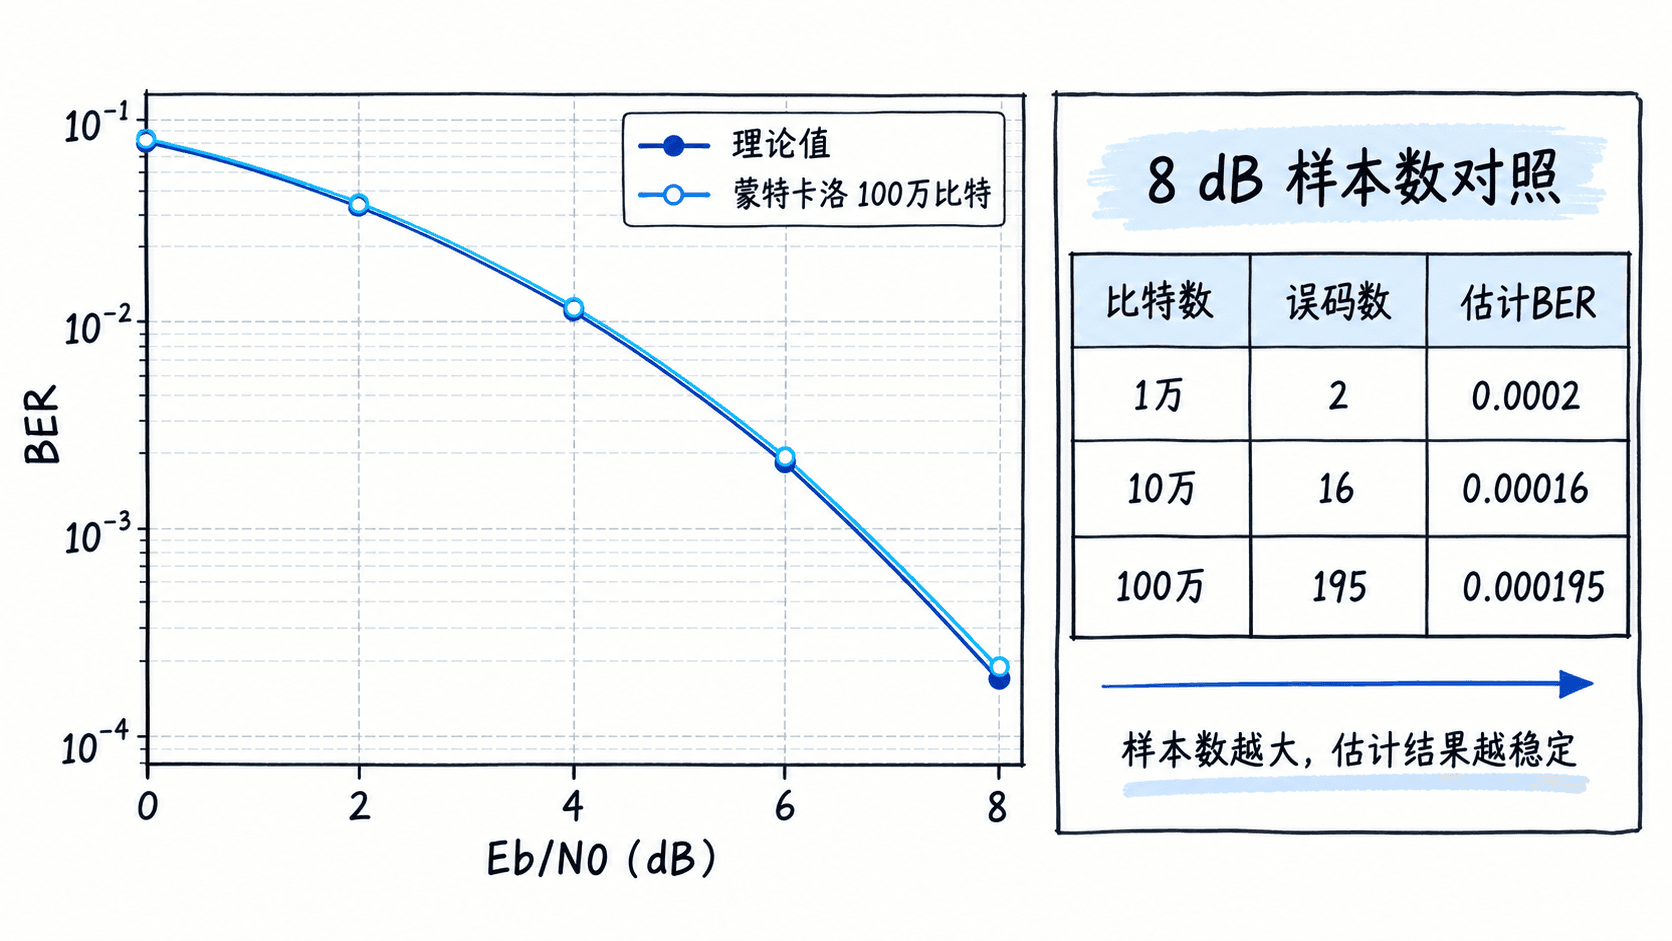
 0 dB | errors= 79163 | BER=7.916300e-02 | theory=7.864960e-02
 2 dB | errors= 37413 | BER=3.741300e-02 | theory=3.750613e-02
 4 dB | errors= 12459 | BER=1.245900e-02 | theory=1.250082e-02
 6 dB | errors=  2404 | BER=2.404000e-03 | theory=2.388291e-03
 8 dB | errors=   195 | BER=1.950000e-04 | theory=1.909078e-04
  first   10000 bits: 2 errors
  first  100000 bits: 16 errors
  first 1000000 bits: 195 errors
程序还会在当前工作目录写出 bpsk_ber.png。图的横轴为 (dB),纵轴为对数 BER;理论曲线应平滑下降,蒙特卡洛点围绕理论值小幅波动。
用错误数判断样本量是否够用
8 dB 的理论 BER 约为 。在 1 万比特中期望仅有约 1.9 次误码,因此统计结果容易跳变。本次运行截取的前 1 万、10 万和 100 万比特分别出现 2、16、195 次错误,对应 BER 为 、 和 。增大样本量会减小统计波动,但不保证每次都单调逼近理论曲线。
若某个高信噪比点观测到 0 次错误,只能记录“本次 0/N”,不能断言真实 BER 为零。零误码时 95% 置信上界粗略为 ;若目标 BER 是 ,想观察约 100 次错误就需要大约 比特。
曲线异常时怎样定位
若全部点显著高于理论曲线,优先检查噪声系数是否为 、发送符号是否确实为 ,以及阈值是否为 0。实数 BPSK 不应额外叠加未经换算的复数 I/Q 噪声。
如果 BER 随信噪比升高反而增大,检查发送映射 2 * bits - 1 和接收判决 (noisy >= 0) 是否互为逆操作;若 BER 比理论值低很多,确认分母用的是发送比特数 n_bits,而不是误码数或循环次数。先在 0 dB 和 8 dB 对照理论值,再决定是否增加样本量。