
通信工程 / 系统课时
用匹配滤波提高采样信噪比
用匹配滤波提高采样信噪比
接收端收到的一个 BPSK 基带符号往往横跨多个含噪采样点,只取其中一点会丢掉其余样本携带的信号能量。本课用每符号 8 点的矩形脉冲构造匹配滤波器,在正确时刻采样,并用相同噪声数据比较滤波前后的误码率。
学习目标
- 根据已知发送脉冲写出离散匹配滤波器及采样位置。
- 运行 AWGN 实验,比较单点采样与匹配滤波后的判决误码率。
- 说明信噪比增益的计算条件,以及为什么不能把它理解成免费提高链路性能。
单点采样为什么容易误判
考虑实数基带等效 BPSK:比特 0 映射为 -1,比特 1 映射为 +1,每个符号保持 8 个采样点。记每符号采样数为 ,脉冲 在 取 1,其余为 0。接收信号是发送波形加独立零均值高斯噪声,单点噪声标准差设为 。
如果每个符号只读取最后一个采样点 ,信号幅度为 ,叠加的噪声标准差仍是 1.2。一次较大的噪声扰动就可能让样本跨过零判决门限。其余 7 个采样点虽然含有相同符号,却没有参与判决。
这里的“滤波前”特指直接使用符号末尾单个样本,而不是拿连续波形功率与离散判决变量进行不等价比较。
滤波器与最佳采样位置
在已知脉冲、采样定时正确、噪声为白噪声的条件下,最大化指定采样时刻信噪比的离散匹配滤波器,是发送脉冲的共轭时间反转。采用单位判决幅度的归一化:
对于 8 点全 1 的实数矩形脉冲,,所以滤波器的 8 个抽头都是 。把接收样本卷积后,在 取样,恰好得到该符号 8 点的平均值;无噪声时仍为 ,不会因为求和改变判决阈值。
平均之后,独立噪声的方差由 变为 ,噪声标准差从 1.2 降为约 0.424。在这个每采样点噪声方差固定的离散模型里,采样信噪比增益是 。
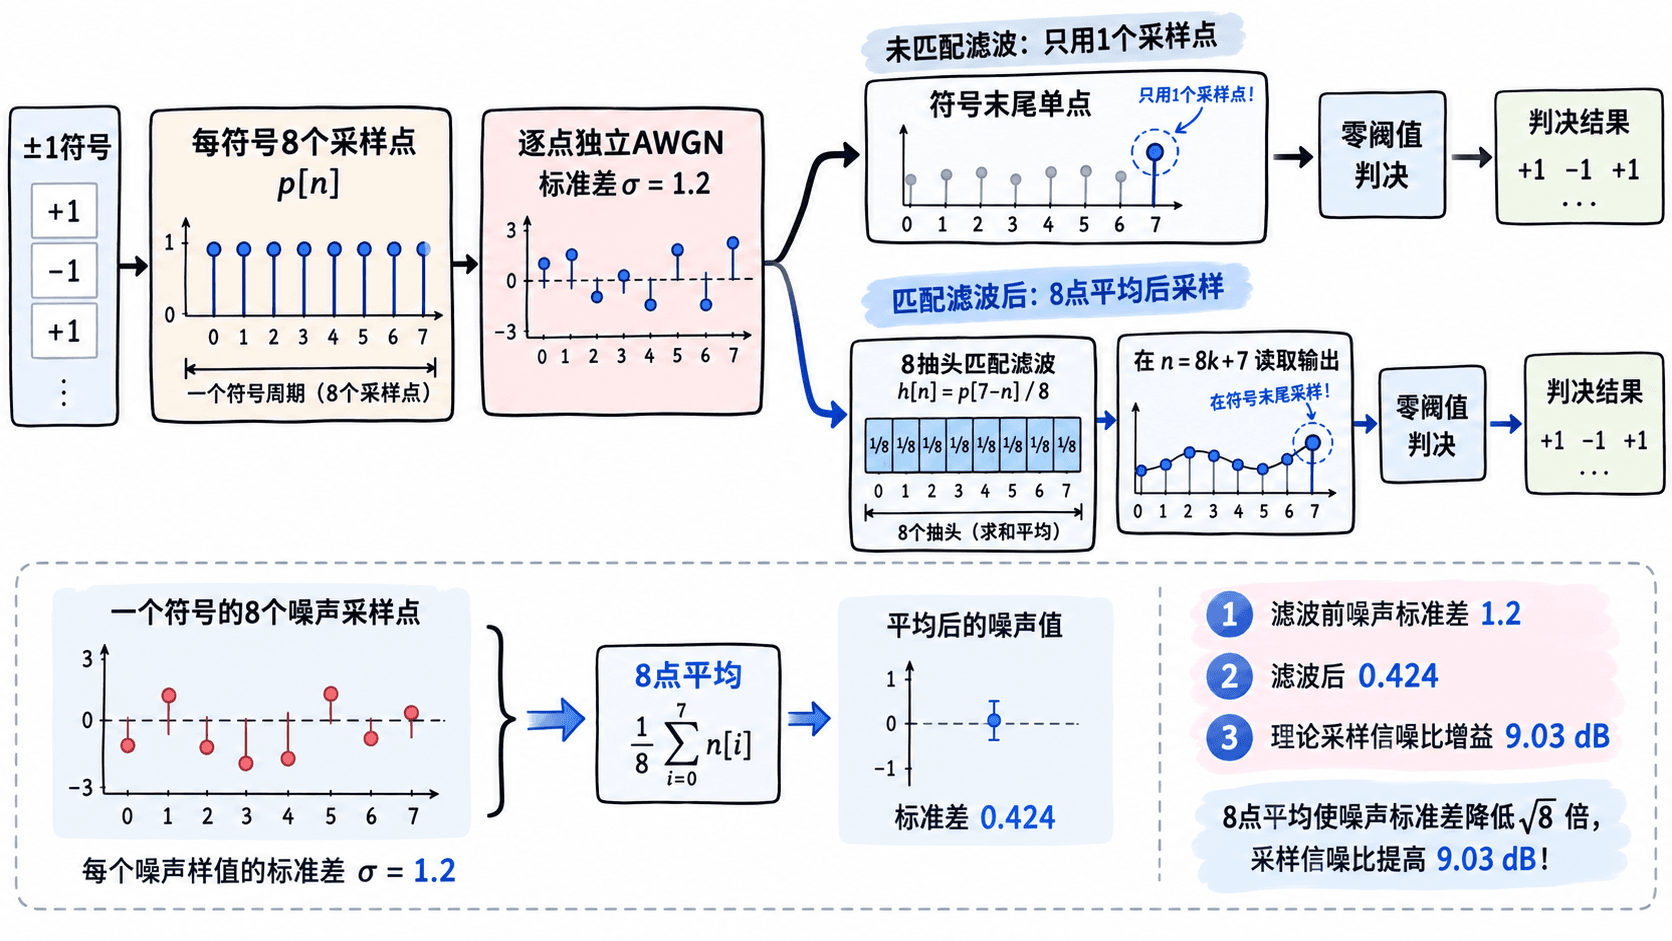
用同一段噪声比较误码率
使用 Python 3 和 NumPy。下列完整程序固定随机种子、发送 50000 个符号、设置每点噪声标准差为 1.2,然后让两条接收路径共享同一组含噪数据,避免把随机波动误当成滤波器增益。
import numpy as np

rng = np.random.default_rng(2026)
count, sps, noise_std = 50000, 8, 1.2
bits = rng.integers(0, 2, size=count)
symbols = 2 * bits - 1

# 每符号8个矩形脉冲样本,两种判决都接收同一组噪声
pulse = np.ones(sps)
tx = np.repeat(symbols, sps)
rx = tx + rng.normal(0, noise_std, tx.size)

# 时间反转并按脉冲能量归一化,输出幅度保持为±1
h = pulse[::-1] / np.dot(pulse, pulse)
filtered = np.convolve(rx, h, mode="full")

# 在每个符号的第8个采样点判决,统一使用零阈值
raw = rx[sps - 1::sps]
matched = filtered[sps - 1:rx.size:sps]
raw_ber = np.mean((raw >= 0) != bits)
matched_ber = np.mean((matched >= 0) != bits)

print(f"未滤波 BER: {raw_ber:.4f}")
print(f"匹配滤波 BER: {matched_ber:.4f}")
print(f"理论采样 SNR 增益: {10 * np.log10(sps):.2f} dB")
预期输出(固定随机种子及上述 NumPy 随机数生成器):
未滤波 BER: 0.2017
匹配滤波 BER: 0.0091
理论采样 SNR 增益: 9.03 dB
这里 BER 是错误符号数除以总符号数;本例每符号只携带 1 bit,因此也等于比特误码率。可以把 noise_std 改成 0.8 后重新运行,确认两条路径的 BER 都降低。不要仅比较个别符号是否出错,50000 次判决才更适合观察统计差异。
增益何时成立
还有三个边界要检查。首先,如果发送脉冲不再是 8 点矩形,就不能继续把 np.ones(8)/8 当成匹配模板,应替换为实际脉冲的共轭时间反转。其次,如果在 之外取样,滤波窗口可能混入相邻符号,增加码间干扰。最后,有色噪声或多径信道下,简单匹配滤波未必是完整接收机的最优处理,还需要考虑噪声白化或均衡。
在当前 AWGN 和已知定时的设定下,正确的脉冲模板、8 点能量合并、符号末端采样和零阈值判决构成一条可复现的最小接收链。