
通信工程 / 系统课时
比较量化位数与量化误差
比较量化位数与量化误差
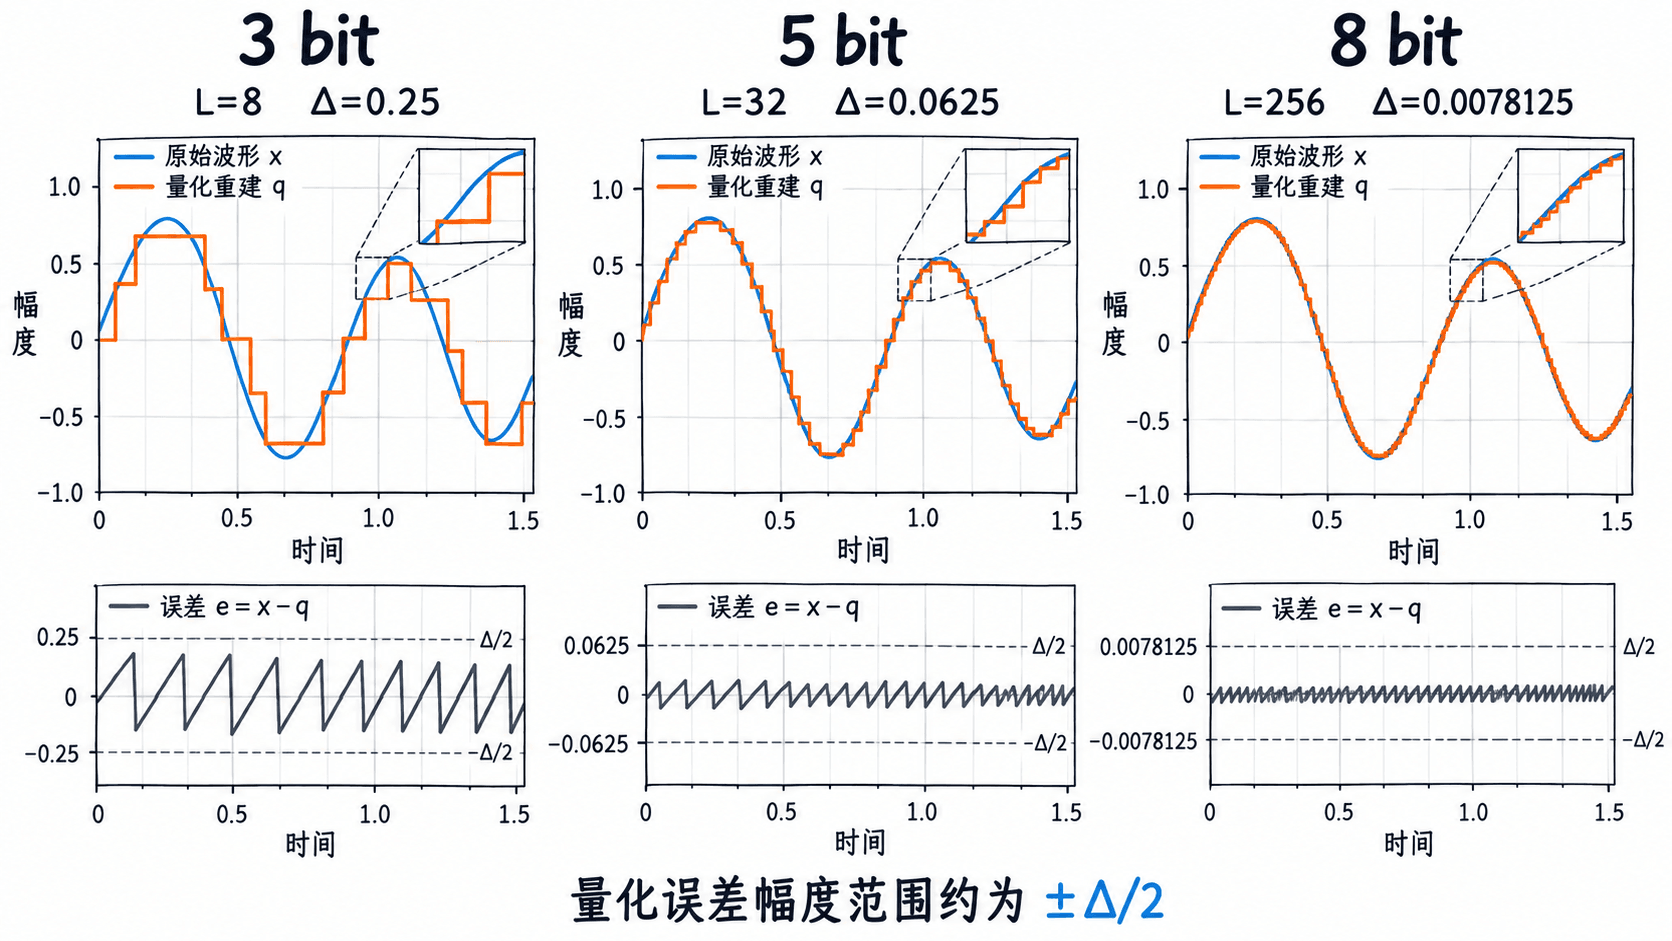
同一组信号采样值,使用不同量化位数会产生不同的幅度台阶和重建误差。本篇固定输入信号与量化范围,分别使用 3、5、8 位均匀量化,通过 Python 计算量化步长、均方误差与量化信噪比,观察位数增加带来的精度变化,并识别过载失真和低幅度信号中的特殊情况。
学习目标
- 根据量化位数计算量化等级数、量化步长和最大颗粒误差。
- 使用 Python 对同一采样序列进行不同位数的均匀量化,计算 MSE 和 SQNR。
- 解释量化位数与信噪比的关系,判断增加位数何时有效、何时无法解决失真。
先固定量化范围和判决规则
量化是把连续幅度的采样值映射为有限个离散等级的过程。比较不同位数时,必须保持输入信号、幅度范围和量化规则一致,否则测得的误差不能直接归因于位数变化。
假设输入已归一化,量化范围为 ,采用均匀量化。对于 位量化器,等级数与量化步长分别为:
| 量化位数 | 量化等级数 | 量化步长 | 最大颗粒误差幅度 |
|---|---|---|---|
| 3 bit | 8 | 0.25 | 0.125 |
| 5 bit | 32 | 0.0625 | 0.03125 |
| 8 bit | 256 | 0.0078125 | 0.00390625 |
这里使用中升型均匀量化器(mid-rise quantizer)。每个量化区间的中点作为重建值。若区间索引为 ,则重建幅度为:
例如输入 ,在 3 位量化下,量化步长为 0.25,对应区间索引 ,重建值为 0.125,误差 。在 5 位量化下,同一个输入映射为 0.09375,误差缩小到 0.00625。
对于范围内的输入,四舍五入到最近区间中点后,颗粒误差的绝对值不超过 。但输入超过量化范围时会发生饱和削顶,此时不再适用这个误差界限。
用 Python 比较三档量化结果
使用 Python 3.9 或更新版本即可运行下面的示例,只依赖标准库 math。实验生成 1000 个采样值,包含 7 个完整正弦周期,峰值幅度为 0.95。所有量化器共用 的量化范围,只改变位数。
为了定量比较,使用均方误差 MSE 衡量重建幅度与原始幅度的差异,并使用量化信噪比 SQNR 衡量信号功率与量化误差功率之比。
import math

samples = [0.95 * math.sin(2 * math.pi * 7 * n / 1000) for n in range(1000)]
signal_power = sum(v * v for v in samples) / len(samples)

def quantize(value, bits):
    levels = 1 << bits
    delta = 2.0 / levels
    # 饱和索引,避免输入越界产生不存在的量化码字。
    index = min(levels - 1, max(0, math.floor((value + 1.0) / delta)))
    return -1.0 + (index + 0.5) * delta

for bits in (3, 5, 8):
    levels = 1 << bits
    delta = 2.0 / levels
    # 固定输入序列,只改变每个样本可用的量化位数。
    decoded = [quantize(value, bits) for value in samples]
    mse = sum((a - b) ** 2 for a, b in zip(samples, decoded)) / len(samples)
    sqnr = 10 * math.log10(signal_power / mse)
    print(f"{bits} bit: L={levels}, Δ={delta:.6f}, MSE={mse:.8f}, SQNR={sqnr:.2f} dB")
预期输出:
3 bit: L=8, Δ=0.250000, MSE=0.00457518, SQNR=19.94 dB
5 bit: L=32, Δ=0.062500, MSE=0.00035134, SQNR=31.09 dB
8 bit: L=256, Δ=0.007812, MSE=0.00000494, SQNR=49.61 dB
实验中,3 位提升到 5 位,SQNR 提高约 11.15 dB;5 位提升到 8 位,提高约 18.52 dB。与此同时,MSE 明显下降。这里观察到的是指定采样序列和量化器下的实际结果,而不是直接套用理论公式得到的数值。
理解量化信噪比的变化规律
记原始采样序列为 ,量化重建序列为 ,量化误差为 。对于 个采样值,均方误差定义为:
以信号平均功率 和量化误差平均功率 计算 SQNR:
对于高分辨率、无过载、均匀量化的满幅正弦信号,且量化误差可近似视为均匀分布时,常用估算公式为:
它表示每增加 1 位,理论量化信噪比大约提高 6.02 dB。直观原因是量化步长减半,而在常用均匀误差模型下,误差功率约变为原来的四分之一。
这个公式不是所有输入信号的严格保证。上述实验的峰值只有满幅的 95%,且低位数量化误差可能与正弦信号相关,因此实际结果与公式存在差异。对于有限个采样值,增加位数也不保证每一个采样点的绝对误差都严格下降。
还应区分 SQNR 和包含真实信道噪声的 SNR。实验只引入量化误差,没有额外加入热噪声、干扰或者传输误码,因此不能把这里的 SQNR 直接当成完整通信链路的信噪比。
识别过载失真和位数选择的边界
提高位数通常可以降低范围内的颗粒误差,但不能代替合理的输入幅度设计。下面两种情况需要单独检查。
- 输入峰值过大:将实验中的幅度 0.95 修改为 1.2,部分采样值超过量化范围,索引被限制在最小或最大等级。即使增加到 8 位,削顶失真仍然存在。
- 输入幅度过小:将幅度修改为 0.1,信号只使用靠近零点的少量量化等级。由于量化步长相对于信号幅度较大,SQNR 通常低于接近满幅时的结果。
在真实系统中,可以分别调整模拟输入增益、量化满量程以及位数。增益过低浪费量化动态范围;增益过高产生不可逆的削顶。合理做法是先确定允许的信号峰值及余量,再根据所需 SQNR 和码率预算选择位数。
最后还要考虑传输成本。对于每秒 8000 个采样值的单声道信号,每增加 1 个量化位,原始 PCM 码率就增加 8000 bit/s,即 8 kbit/s。因此,在满足失真指标后继续增加位数,应同时核算存储和传输开销。