
通信工程 / 系统课时
用汉明码纠正单比特错误
用汉明码纠正单比特错误
本课用偶校验汉明(7,4)码,把4位信息1011编码成7位码字,故意翻转其中一位,再借助伴随式确定出错位置并恢复原文。随后制造两位错误,观察普通单错纠正器为何可能误修;示例可用Python 3.10及以上版本运行。
学习目标
- 把4位数据放进汉明(7,4)码的正确位置,并求出3个校验位。
- 从接收码字计算伴随式,定位并修正一个翻转位。
- 复现双比特错误时的误纠正,说明纠错能力边界。
把信息位与校验位排进七个位置
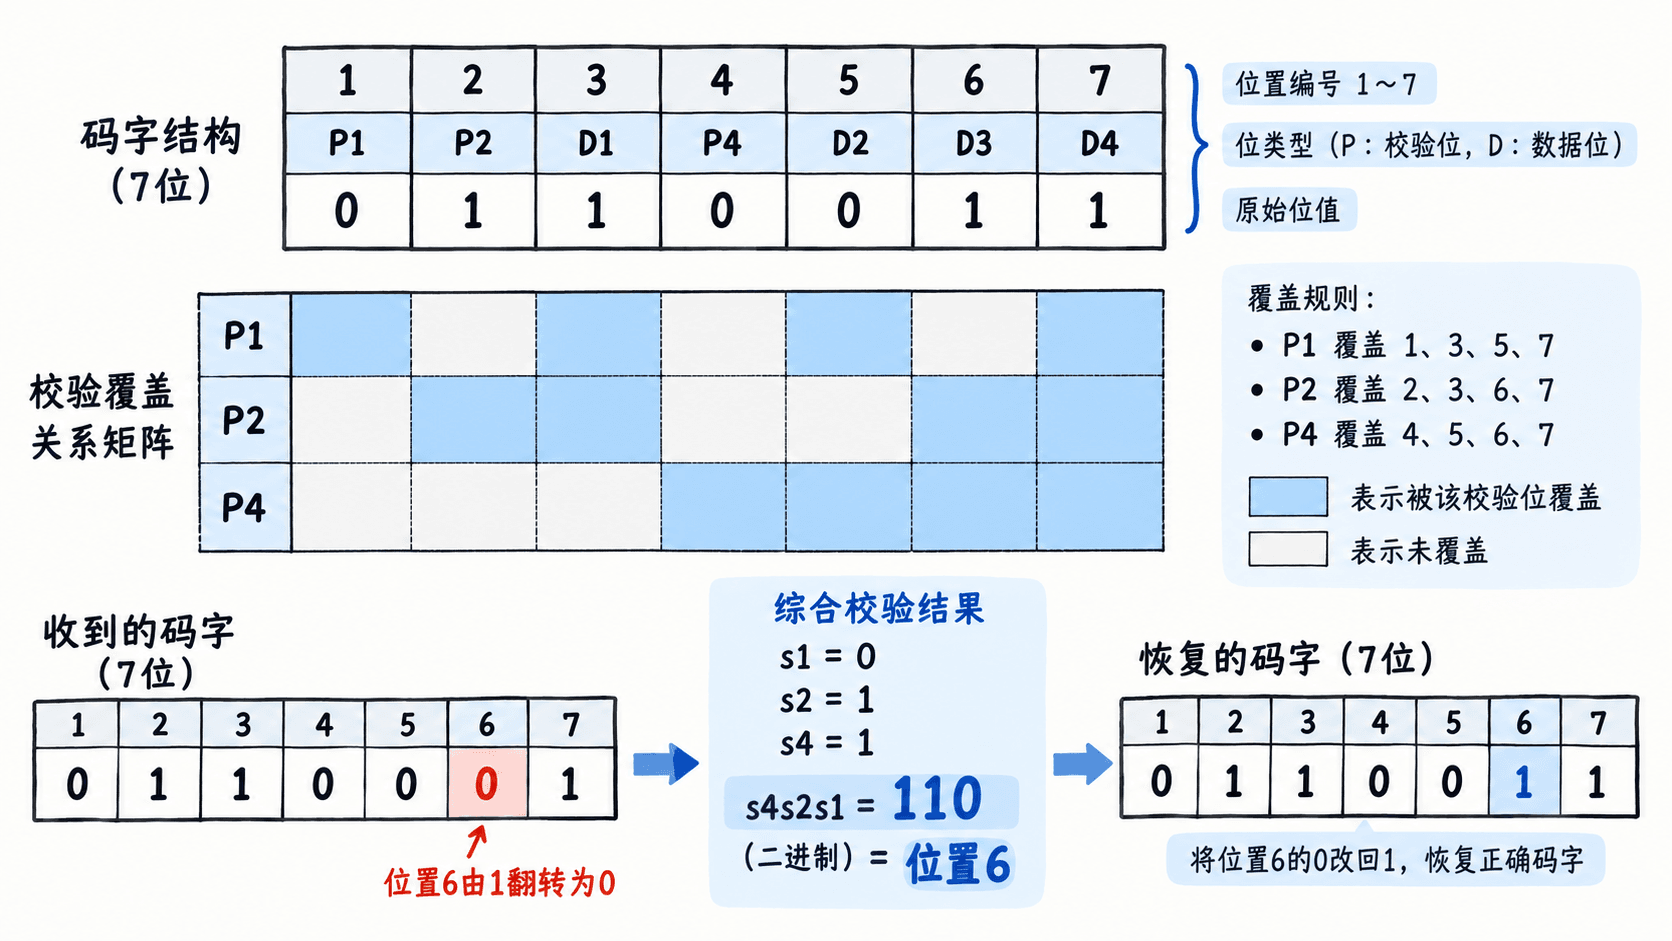
汉明(7,4)码包含4个信息位和3个校验位,码字位置从1编号到7。位置1、2、4用于校验,位置3、5、6、7依次存放信息位1、0、1、1。全部使用偶校验,即每组中1的数量必须为偶数。
P1覆盖位置1、3、5、7,求得0。P2覆盖位置2、3、6、7,求得1。P4覆盖位置4、5、6、7,求得0。
所以从位置1到7的编码结果为0110011。每个位置的二进制编号决定它参加哪些校验组:例如位置6是二进制110,同时被P2与P4覆盖,不被P1覆盖。
用伴随式找到翻转位置
假设传输时第6位从1变成0,收到0110001。重新计算三组偶校验的结果分别为:s1=0、s2=1、s4=1。把它们按(s4,s2,s1)的顺序拼成110,作为二进制数就是十进制6。
因此翻转接收码字的第6位,可以恢复0110011;提取位置3、5、6、7便得到原信息1011。这里不能把伴随式的三位从左往右当作位置1、2、4:它们对应的是权重4、2、1。伴随式为000只表示三个校验式均通过,不保证没有多位错误。
用Python执行编码与纠正
下面的代码用长度8的列表让下标直接等于码字位置,索引0不参加编码。syndrome把未通过校验的权重相加,得到单错译码器认定的位置。
GROUPS = {
    1: (1, 3, 5, 7),
    2: (2, 3, 6, 7),
    4: (4, 5, 6, 7),
}

def encode(data: str) -> list[int]:
    if len(data) != 4 or any(bit not in "01" for bit in data):
        raise ValueError("need exactly four binary digits")
    code = [0] * 8
    for position, bit in zip((3, 5, 6, 7), map(int, data)):
        code[position] = bit
    # 偶校验:覆盖位置的异或结果必须为0
    for parity_position, covered in GROUPS.items():
        code[parity_position] = sum(code[i] for i in covered) % 2
    return code

def syndrome(code: list[int]) -> int:
    return sum(parity_position for parity_position, covered in GROUPS.items()
               if sum(code[i] for i in covered) % 2)

def correct_one(code: list[int]) -> tuple[list[int], int]:
    restored = code.copy()
    position = syndrome(restored)
    if position:
        restored[position] ^= 1
    return restored, position

def bits(code: list[int]) -> str:
    return "".join(map(str, code[1:]))

original = encode("1011")
single = original.copy()
single[6] ^= 1
fixed, single_position = correct_one(single)

double = original.copy()
for position in (3, 6):
    double[position] ^= 1
wrong, double_position = correct_one(double)

print("data:", "1011")
print("codeword:", bits(original))
print("single:", bits(single), "syndrome:", f"{syndrome(single):03b}",
      "position:", single_position, "corrected:", bits(fixed))
print("double:", bits(double), "syndrome:", f"{syndrome(double):03b}",
      "position:", double_position, "decoded:", bits(wrong),
      "matches original:", wrong == original)
预期输出:
data: 1011
codeword: 0110011
single: 0110001 syndrome: 110 position: 6 corrected: 0110011
double: 0100001 syndrome: 101 position: 5 decoded: 0100101 matches original: False
双比特错误的边界
汉明(7,4)码的最小码距为3,因此能保证纠正任意一个比特错误。但如果同时翻转位置3和6,伴随式变为101,单错译码器会误认为第5位出错,再翻转一次,结果反而与原码字不同。
普通汉明(7,4)码仅靠伴随式不能区分“一位错误”和“两位错误”。若系统必须区分这两种情况,可增加一位全局偶校验,改用扩展汉明(8,4)的SECDED(单错纠正、双错检出)方案。它可以报告双错,但不能保证修复双错;发生该类错误时应丢弃数据块或请求重传。