
游戏客户端架构 / 系统课时
制定组件架构演进规则
制定组件架构演进规则
组件化重构完成后,新的需求仍可能把直接调用、全局查询和共享可变状态重新带回来。本课将组件边界、依赖方向、消息契约、配置归属和性能观测写成可审查的规则,并用一段轻量检查脚本演示怎样在合并代码前发现回退。
学习目标
- 为组件职责、依赖方向、通信方式和配置状态划出可执行边界。
- 使用结构清单检查违规依赖、字段混用和逐帧查询。
- 建立包含契约测试、性能基线和例外审批的变更流程。
先固定不能随需求漂移的边界
规则要能回答“谁负责、谁可以依赖谁、违反后如何发现”,不能只写“保持低耦合”。以下是一组可按项目调整的基础约束。
| 范围 | 约束 | 主要检查方式 |
|---|---|---|
| 组件职责 | 一个组件只拥有一类能力及其运行状态;避免巨型组件与只转发调用的伪组件 | 设计评审、变更影响检查 |
| 依赖方向 | 基础规则层不依赖玩法或表现层;表现层不能直接引用玩法实现;禁止循环依赖 | 依赖清单与静态检查 |
| 通信契约 | 一对一同步操作优先显式能力接口;一对多状态通知用具名事件,并规定载荷与解绑时机 | API 评审、事件契约测试 |
| 数据归属 | 只读模板保存默认配置;实例持有血量、冷却等可变状态;临时缓存不得写回共享模板 | 配置审查、双实例测试 |
| 热路径 | 每帧逻辑不做反复层级查找;组件数不是性能结论,须看真实耗时和分配 | 性能采样与对比 |
例如 Attack 依赖稳定的 DamageRules 能力,而 Health 发布 health.changed 供 HUD 订阅。HUD 不应为了刷新文本去穿透访问 Health 的内部字段。事件名、载荷字段、是否允许重入与谁负责解绑,都应写在同一份契约中。
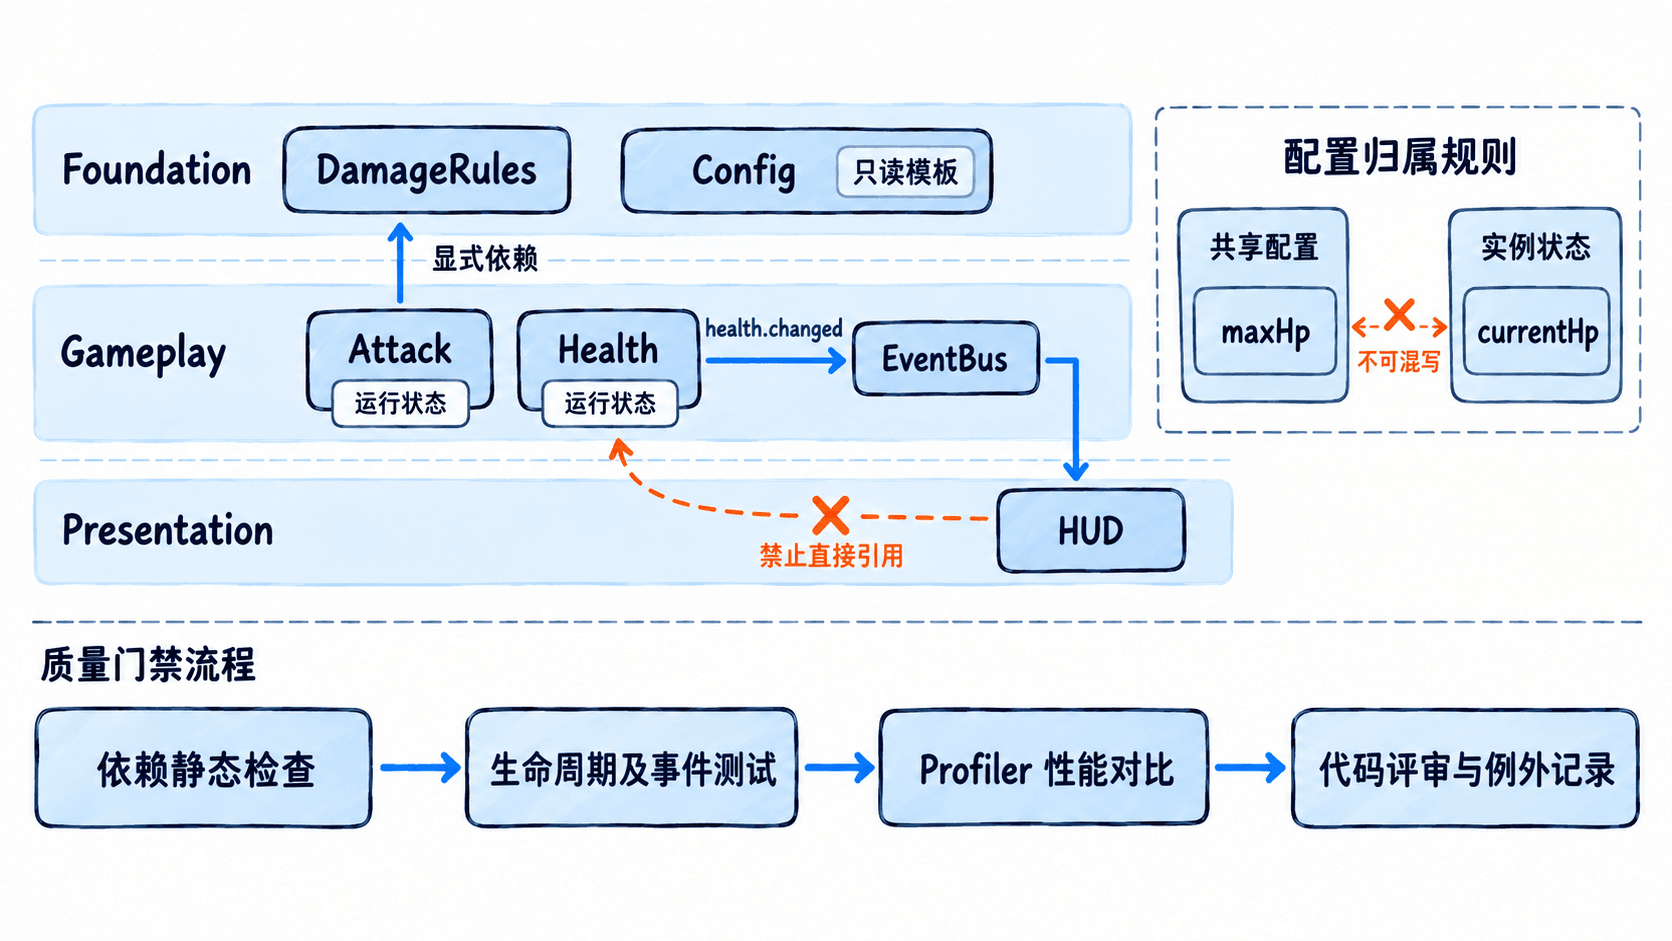
用结构清单阻止常见回退
不必等待一个完整的架构分析平台才能启动约束。下面的 Python 3 脚本将组件清单当作示例输入,检查依赖目标与层级、配置和实例字段交叉、逐帧查询以及事件发布者缺失。它不是 Unity、Unreal 或 Godot 的内置工具,实际项目需要从代码或资产导出这份清单,避免手写清单与实现脱节。
from copy import deepcopy

ALLOWED = {
    "foundation": set(),
    "gameplay": {"foundation", "gameplay"},
    "presentation": {"foundation", "presentation"},
}

def spec(layer, deps=(), config=(), runtime=(), queries=0,
         emits=(), listens=()):
    return {
        "layer": layer, "deps": list(deps),
        "config": set(config), "runtime": set(runtime),
        "queries": queries, "emits": list(emits),
        "listens": list(listens),
    }

components = {
    "DamageRules": spec("foundation", config=("baseDamage",)),
    "Attack": spec("gameplay", deps=("DamageRules",),
                   runtime=("cooldownMs",)),
    "Health": spec("gameplay", config=("maxHp",),
                   runtime=("currentHp",), emits=("health.changed",)),
    "Hud": spec("presentation", runtime=("visibleHp",),
                listens=("health.changed",)),
}

def has_cycle(items):
    state = {}

    def visit(name):
        if state.get(name) == 1:
            return True
        if state.get(name) == 2:
            return False
        state[name] = 1
        for dep in items[name]["deps"]:
            if dep in items and visit(dep):
                return True
        state[name] = 2
        return False

    return any(visit(name) for name in items)

def check(items):
    errors = []
    topics = {topic for item in items.values() for topic in item["emits"]}
    for name, item in items.items():
        for dep in item["deps"]:
            if dep not in items:
                errors.append(f"{name}:未知依赖 {dep}")
            elif items[dep]["layer"] not in ALLOWED[item["layer"]]:
                errors.append(f"{name}:禁止依赖 {dep}")
        if item["config"] & item["runtime"]:
            errors.append(f"{name}:配置与状态字段重叠")
        if item["queries"] > 0:
            errors.append(f"{name}:禁止逐帧查询组件")
        for topic in item["listens"]:
            if topic not in topics:
                errors.append(f"{name}:缺少事件发布者 {topic}")
    if has_cycle(items):
        errors.append("存在循环依赖")
    return errors

assert not check(components)
print("基线规则:通过")

broken = deepcopy(components)
broken["Hud"]["deps"].append("Health")
broken["Hud"]["queries"] = 1
print("违规变更:" + ";".join(check(broken)))
预期输出:
基线规则:通过
违规变更:Hud:禁止依赖 Health;Hud:禁止逐帧查询组件
脚本把违规变更变成可复现的失败信号,但只检查清单声明,不能证明组件职责合理、配置资产实际只读,或事件已经正确解绑。后者仍依赖代码审查、双实例隔离测试和生命周期回归测试。
为性能建立可比较的基线
性能规则不能简化为“组件超过某个数量就不准合并”。应在相同场景、平台、设备、采样时长和 NPC 数量下比较改动前后,并记录至少以下指标:
- 主线程帧耗时及其高分位值,区分总帧耗时与组件更新耗时。
- 高频组件的调用次数、层级查找次数,以及每帧分配量。
- 事件发布频率、实际回调次数、启停后订阅者数量。
- 生成、停用、销毁和对象池复用时的峰值耗时与残留对象数量。
阈值由项目基线和目标设备预算决定,而非照搬一个通用常数。例如要求“每帧重复层级查询为零”是适合静态门禁的工程约束;“每帧必须低于多少毫秒”则要基于目标帧率、已有负载和采样结果确定。记录测试场景与采样方法,否则两次数据不能直接比较。
把规则变成可执行的变更流程
一次组件变更应留下足够的审查证据,而不是只提交通过编译的代码。
- 提交变更说明:列出组件职责、拥有的运行状态、公开接口、依赖对象以及新增或调整的事件。
- 执行自动门禁:从真实工程生成依赖清单,运行规则检查;执行初始化、启停、销毁、重复订阅和配置实例隔离测试。
- 比较性能基线:对受影响的热路径附上同条件下的前后采样。若没有影响,也要明确不涉及逐帧或批量实例逻辑。
- 处理破例:对确需跨层依赖或缓存例外的改动,写明负责人、原因、影响范围、替代方案和复查条件,不允许无记录地跳过。
- 发布与回滚:涉及事件载荷或配置格式变更时,先安排消费者兼容和迁移测试,再删除旧契约;保留可回滚方案。
最终规则应跟代码一起版本管理,并在每次异常、性能回退或需求扩展后修订。能够被检查、能指明责任人且有例外处理办法的约束,才会真正约束后续开发。