
游戏客户端架构 / 系统课时
减少高频组件重复计算
减少高频组件重复计算
大量 NPC、HUD 与传感组件同时更新时,常见浪费不是算法本身太复杂,而是输入没有变化却每帧重算。本课把重复工作拆成更新节奏、脏标记和缓存失效三部分,做出既减少计算又能验证响应延迟的实现。
学习目标
- 识别哪些计算必须逐帧执行,哪些适合降频或按变化触发。
- 用变化通知、脏标记与分帧调度避免重复计算。
- 验证缓存正确性、更新延迟和峰值是否满足游戏需求。
先按时效性划分工作
角色运动与碰撞处理通常需要遵循对应的模拟步长;远处 NPC 的目标距离评估、威胁排序或非关键 UI 刷新则未必需要每一渲染帧都计算。先记录计算的消费者、输入来源和允许的最大延迟,再决定更新周期。
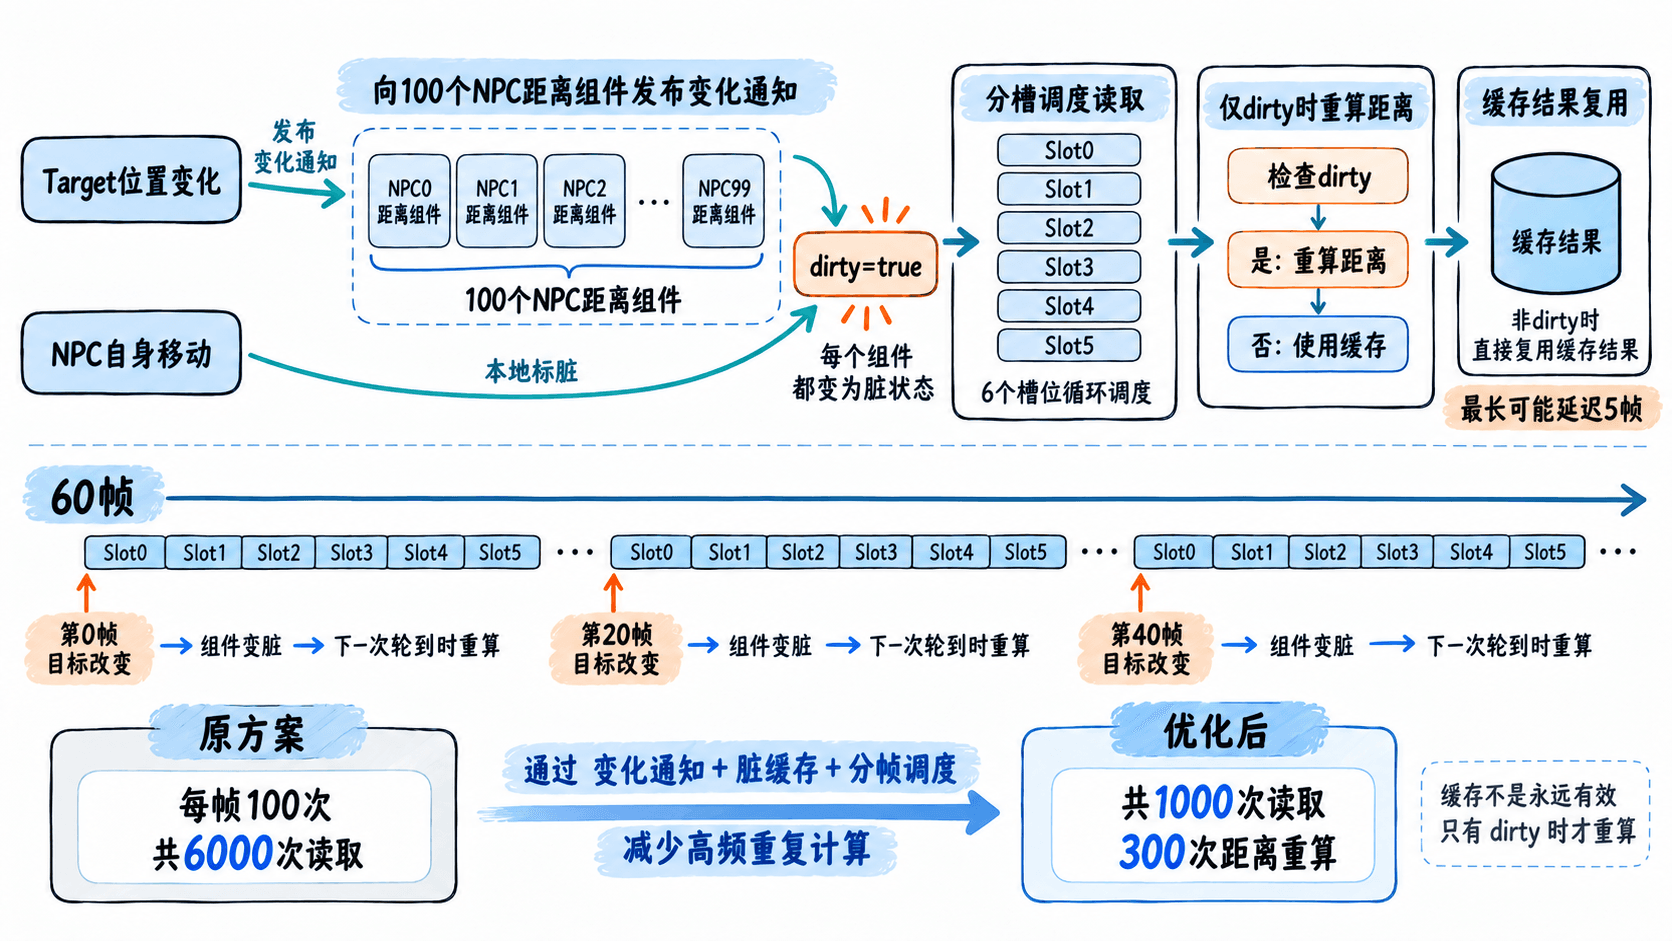
以 60 帧的观察窗口为例:100 个 NPC 每帧各做一次距离计算,会执行 6000 次。如果某项 AI 决策允许每 6 帧刷新一次,理论上只需 1000 次读取;若目标和 NPC 的位置都不变,距离结果还可以复用。
缓存必须知道何时失效
距离由 NPC 位置与目标位置共同决定。只缓存返回值却不跟踪输入变化,会让角色移动后继续使用旧结果。正确规则是:首次读取重算;任一位置变化时标记 dirty;下次读取重算一次,然后复用到下一次变化。
变化通知可以把“发现数据变了”的工作从每帧轮询移到事件发生时。调度器再把 NPC 分配到不同时间槽,避免所有对象都在同一帧执行重算。两种手段分别解决无效重复与同帧尖峰,不能相互替代。
实现分槽读取与脏标记
下面的 Python 3 程序使用 100 个位置固定的 NPC、一个会在第 0、20、40 帧移动的目标,以及 6 个轮转更新槽。事件只标脏,距离计算推迟到该 NPC 下次被调度时;NPC 自身移动时也提供了失效入口。
class Target:
    def __init__(self):
        self.x = 0
        self.listeners = []

    def subscribe(self, callback):
        self.listeners.append(callback)

    def move_to(self, x):
        if x == self.x:
            return
        self.x = x
        # 通知只负责失效,不在事件回调中集中重算。
        for callback in self.listeners:
            callback()

class DistanceProbe:
    def __init__(self, x):
        self.x = x
        self.dirty = True
        self.cached_distance = 0
        self.recomputes = 0

    def invalidate(self):
        self.dirty = True

    def move_to(self, x):
        if x != self.x:
            self.x = x
            self.invalidate()

    def read(self, target):
        if self.dirty:
            self.cached_distance = abs(self.x - target.x)
            self.recomputes += 1
            self.dirty = False
        return self.cached_distance

target = Target()
probes = []
slots = [[] for _ in range(6)]
for index in range(100):
    probe = DistanceProbe(index)
    probes.append(probe)
    target.subscribe(probe.invalidate)
    # 相邻 NPC 错开更新时间,避免集中到同一帧。
    slots[index % 6].append(probe)

reads = 0
for frame in range(60):
    if frame in (0, 20, 40):
        target.move_to(frame // 10 + 1)
    for probe in slots[frame % 6]:
        probe.read(target)
        reads += 1

print(f"逐帧方案:距离计算={100 * 60}")
print(f"分槽缓存:读取={reads},距离重算={sum(p.recomputes for p in probes)}")
预期输出:
逐帧方案:距离计算=6000
分槽缓存:读取=1000,距离重算=300
程序中的 300 次重算来自 3 次目标变化乘以 100 个 NPC。实际项目如果 NPC 自身每帧移动,缓存会更频繁失效;如果目标不断移动,通知本身也有成本,此时应考虑版本号检查、空间分组或降低非关键决策频率。
验证省下的是冗余而非正确性
先用未优化的逐帧计算作为参考,在相同位置序列下比较每次决策读取的距离。此例的最大刷新等待为 5 帧:事件发生后,所属槽最迟在下一轮读取才会重算。需要即时反馈的逻辑应在事件后立即刷新,或直接读取实时位置,而不应依赖低频缓存。
再测每帧重算数量,而不只看总次数。六个槽使负载错开,但连续变化可能让某些帧仍出现高峰;可按每帧工作预算控制批量大小,并为关键对象保留高优先级通道。对象销毁或回收时还要解除事件订阅,防止失效通知继续指向旧实例。
好的优化不是让所有组件都更新得更慢,而是让稳定数据不重算、允许延迟的工作错峰、必须实时的结果仍然准时。