
游戏客户端架构 / 系统课时
组件越多一定越慢吗
组件越多一定越慢吗
给角色拆出几十个组件后,性能下降究竟是组件数量造成的,还是更新逻辑与数据访问造成的?本课用同数量、不同更新负载的实验区分这些成本,并建立一套能指导架构调整的测量方法。
学习目标
- 区分组件实例、更新回调、业务计算和内存访问的开销。
- 用可运行实验验证“组件数相同,执行工作量可能不同”。
- 根据性能剖析结果决定是否合并组件或调整更新方式。
组件数量只是间接指标
一个只保存配置的组件和一个每帧执行寻路查询的组件,都计为一个组件,但运行成本完全不同。分析大型对象系统时,至少要分清四层:组件的常驻内存、更新调度与函数调用、回调内的实际计算、数据访问和临时分配。
例如 200 个组件中,190 个只保存状态、10 个需要逐帧更新,与 200 个全部注册逐帧更新的系统,组件数完全相同,调度次数却不同。反过来,只有一个巨型组件也可能在一次 update 中执行昂贵的循环,不能因此判定它更快。
组件通常还通过引用访问其他对象。若热路径不断跨对象读取零散字段,CPU 缓存局部性可能变差;若每帧创建临时集合,还可能出现垃圾回收峰值。这些开销需要测量,不能由类的个数推断。
看懂相同组件数的成本差异
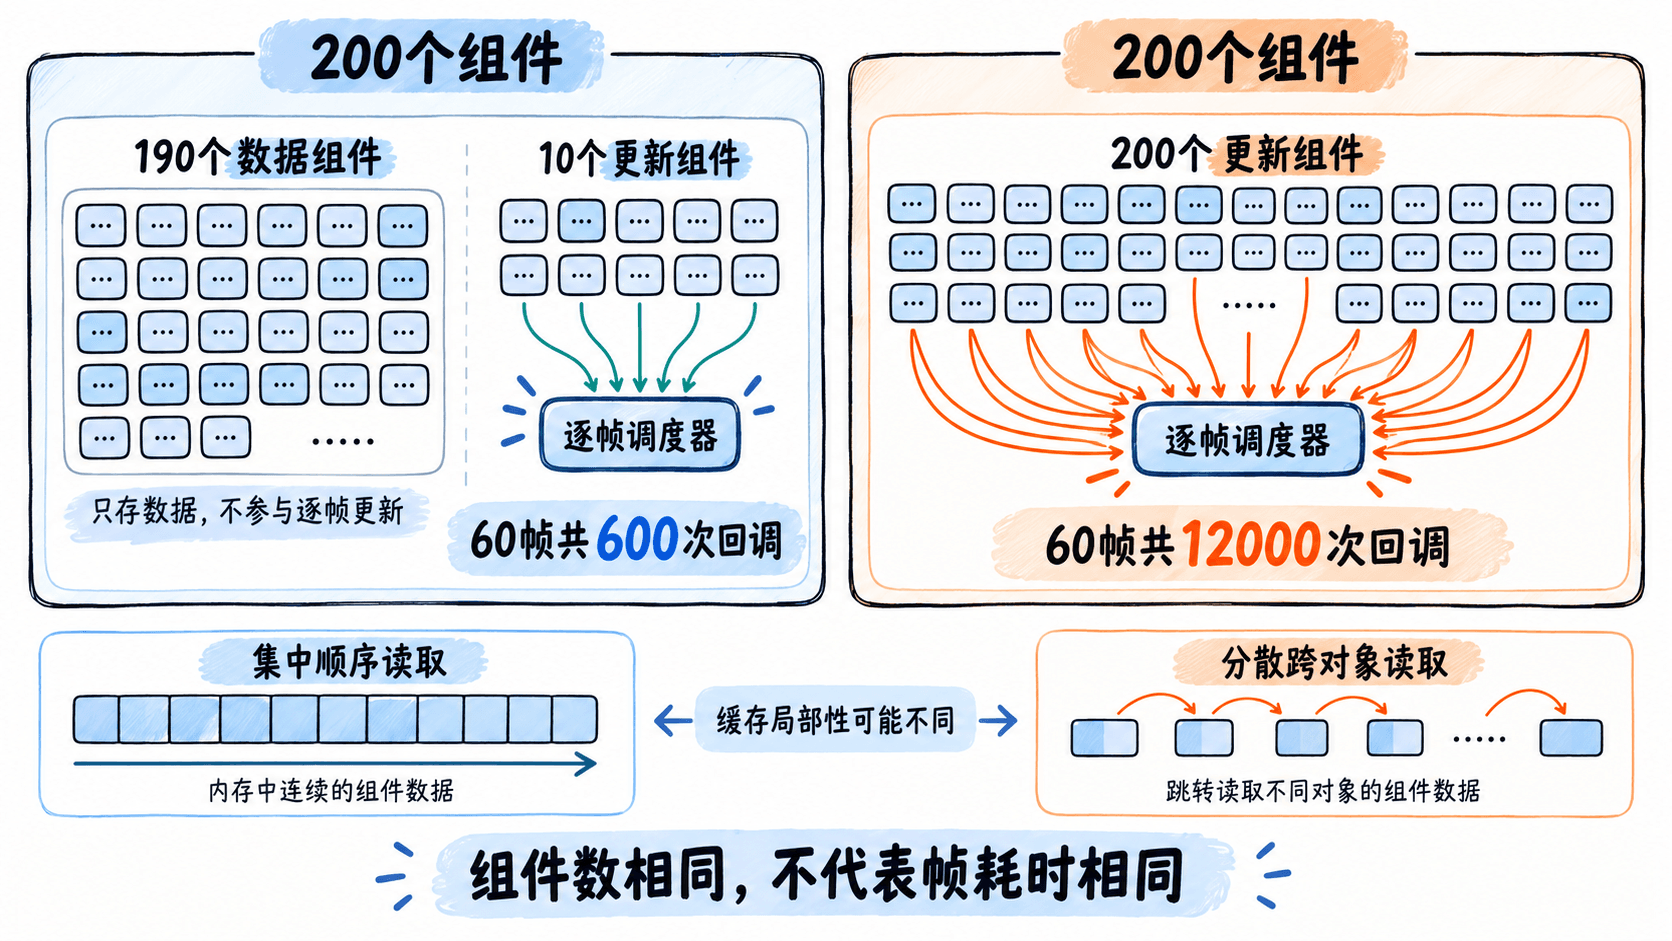
图中回调次数只反映更新注册频率,不代表帧时间会按比例变化。一次空回调和一次执行物理查询的回调,成本不等;引擎如何组织启用组件、何时派发回调,也会影响实际结果。
用实验隔离更新回调
下面的 Python 3 示例模拟调度器:所有场景都创建 200 个组件,只把需要逐帧运行的组件放进更新列表。它不模拟某个引擎的内部实现,只验证注册数量与调用次数的关系。
class Component:
    def __init__(self, needs_update: bool):
        self.needs_update = needs_update
        self.calls = 0

    def update(self) -> None:
        self.calls += 1

def simulate(active_count: int, frames: int = 60):
    components = [Component(i < active_count) for i in range(200)]
    # 数据组件不注册逐帧回调,避免无意义的遍历与调用。
    update_list = [c for c in components if c.needs_update]
    for _ in range(frames):
        for component in update_list:
            component.update()
    return len(components), len(update_list), sum(c.calls for c in components)

for active in (10, 200):
    total, registered, calls = simulate(active)
    print(f"组件={total} 注册更新={registered} 回调={calls}")
预期输出:
组件=200 注册更新=10 回调=600
组件=200 注册更新=200 回调=12000实验说明:减少不必要的逐帧注册可以直接减少回调次数,但不能据此宣称帧率提升 20 倍。这里的 update 只计数,没有模拟动画、物理、渲染或内存管理等真实负载。
在项目里找出真正瓶颈
进行一次可复现的对照测试,比盲目合并组件更有效:
- 固定同一场景、镜头、对象数及运行设备,预热后记录多帧数据。
- 在性能分析器里分别观察主线程帧耗时、脚本或组件更新耗时、物理查询、内存分配和垃圾回收峰值。
- 保持组件数量不变,仅关闭不必要的更新注册,再用相同流程测量;比较多次采样的典型值与峰值。
- 如果热点仍在数据遍历,再检查访问是否连续、是否反复跨组件查询,以及是否存在每帧临时分配。
优先定位最耗时的调用链,而不是先统计代码文件数。平均帧时间稳定,也不意味着没有卡顿;偶发峰值同样需要观察。
什么时候调整组件粒度
当多个组件本来只存数据,却各自拥有空的逐帧回调时,优先移除回调或改成按需更新,不必马上合并。若成千上万个实体每帧处理相同字段,可针对热点尝试紧凑数组和批量处理,再验证缓存收益是否覆盖数据同步成本。
如果瓶颈来自寻路、碰撞查询或资源加载,合并组件类通常无助于解决问题。组件边界首先服务于职责隔离;性能优化应改变被测出的昂贵工作,而不是简单追求更少的组件。