
游戏客户端架构 / 系统课时
哪些状态应该放进数据
哪些状态应该放进数据
同一种敌人生成十次,最大生命值和基础移动速度应该来自同一份配置,但当前生命值、减速效果和临时缓存不能共享。本课将对象数据按来源和生命周期分层,并通过可运行示例验证:共享配置不会导致不同对象的运行时状态相互污染。
学习目标
- 区分角色配置、静态属性、运行时状态和临时缓存的职责与归属。
- 理解配置从模板进入对象实例,以及状态和缓存随生命周期变化的过程。
- 判断哪些数据需要保存、重置或重新计算,避免共享状态和缓存失效问题。
根据数据的变化范围划分职责
设计组件数据时,不应简单地按字段类型分类。生命值、攻击力、移动速度都可能是数字,但它们的拥有者、修改时机和生命周期并不相同。
更可靠的判断方法是:这个值由谁定义、何时改变、是否允许多个对象共享,以及对象销毁后是否还需要保留。
| 数据类别 | 典型字段 | 归属与变化规则 |
|---|---|---|
| 角色配置 | templateId、weaponId、aiPolicyId | 由配置资源定义,通常按版本管理 |
| 静态属性 | maxHp、baseSpeed、attackRange | 属于模板中的基础数值,通常由同类型实例共享读取 |
| 运行时状态 | currentHp、cooldownRemaining、currentTargetId | 由具体对象实例持有,运行过程中持续变化 |
| 临时缓存 | effectiveSpeedCache、lastComputedPath | 由实例或系统短期持有,依赖条件改变时必须失效 |
这里的静态属性不是编程语言中的 static 字段,而是相对于对象运行过程而言较稳定的基础数值。它通常是配置的一部分,不必另建一个全局可变属性容器。
例如,敌人模板规定 maxHp=100,这是基础属性;敌人受到 30 点伤害后 currentHp=70,这是运行时状态;HUD 显示的生命比例为 70%,则可以由当前生命值和最大生命值计算得到。
需要特别注意,能够计算出来的值不一定应该存储。计算成本很低的生命比例可以直接求值;只有重复计算的实际成本值得优化时,才考虑缓存,并同时设计失效规则。
数据沿对象生命周期如何流转
一个可复用对象通常经历配置加载、实例创建、运行更新、停用重置和最终销毁。不同阶段允许修改的数据范围不同。
创建对象时,装配逻辑读取模板配置,为实例创建独立的运行时状态。组件随后依据配置和状态执行行为,必要时生成派生缓存。配置是共享的只读输入,而不是让每个实例共同修改的状态容器。
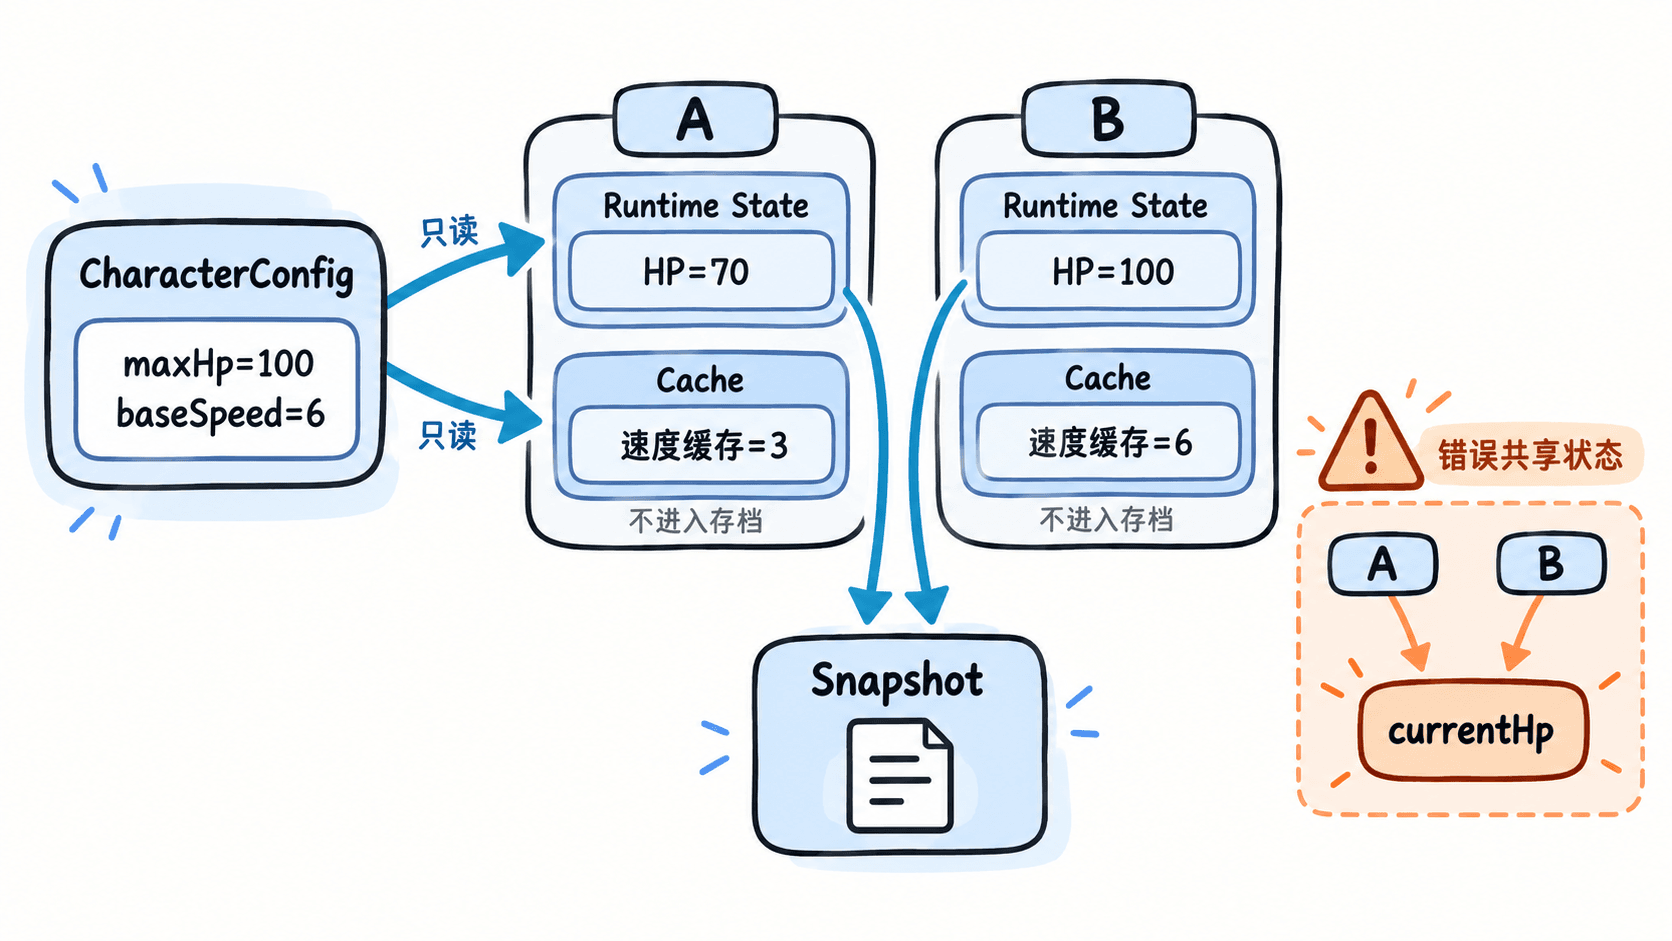
如果两个敌人共用同一份包含 currentHp 的可变字典,那么敌人 A 受伤可能导致敌人 B 的生命值一起下降。问题不在于使用了数据驱动,而在于把实例状态错误地放进了共享配置。
生命周期边界也要明确:对象重新出生时重建生命值、冷却和临时增益;对象从对象池取出时清理上次使用的缓存;对象销毁时释放其状态引用和事件订阅。不能认为禁用组件就会自动完成这些操作。
用代码验证配置共享与状态隔离
下面使用 Python 3.10 或更新版本模拟两个角色实例。冻结的数据类表示共享配置,可变的数据类保存各自的战斗状态。为了展示缓存失效机制,示例还缓存了派生移动速度。
from dataclasses import dataclass

@dataclass(frozen=True)
class CharacterConfig:
    max_hp: int
    base_speed: float

@dataclass
class CharacterState:
    hp: int
    speed_factor: float = 1.0

class Character:
    def __init__(self, config: CharacterConfig):
        # 多个实例可以共享配置,但必须各自创建状态。
        self.config = config
        self.state = CharacterState(hp=config.max_hp)
        self._cached_speed = None

    @property
    def move_speed(self) -> float:
        if self._cached_speed is None:
            self._cached_speed = (
                self.config.base_speed * self.state.speed_factor
            )
        return self._cached_speed

    def take_damage(self, damage: int) -> None:
        if damage < 0:
            raise ValueError("damage must be non-negative")
        self.state.hp = max(0, self.state.hp - damage)

    def set_speed_factor(self, value: float) -> None:
        if not 0 <= value <= 1:
            raise ValueError("speed factor must be between 0 and 1")
        self.state.speed_factor = value
        # 依赖数据变化后,旧缓存不再有效。
        self._cached_speed = None

# 两个对象引用同一份模板配置。
template = CharacterConfig(max_hp=100, base_speed=6.0)
one = Character(template)
two = Character(template)

one.take_damage(30)
one.set_speed_factor(0.5)

print(f"one: hp={one.state.hp}, speed={one.move_speed:.1f}")
print(f"two: hp={two.state.hp}, speed={two.move_speed:.1f}")
print(f"shared_config={one.config is two.config}")
预期输出:
one: hp=70, speed=3.0
two: hp=100, speed=6.0
shared_config=True
结果表明,两个对象确实共享 CharacterConfig,但每个对象的 CharacterState 独立存在。修改第一个对象的血量和速度系数,不会改变第二个对象,也不会修改模板中的基础属性。
这里的速度乘法本身很简单,实际项目通常不需要缓存这种廉价计算。示例保留缓存是为了展示关键约束:只要缓存依赖的输入改变,就必须清除旧结果。如果移动速度还受装备和状态效果影响,相关变化也应触发失效。
保存数据与重置数据的边界
数据应该保存多久,取决于游戏需求,而不是取决于它是否存放在组件字段中。
对于需要持久化的角色,可以将模板 ID、配置版本以及必须延续的状态写入存档。加载时先解析对应模板,再创建对象并恢复生命值、经验值或任务进度等状态。寻路结果、渲染插值和可以重算的派生缓存通常不应进入存档。
临时召唤的敌人则未必需要持久化。它们可以在生成时使用默认状态,销毁后直接丢弃运行时数据。客户端预测状态也应与服务器权威状态区分,不能因为某个值可序列化,就把它当作可信的最终结果。
配置热更新还会产生一个容易忽略的问题:如果最大生命值从 100 调整为 120,已经存在的角色应该保持当前血量、保持当前血量比例,还是重置为满血?三种方式都可能合理,但必须由迁移规则明确决定。
为新字段确定唯一数据归属
当组件新增一个字段时,可以按以下顺序检查:
- 如果它由策划配置并可供多个同类型对象复用,应放进模板或静态属性配置。
- 如果它随具体对象行动而改变,应放进该对象的运行时状态,并明确初始化和重置时机。
- 如果它由其他数据计算得到,应优先直接计算;确需缓存时记录其依赖,并建立失效路径。
- 如果它需要跨存档、跨场景或网络同步,应先确认数据权威来源和持久化范围,而不是直接序列化整个组件。
可以通过一个简单的验证发现边界错误:连续创建两个相同角色,只让其中一个受到伤害、获得增益并销毁,然后检查另一个角色的状态与模板是否保持不变。
数据驱动的核心不是把所有字段都移进配置文件,而是让共享配置描述对象应该具备什么,让实例状态记录对象当前发生了什么,让临时缓存只承担可重新计算的性能优化职责。