
游戏客户端架构 / 系统课时
模板对象如何复用配置
模板对象如何复用配置
当十几种敌人只在生命值、移动速度和武器上略有不同,复制整套对象脚本会让平衡调整变得困难。本课通过角色基础模板、敌人变体和武器模板的组合,实现少量配置生成多种对象,并验证多个实例不会共享可变的战斗状态。
学习目标
- 理解基础模板、变体覆盖、配置引用和运行时实例之间的关系。
- 能用模板 ID 组合角色、敌人和武器配置,减少重复硬编码。
- 能处理字段覆盖、模板引用校验和实例状态隔离,避免配置复用引入隐性问题。
将重复定义拆成基础模板与差异配置
假设游戏中有侦察兵、守卫和精英敌人。它们都具备生命、移动和攻击能力,区别主要在基础属性以及装备的武器。
如果分别创建三份完整的敌人配置,生命、移动与武器字段会重复出现。未来增加新的通用属性时,还需要修改每一份配置,容易出现漏改和数值不一致。
更合理的结构是将对象描述分成几个层次:
- 角色基础模板:保存默认最大生命值、移动速度以及默认武器 ID。
- 敌人变体模板:只记录与基础模板不同的字段,例如侦察兵速度更快、守卫生命值更高。
- 武器模板:独立保存伤害、攻击冷却等参数,通过
weaponId关联到角色。 - 运行时实例:保存当前生命值、冷却计时和具体目标,不修改任何模板资源。
这里的复用单位是配置数据和能力组件,而不是复制完整脚本。相同的 HealthComponent 可以读取不同的 maxHp,AttackComponent 则可以读取不同的武器配置,在保持行为逻辑统一的同时形成不同敌人。
配置如何装配为最终对象
对象生成时,配置装配器根据敌人模板 ID 查找基础角色配置,再应用敌人变体中的覆盖值。随后根据最终得到的武器 ID 查找武器模板,建立角色与武器的配置关系。
这是一条从配置资产到有效配置,再到对象实例的装配链。模板并不负责对象行为,行为仍由组件和系统实现。
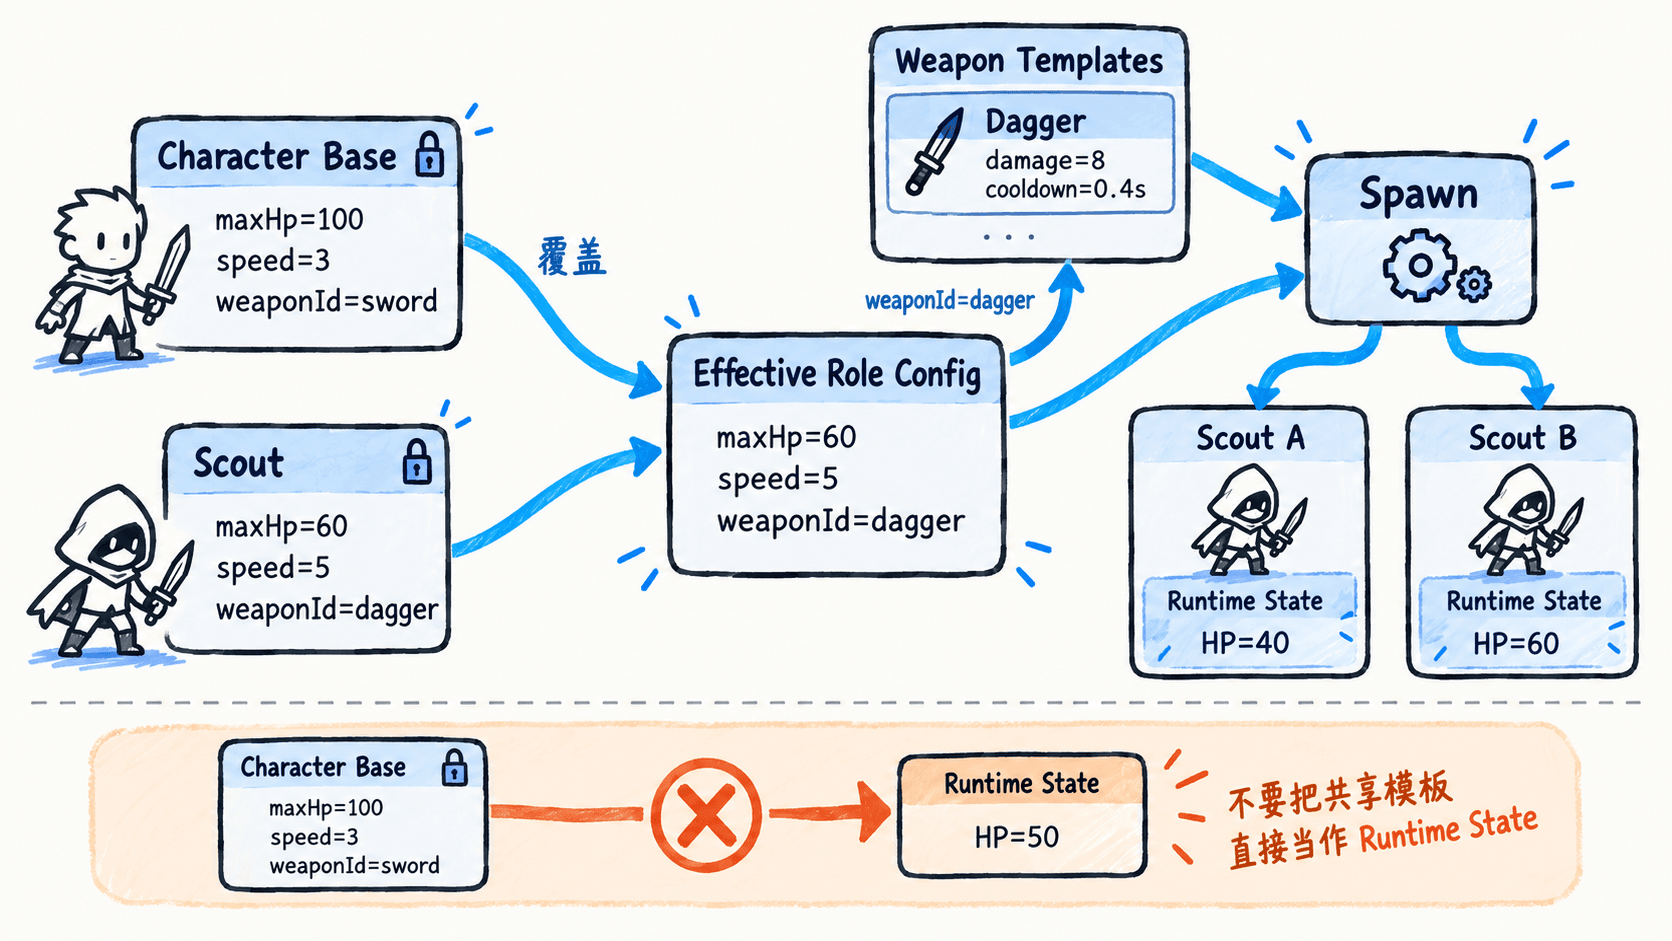
覆盖顺序必须确定。例如基础模板给出 maxHp=100,侦察兵变体声明 maxHp=60,最终创建侦察兵时就应使用 60。没有被变体覆盖的字段继续采用基础默认值。
可以将优先级设计为基础角色默认值、敌人变体、关卡生成参数三个层次,但并非所有项目都需要三层。本课示例只实现前两层,以便把配置来源和覆盖规则保持清晰。
引用也应通过稳定 ID 建立。角色配置存储 weaponId=dagger,而不是在每一个侦察兵配置中复制完整的匕首伤害和冷却字段。这样调整匕首模板后,引用它的对象能够按照明确的配置加载策略获得相应参数。
实现一个最小模板装配器
下面使用 Python 3.10 或更新版本实现基础角色配置、敌人变体配置和武器模板表。它们由字典模拟,正式项目中可以来自经过校验的 JSON、ScriptableObject、Data Asset 或其他资源系统。
示例故意使用扁平的角色字段,因此可以通过字典覆盖生成有效配置。武器配置通过 ID 查询并复制,运行时状态则在每次生成对象时单独创建。
from copy import deepcopy

CHARACTER_BASE = {
    "max_hp": 100,
    "speed": 3.0,
    "weapon_id": "sword",
}

ENEMY_TEMPLATES = {
    "scout": {
        "max_hp": 60,
        "speed": 5.0,
        "weapon_id": "dagger",
    },
    "guard": {
        "max_hp": 160,
    },
}

WEAPON_TEMPLATES = {
    "sword": {"damage": 16, "cooldown_s": 1.0},
    "dagger": {"damage": 8, "cooldown_s": 0.4},
}

def spawn(enemy_id: str) -> dict:
    if enemy_id not in ENEMY_TEMPLATES:
        raise ValueError(f"unknown enemy: {enemy_id}")

    # 扁平字段按变体覆盖基础值,每次生成新的配置字典。
    role = {**CHARACTER_BASE, **ENEMY_TEMPLATES[enemy_id]}
    weapon_id = role["weapon_id"]
    if weapon_id not in WEAPON_TEMPLATES:
        raise ValueError(f"unknown weapon: {weapon_id}")

    # 武器配置与模板表隔离,战斗状态由实例独立持有。
    weapon = deepcopy(WEAPON_TEMPLATES[weapon_id])
    return {
        "role": role,
        "weapon": weapon,
        "state": {
            "hp": role["max_hp"],
            "cooldown_s": 0.0,
        },
    }

scout_a = spawn("scout")
scout_b = spawn("scout")
guard = spawn("guard")

# 只有第一只侦察兵受到伤害。
scout_a["state"]["hp"] -= 20

print(f"scout A hp={scout_a['state']['hp']}, damage={scout_a['weapon']['damage']}")
print(f"scout B hp={scout_b['state']['hp']}, damage={scout_b['weapon']['damage']}")
print(f"guard hp={guard['state']['hp']}, damage={guard['weapon']['damage']}")
print(f"base hp={CHARACTER_BASE['max_hp']}")
预期输出:
scout A hp=40, damage=8
scout B hp=60, damage=8
guard hp=160, damage=16
base hp=100
侦察兵继承基础角色的通用配置,但覆盖了最大生命值、速度和武器。守卫只覆盖最大生命值,因此仍使用基础模板中的长剑。
两个侦察兵拥有相同的最终配置值,受到伤害的却只有第一个对象。基础模板的生命值仍为 100,说明实例的运行时更新没有回写配置来源。
示例为了便于观察采用普通字典。实际项目应把装配后的配置视为只读数据,或使用不可变数据结构,并让组件通过受控方法修改运行时状态。对于大型配置资源,经过验证的不可变配置还可以被多个实例直接共享,避免重复复制。
处理覆盖规则与无效模板引用
模板复用最容易出现的问题不是创建对象失败,而是装配结果看似正确,却悄悄丢失了某些字段。
本例的角色字段位于字典顶层,浅层覆盖足够使用。如果把属性改为嵌套结构,例如将 max_hp 放在 stats 字典内,直接使用同样的字典展开方式就可能覆盖整个 stats,导致原有的防御力或速度字段丢失。
因此需要根据配置结构明确选择合并策略:扁平字段直接覆盖;嵌套对象按已定义的字段规则递归合并;列表和数组则应明确规定是整体替换、追加还是按元素 ID 合并,而不是默认套用一种策略。
生产环境的装配入口还应检查以下条件:
- 模板 ID 存在且唯一,不允许循环引用或无法解析的父模板链。
- 武器、技能和组件类型等引用均能够解析到有效资源。
- 最大生命值必须大于零,冷却时间不得为负数,必要字段不能缺失。
- 最终配置必须满足组件所需的数据结构,不能让组件在运行时才发现字段缺失。
在配置加载阶段集中验证,比对象已经生成、战斗开始后才报错更容易定位问题。校验失败时应指出具体模板 ID 和字段路径,不应悄悄使用不明确的默认值掩盖错误。
让模板在项目迭代中保持可维护
模板设计不宜无限增加父子继承层级。若每一种武器、敌人和难度组合都需要一个新子模板,很快就会出现难以追踪的覆盖关系。
通常应优先采用少量基础模板、清晰的差异覆盖和独立配置引用。例如角色模板决定基础属性,武器模板决定攻击参数,难度修正作为单独的装配输入,而不是为每个组合复制一份完整配置。
当配置上线后,还需要管理模板版本。存档如果引用旧模板 ID,加载器必须能够找到兼容版本或执行显式迁移。热更新时也应区分新生成对象与已经存在的对象:前者可直接使用新配置,后者是否重算属性或保留当前状态,应由项目规则决定。
可以通过一次小型回归验证模板设计:生成两个侦察兵和一个守卫,检查差异字段覆盖结果、武器引用是否正确,再对其中一个实例施加伤害。如果其他实例和模板资源始终不变,说明配置复用与实例状态之间的边界基本成立。
最终应形成稳定的协作方式:模板负责声明默认参数和资源引用,装配入口负责解析、校验与组合,功能组件负责读取配置并执行行为,运行时实例负责保存自己的可变状态。这样新增敌人通常只需要新增或调整配置,而不必复制已有对象脚本。