
游戏客户端架构 / 系统课时
把对象状态和配置分开保存
把对象状态和配置分开保存
把当前生命值、目标引用和冷却计时直接写进敌人模板,会让多个实例互相串状态,也可能使存档包含无法恢复的运行时对象。本课将共享配置、实例状态和存档快照分开,完成从对象生成到保存、恢复与销毁的数据生命周期。
学习目标
- 区分共享配置、实例运行状态和持久化快照的职责。
- 实现多个对象共享同一配置但保持独立运行状态。
- 选择需要保存的字段,并在加载时重新构建运行时对象。
先划清三种数据的职责
假设关卡中生成了两个使用同一敌人模板的史莱姆。它们的最大生命值、基础速度可以相同,但当前生命值、位置和攻击目标必须相互独立。
如果把 current_hp 放进共享模板,当第一个史莱姆受伤时,第二个史莱姆读取同一字段,就可能错误地得到受伤后的生命值。这不是生命值计算问题,而是数据所有权设计错误。
在组件化对象架构中,至少应该区分以下三种数据:
| 数据类型 | 典型字段 | 所有权与生命周期 |
|---|---|---|
| 配置数据 | template_id、max_hp、speed |
模板资源管理,可由多个实例共享 |
| 实例状态 | hp、position、target_id |
由单个实例拥有,在运行中改变 |
| 存档快照 | 模板标识、当前生命值、必要位置 | 由存档系统管理,用于恢复必要状态 |
共享配置适合保存设计时确定的规则和基础数值。实例状态保存对象当前的实际情况。存档快照不是整个运行时对象的复制品,而是从实例状态中筛选出可序列化、能够帮助恢复游戏进度的字段。
因此,存档里通常只需要保存模板标识,而不必为每个实例重复保存一份完整模板。读取时先根据标识找到对应配置,再恢复该实例自己的状态。
生成、保存与恢复的数据流
一个对象的数据生命周期可以拆成四个阶段。
- 生成对象:根据模板标识取得共享配置,为新实例创建独立状态,并按照配置初始化生命值等字段。
- 运行对象:游戏逻辑只修改实例状态,必要时读取配置进行规则计算。
- 保存快照:提取需要跨会话保留的数据,写入可序列化结构,不保存运行时对象引用。
- 加载对象:重新查找模板、生成对象与组件、恢复持久化字段,然后重建目标锁定等临时关系。
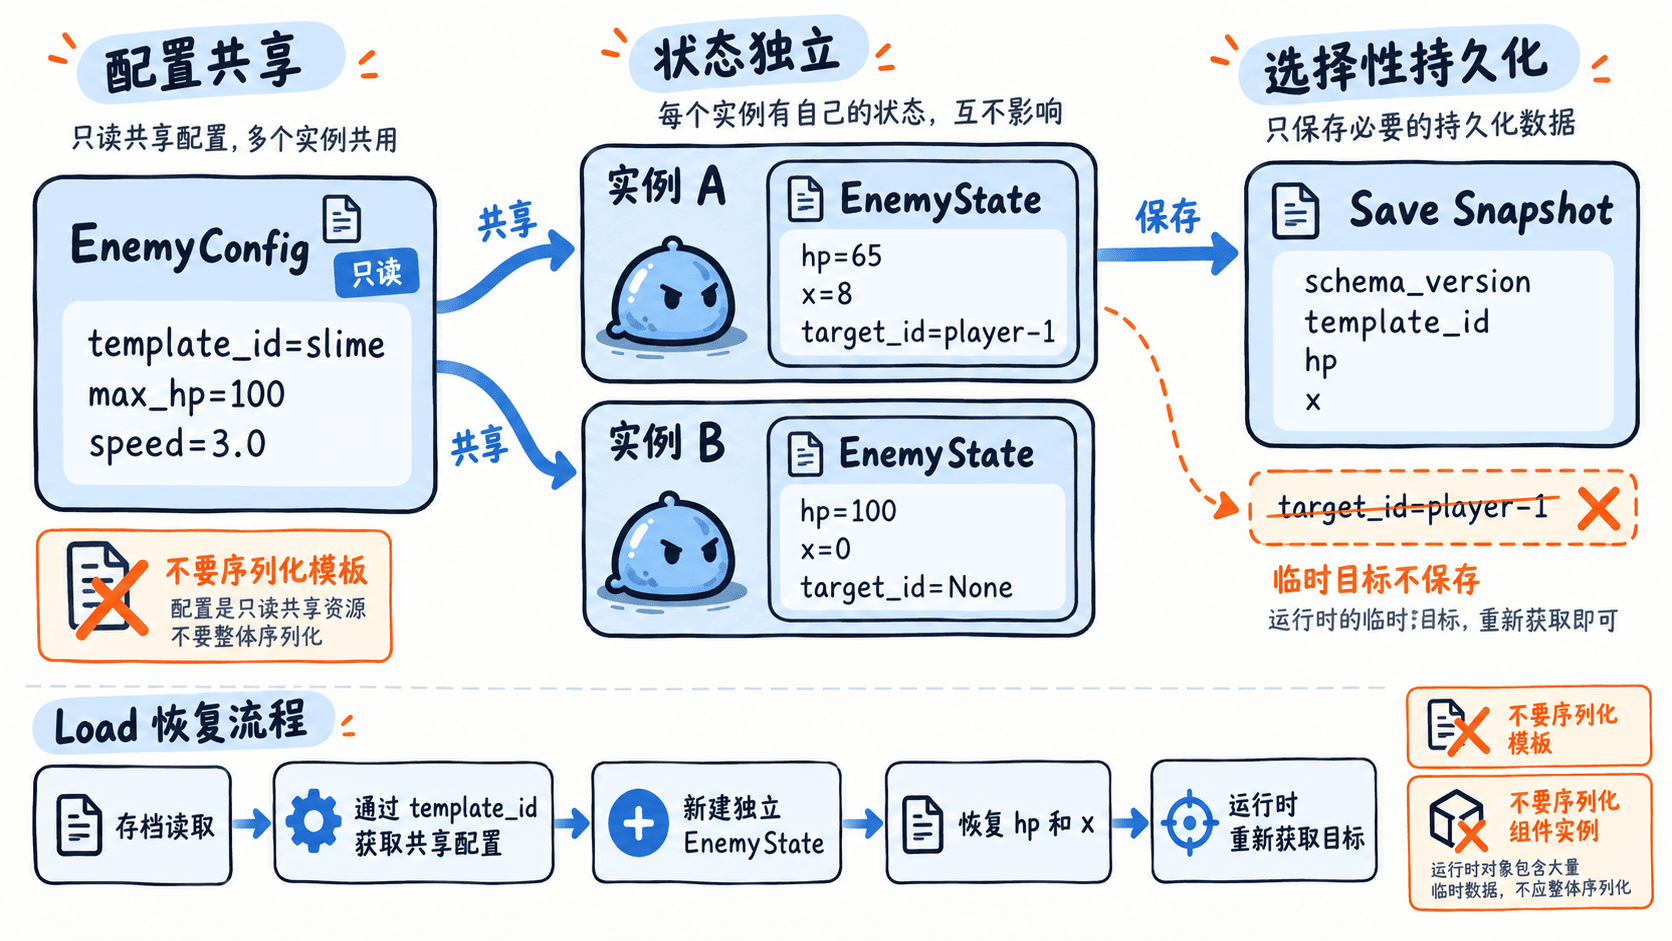
这张关系图包含两种不同的共享规则:模板可以被多个实例安全引用,但每个实例必须拥有自己的可变状态。存档与运行时对象之间也不是直接引用关系,而是通过模板标识和快照数据重新建立对象。
对象销毁时,应该释放订阅、定时器、目标引用等运行时资源。销毁实例不意味着删除共享模板,也不应修改其他实例已经保存的状态。
用独立状态完成保存和恢复
下面使用 Python 3.10 及以上版本实现一个最小示例。EnemyConfig 是不可重新赋值的配置对象,EnemyState 是每个敌人独有的可变状态;保存时只提取必要字段,并在恢复时重新查找配置。
import json
from dataclasses import dataclass


@dataclass(frozen=True)
class EnemyConfig:
    template_id: str
    max_hp: int
    speed: float


@dataclass
class EnemyState:
    hp: int
    x: int = 0
    target_id: str | None = None


class Enemy:
    def __init__(self, config: EnemyConfig, state: EnemyState | None = None):
        self.config = config
        # 每次生成都创建独立状态,避免不同实例共享可变数据。
        self.state = state if state is not None else EnemyState(config.max_hp)

    def take_damage(self, damage: int) -> None:
        self.state.hp = max(0, self.state.hp - damage)

    def save(self) -> dict:
        # 临时目标不入档,加载后重新执行目标搜索。
        return {
            "schema_version": 1,
            "template_id": self.config.template_id,
            "hp": self.state.hp,
            "x": self.state.x,
        }


def restore(data: dict, library: dict[str, EnemyConfig]) -> Enemy:
    # 先校验版本与数值,再构建新的运行状态。
    if data["schema_version"] != 1:
        raise ValueError("不支持的存档版本")

    config = library[data["template_id"]]
    hp, x = data["hp"], data["x"]
    if not isinstance(hp, int) or not (0 <= hp <= config.max_hp):
        raise ValueError("血量不合法")
    if not isinstance(x, int):
        raise ValueError("位置不合法")

    return Enemy(config, EnemyState(hp=hp, x=x))


if __name__ == "__main__":
    library = {"slime": EnemyConfig("slime", 100, 3.0)}
    a = Enemy(library["slime"])
    b = Enemy(library["slime"])

    a.take_damage(35)
    a.state.x = 8
    a.state.target_id = "player-1"

    saved = a.save()
    loaded = restore(saved, library)

    print("共享配置:", a.config is b.config)
    print("当前血量:", a.state.hp, b.state.hp)
    print("存档:", json.dumps(saved, ensure_ascii=False, sort_keys=True))
    print("恢复后:", loaded.state.hp, loaded.state.x, loaded.state.target_id)
预期输出:
共享配置: True
当前血量: 65 100
存档: {"hp": 65, "schema_version": 1, "template_id": "slime", "x": 8}
恢复后: 65 8 None
第一个输出证明 A 和 B 引用了同一份配置。第二个输出说明 A 扣除 35 点生命值后,B 仍然保持 100 点生命值。恢复后的对象保留了 65 点生命值和位置 8,但没有恢复旧的目标标识。
示例使用内存中的字典模拟模板库,并生成可以转换为 JSON 的存档快照,没有直接写入文件。实际项目可以将快照交给存档服务统一编码、写盘、读取和校验。位置字段 x 仅用于简化演示,真实项目还需要根据游戏需求保存关卡、坐标和朝向等信息。
决定哪些字段应该持久化
判断一个字段是否应该进入存档,关键不是它是否发生过变化,而是下一次加载能否安全、准确地恢复其含义。
适合持久化的数据通常包括当前生命值、角色成长进度、稳定的物品标识、玩家位置,以及需要跨会话持续生效的任务状态。它们应当采用明确的数据类型和版本结构。
不宜直接持久化的数据包括组件实例引用、内存地址、事件订阅句柄、协程对象、物理引擎内部句柄,以及只在当前运行会话中有效的目标引用。这些数据即使能被强行转换为文本,也未必能在新会话中重新指向正确对象。
对于需要恢复的跨对象关系,应优先保存稳定的业务标识,并在对象加载完成后统一解析引用。如果目标已经不存在,就根据业务规则清空引用或重新搜索,而不是继续持有失效对象。
处理模板变化和存档版本
配置和存档通常具有不同的更新节奏。游戏版本升级后,敌人模板的最大生命值可能从 100 改成 80,但旧存档仍然记录 90 点当前生命值。此时不能假设旧快照一定满足新配置规则。
示例在恢复时检查 schema_version,并要求生命值处于当前配置允许的范围内。因此,旧存档中的生命值如果超过新模板上限,会被明确拒绝。生产系统需要进一步制定迁移策略,例如限制到新上限、按比例换算,或者按照存档记录的旧配置版本进行迁移。
此外,还应检查模板标识是否仍然存在、必需字段是否齐全,以及状态值是否符合类型和范围要求。不能仅因为 JSON 可以成功解析,就认定存档可以安全恢复。
实际验收时,可以依次验证以下情况:
- 两个实例共享同一个模板,但受到伤害后生命值互不影响。
- 保存并恢复实例 A 后,其必要状态保持一致,实例 B 不受影响。
- 临时目标和事件订阅不会从旧运行会话直接带入新对象。
- 模板缺失、存档版本不受支持或状态值不合法时,加载能够明确失败或执行受控迁移。
最终应保持三个清晰边界:共享配置定义对象能够如何运行,独立状态记录对象当前运行到了哪里,存档快照只保存下一次能够可靠恢复的事实。 这样才能在大量实例复用同一套配置的同时,避免状态污染,并为对象重建和版本升级提供稳定的数据基础。