
高等数学 / 系统课时
从数据矩阵到降维回归验证
从数据矩阵到降维回归验证
一个数值建模流程不能只停在“模型能拟合”。本篇从数据矩阵的秩和条件数检查开始,用 SVD 完成 PCA 降维,再在主成分上做最小二乘回归,并分别用重建误差与预测残差验证降维是否保留了需要的信息。
学习目标
- 用秩、奇异值和条件数识别数据矩阵中的冗余方向。
- 用 SVD 实现 PCA,并在低维主成分上完成最小二乘拟合。
- 区分重建误差与预测残差,判断降维是否同时满足表示与预测目标。
先把验证链路连起来
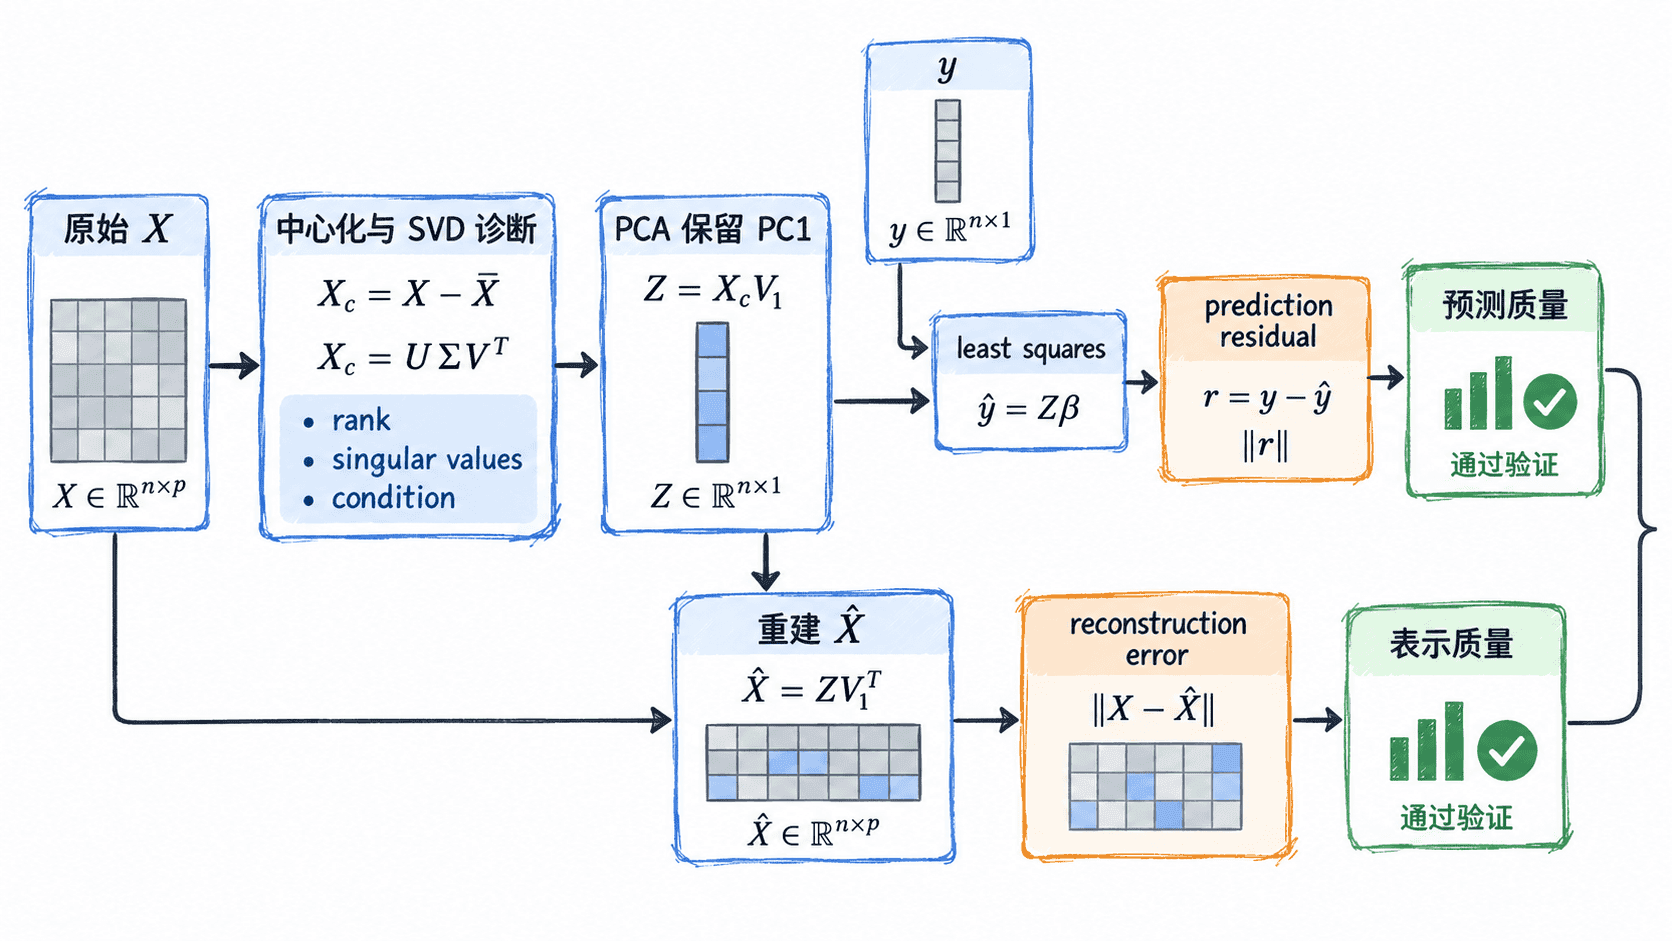
原始特征矩阵可能存在重复列、近线性相关或尺度差异。直接回归前先中心化并检查奇异值:秩不足说明参数并不唯一,非零奇异值之间的比值则反映有效子空间内部的数值条件。
PCA 随后保留主要奇异方向,把原矩阵变成低维得分矩阵 。回归只在 上求系数;与此同时,用保留的主成分重建 ,就能从“表示是否丢失过多信息”和“预测是否留下系统性残差”两个角度验证结果。
运行一个端到端数值案例
下面构造 5 个样本、3 个特征。前两列完全共享同一变化方向,因此中心化后的矩阵秩只有 2;第三列包含较小的独立变化。目标 只依赖主变化方向,所以保留一个主成分后虽然会产生少量重建误差,但仍能完整保留预测信息。
import numpy as np

c1 = np.array([-2.0, -1.0, 0.0, 1.0, 2.0])
c2 = np.array([2.0, -1.0, -2.0, -1.0, 2.0])

X = np.column_stack([
    10.0 + c1,
    20.0 + c1,
    5.0 + 0.1 * c2,
])
y = 10.0 + 3.0 * c1

mean = X.mean(axis=0)
Xc = X - mean
U, s, Vt = np.linalg.svd(Xc, full_matrices=False)

tol = s[0] * max(Xc.shape) * np.finfo(float).eps
rank = int(np.sum(s > tol))
full_condition = np.inf if rank < Xc.shape[1] else s[0] / s[-1]
nonzero_condition = s[0] / s[rank - 1]

# 固定主成分符号,避免 SVD 的等价正负方向影响打印结果。
v1 = Vt[0].copy()
if v1[0] < 0:
    v1 = -v1
z = Xc @ v1

X_reconstructed = np.outer(z, v1) + mean
reconstruction_error = np.linalg.norm(X - X_reconstructed) / np.linalg.norm(Xc)
variance_ratio = s[0] ** 2 / np.sum(s ** 2)

design = np.column_stack([np.ones(len(z)), z])
beta, *_ = np.linalg.lstsq(design, y, rcond=None)
y_pred = design @ beta
prediction_rmse = np.sqrt(np.mean((y - y_pred) ** 2))

print(f"rank={rank}")
print(f"singular_values=[{s[0]:.6f}, {s[1]:.6f}, {s[2]:.6f}]")
print(f"full_condition={full_condition}")
print(f"nonzero_condition={nonzero_condition:.6f}")
print(f"pc1_variance_ratio={variance_ratio:.6f}")
print(f"reconstruction_relative_error={reconstruction_error:.6f}")
print(f"regression_intercept={beta[0]:.6f}")
print(f"regression_slope={beta[1]:.6f}")
print(f"prediction_rmse={prediction_rmse:.6f}")
print("predictions=" + str(np.round(y_pred, 1).tolist()))
预期输出
rank=2
singular_values=[4.472136, 0.374166, 0.000000]
full_condition=inf
nonzero_condition=11.952286
pc1_variance_ratio=0.993049
reconstruction_relative_error=0.083375
regression_intercept=10.000000
regression_slope=2.121320
prediction_rmse=0.000000
predictions=[4.0, 7.0, 10.0, 13.0, 16.0]
full_condition=inf 不是计算失败,而是第三个奇异值在数值精度下为零:三列特征只张成二维子空间。若仍在三列上直接解释回归系数,参数会存在不唯一性;PCA 把问题改写到独立主方向上,从而避免在冗余坐标中求解。
两类误差回答不同问题
第一主成分解释约 99.3% 的中心化方差,但相对重建误差仍约为 8.34%。这是因为被舍弃的第二方向虽然能量较小,却确实存在。重建误差衡量的是“压缩后还能否还原特征”,不能直接替代预测指标。
本例的预测 RMSE 为 0,是因为 恰好只依赖第一主成分。由此也能看到 PCA 的一个重要边界:它按 的方差选方向,而不是按“对 是否有用”选方向。真实数据中,低方差方向仍可能包含强预测信号,所以主成分数量应同时看重建误差、验证集预测误差和业务可接受阈值。
验证时避免数据泄漏
这个小例子用全部 5 个样本演示数值链路,因此预测残差只说明拟合结果与构造关系一致,不代表模型具有泛化能力。工程中应先划分训练集与验证集,再只用训练集估计均值、缩放参数和 PCA 主方向;验证集只能复用这些变换,不能重新拟合 PCA。
当秩、奇异值、重建误差和预测残差被放在同一条证据链上时,降维就不再只是“把维度变小”:你能明确知道哪些方向被舍弃、数值条件是否改善,以及这些舍弃是否真的伤害了最终预测任务。