
高等数学 / 系统课时
用截断SVD做低秩近似
用截断SVD做低秩近似
截断 SVD 的目标,是用更少的奇异方向逼近原矩阵,同时知道自己丢掉了多少信息。本篇从完整 SVD 出发,构造秩不超过 的近似矩阵,并用奇异值直接计算最优误差与保留比例。
学习目标
- 能由完整 SVD 写出截断 SVD 与低秩近似矩阵
- 能用奇异值计算谱范数误差、Frobenius 误差和能量保留率
- 能根据奇异值衰减速度判断合适的截断阶数
从完整 SVD 截取主导成分
设矩阵 的秩为 ,其紧致 SVD 为
其中 。每一项 都是一个秩为 1 的矩阵,奇异值越大,这一项对整体矩阵的贡献越强。
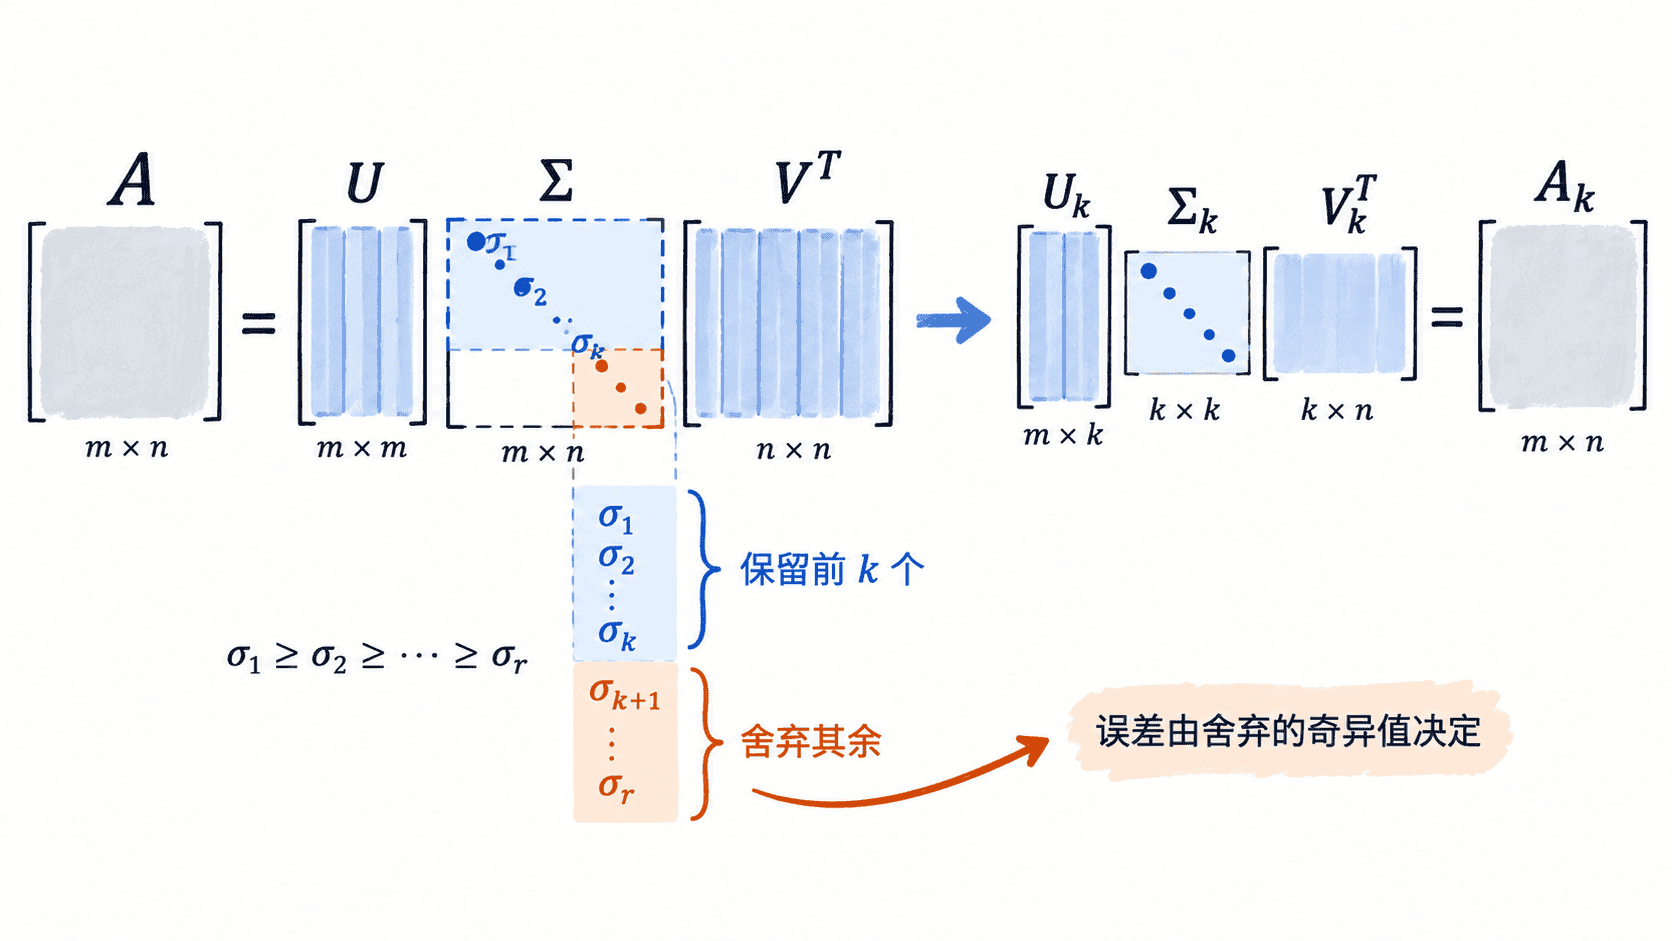
保留前 个奇异三元组,就得到截断 SVD:
的秩不超过 。原本需要同时描述许多行列关系的矩阵,被压缩为 个主导方向及其权重。
为什么它是最佳低秩近似
截断 SVD 不只是一个直观压缩方法。Eckart–Young–Mirsky 定理说明:在所有秩不超过 的矩阵中, 同时给出谱范数和 Frobenius 范数下的最佳近似。
这两个公式把“截断损失”完全转化为被舍弃的奇异值。谱范数只看最大的剩余方向,因此误差由 决定;Frobenius 范数把所有舍弃方向的平方能量累加。
用奇异值选择截断阶数
常用的选择依据是累计能量保留率:
例如奇异值为 。取 时,累计能量保留率为 ,Frobenius 截断误差为 。这说明第三个方向对整体平方能量贡献很小,保留前两个方向通常已经能很好地逼近原矩阵。
但阈值不是固定规则。如果奇异值下降很快,小 就可能有效;如果奇异值接近持平,则不存在明显的低秩结构,过度截断会丢失大量信息。实际任务中还应结合存储预算、计算成本和允许误差共同选取 。
低秩近似保留与舍弃的内容
截断 SVD 优先保留的是全局上最强的正交变化方向,而不是逐个元素保证误差都很小。因此它适合压缩、去噪和潜在结构提取,但不能保证某个局部区域或少数异常值被完整保存。
从计算角度看,只保存 、 和 时,参数量大约从 降为 。当 且奇异值衰减明显时,既能降低存储与计算量,又能用上面的误差公式明确量化代价。
按自己的节奏,确认真正理解。