
高等数学 / 系统课时
用低秩近似压缩图像矩阵
用低秩近似压缩图像矩阵
一张灰度图可以直接看成一个数值矩阵。低秩近似的目标不是逐像素删数据,而是用少量主导结构重建原矩阵。本节用截断 SVD 计算不同秩的参数量、相对误差和重建图像,并据此判断压缩与失真的平衡点。
学习目标
- 把灰度图像表示为矩阵,并解释秩与可压缩结构的关系。
- 使用截断 SVD 构造秩为 的近似矩阵并计算理论参数量。
- 比较不同 下的相对重建误差与视觉质量,选择合理的截断秩。
把图像写成矩阵
设灰度图像有 行、 列像素,可以写成矩阵 。矩阵元素就是像素强度。若相邻区域、纹理和光照存在重复结构,矩阵中的行与列往往不是完全独立,这给低秩表示留下了空间。
SVD 把矩阵分解为:
奇异值按从大到小排列。较大的奇异值对应对图像能量贡献更大的结构;较小的奇异值通常承载更细的纹理和局部变化。保留前 个奇异值,就得到秩不超过 的近似:
在 Frobenius 范数下,截断 SVD 给出了所有秩不超过 的矩阵中误差最小的近似,因此它适合用来观察“保留多少结构才够”。
截断 SVD 如何减少参数
原始矩阵需要保存 个标量。若直接保存 、 和 ,理论上需要:
个标量。只有当 时,低秩表示才在标量数量上真正减少存储。重建质量可用相对 Frobenius 误差衡量:
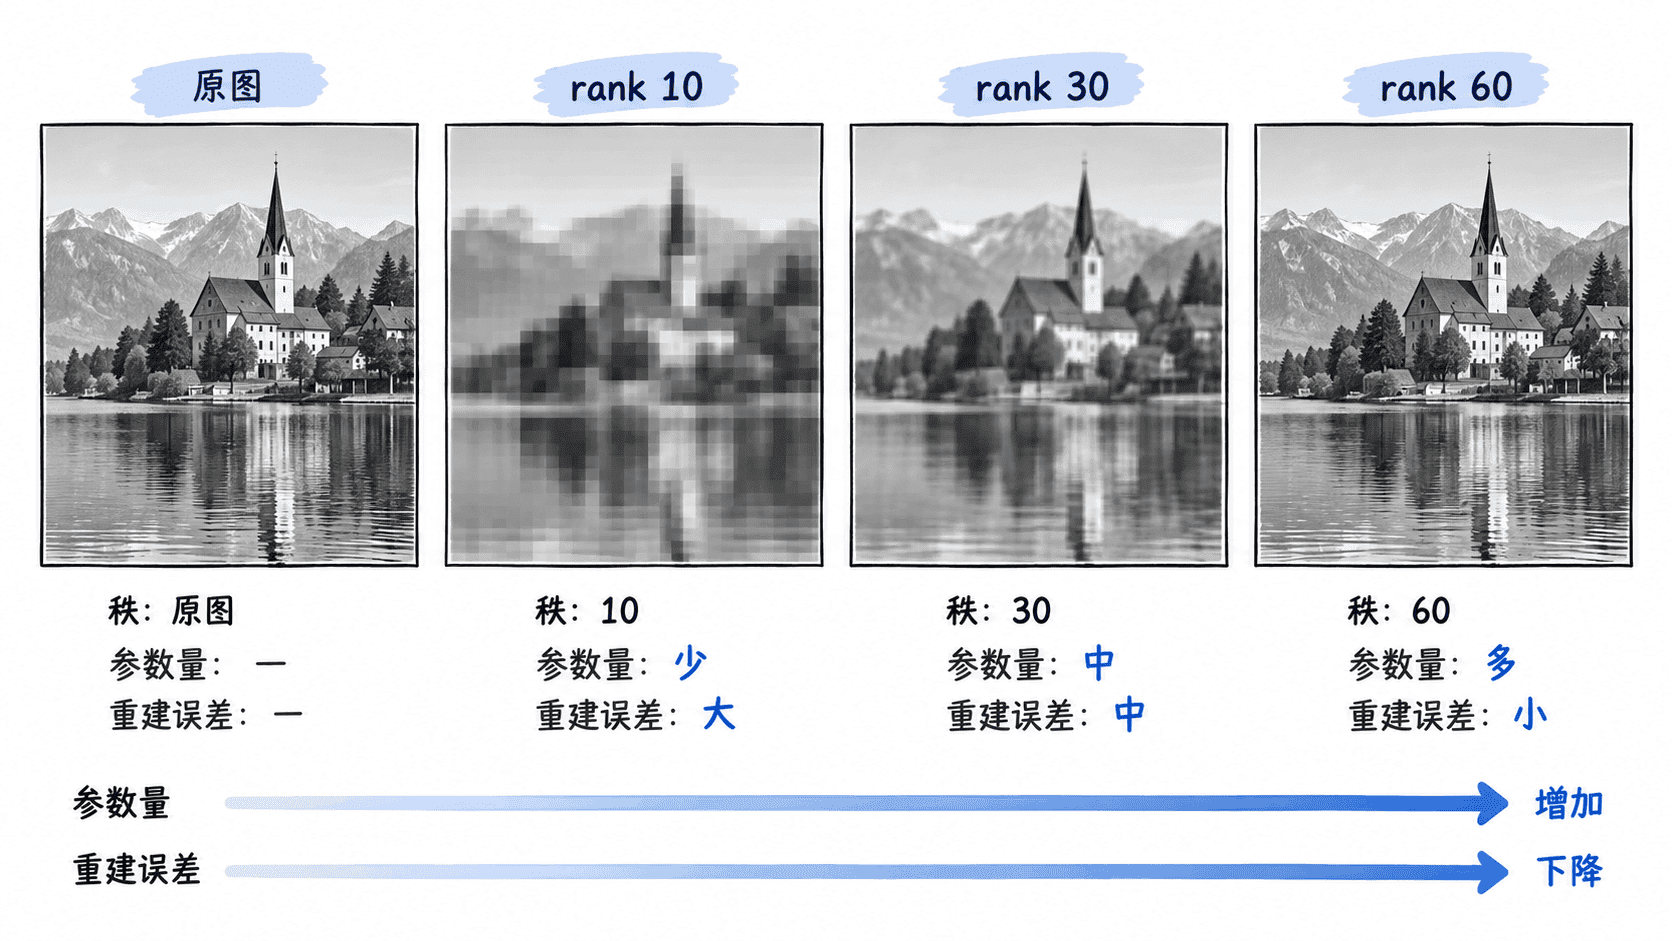
随着 增大,参数量线性上升,而误差不会增大。工程上要找的不是“误差最小”的 ,而是视觉质量已经满足要求、继续增大 收益很小的位置。
用 Python 比较不同秩
下面的完整示例读取一张至少为 像素的图片,转成灰度矩阵,分别用 重建,并输出理论参数比和相对误差。把 <PATH> 替换为本机目录,其中放置 input.png。
from pathlib import Path

import numpy as np
from PIL import Image

image_path = Path('<PATH>/input.png')
output_dir = Path('<PATH>/svd-output')
output_dir.mkdir(parents=True, exist_ok=True)

# 统一转为 0~1 的灰度矩阵,便于比较不同秩的误差。
A = np.asarray(Image.open(image_path).convert('L'), dtype=np.float64) / 255.0
m, n = A.shape
if min(m, n) < 60:
    raise ValueError('image must be at least 60x60 pixels')

# 经济型 SVD 不生成当前重建任务用不到的额外基向量。
U, singular_values, Vt = np.linalg.svd(A, full_matrices=False)
Image.fromarray(np.uint8(np.clip(A, 0.0, 1.0) * 255)).save(output_dir / 'original.png')

print(f'shape={m}x{n}')
for k in (10, 30, 60):
    # 只保留最大的 k 个奇异值及对应奇异向量。
    Ak = (U[:, :k] * singular_values[:k]) @ Vt[:k, :]
    error = np.linalg.norm(A - Ak, ord='fro') / np.linalg.norm(A, ord='fro')

    # 这里只比较标量参数数量,不等同于 PNG/JPEG 文件的真实字节数。
    params = k * (m + n + 1)
    scalar_ratio = (m * n) / params

    reconstructed = np.uint8(np.clip(Ak, 0.0, 1.0) * 255)
    Image.fromarray(reconstructed).save(output_dir / f'rank-{k}.png')
    print(f'rank={k} params={params} scalar_ratio={scalar_ratio:.2f}x relative_error={error:.4f}')

print(f'saved={output_dir}')
预期输出
shape=<HEIGHT>x<WIDTH>
rank=10 params=<COUNT> scalar_ratio=<RATIO>x relative_error=<ERROR>
rank=30 params=<COUNT> scalar_ratio=<RATIO>x relative_error=<ERROR>
rank=60 params=<COUNT> scalar_ratio=<RATIO>x relative_error=<ERROR>
saved=<PATH>/svd-output<HEIGHT>、<WIDTH>、<COUNT>、<RATIO> 和 <ERROR> 会随输入图片变化。输出目录还会生成 original.png、rank-10.png、rank-30.png 和 rank-60.png,可直接并排观察细节恢复过程。
如何选择合适的秩
选择 时应同时看误差曲线、视觉效果和存储目标。若从 增加到 后误差只小幅下降、肉眼几乎看不出提升,就没有必要为更多参数付出存储成本。若主体边缘已经模糊,则说明 仍然过小。
低秩近似真正有价值的地方,是把“图像有多少主要结构”转成可计算的秩和奇异值问题:先用较小的 保留主导信息,再通过误差与视觉结果决定是否继续增加秩。