
C / C++ / 系统课时
fork 为什么会返回两次
fork 为什么会返回两次
fork() 看起来只调用一次,却会让后续代码在两个进程中继续执行,因此常被描述为“返回两次”。关键不是函数在同一进程里返回两遍,而是内核创建子进程后,让父进程和子进程都从 fork() 之后的位置恢复执行,并给出不同返回值。
学习目标
- 理解
fork()创建子进程后为什么会出现两条执行流 - 使用返回值可靠地区分父进程、子进程和创建失败
- 正确认识父子进程的执行顺序与
waitpid()的作用
一次调用会分成两条执行流
调用 fork() 时,当前只有父进程在执行。内核成功创建子进程后,父子进程都会从这次调用的下一条语句继续运行:父进程得到“子进程 PID”,子进程得到 0。如果创建失败,则不会产生子进程,原进程得到 -1。
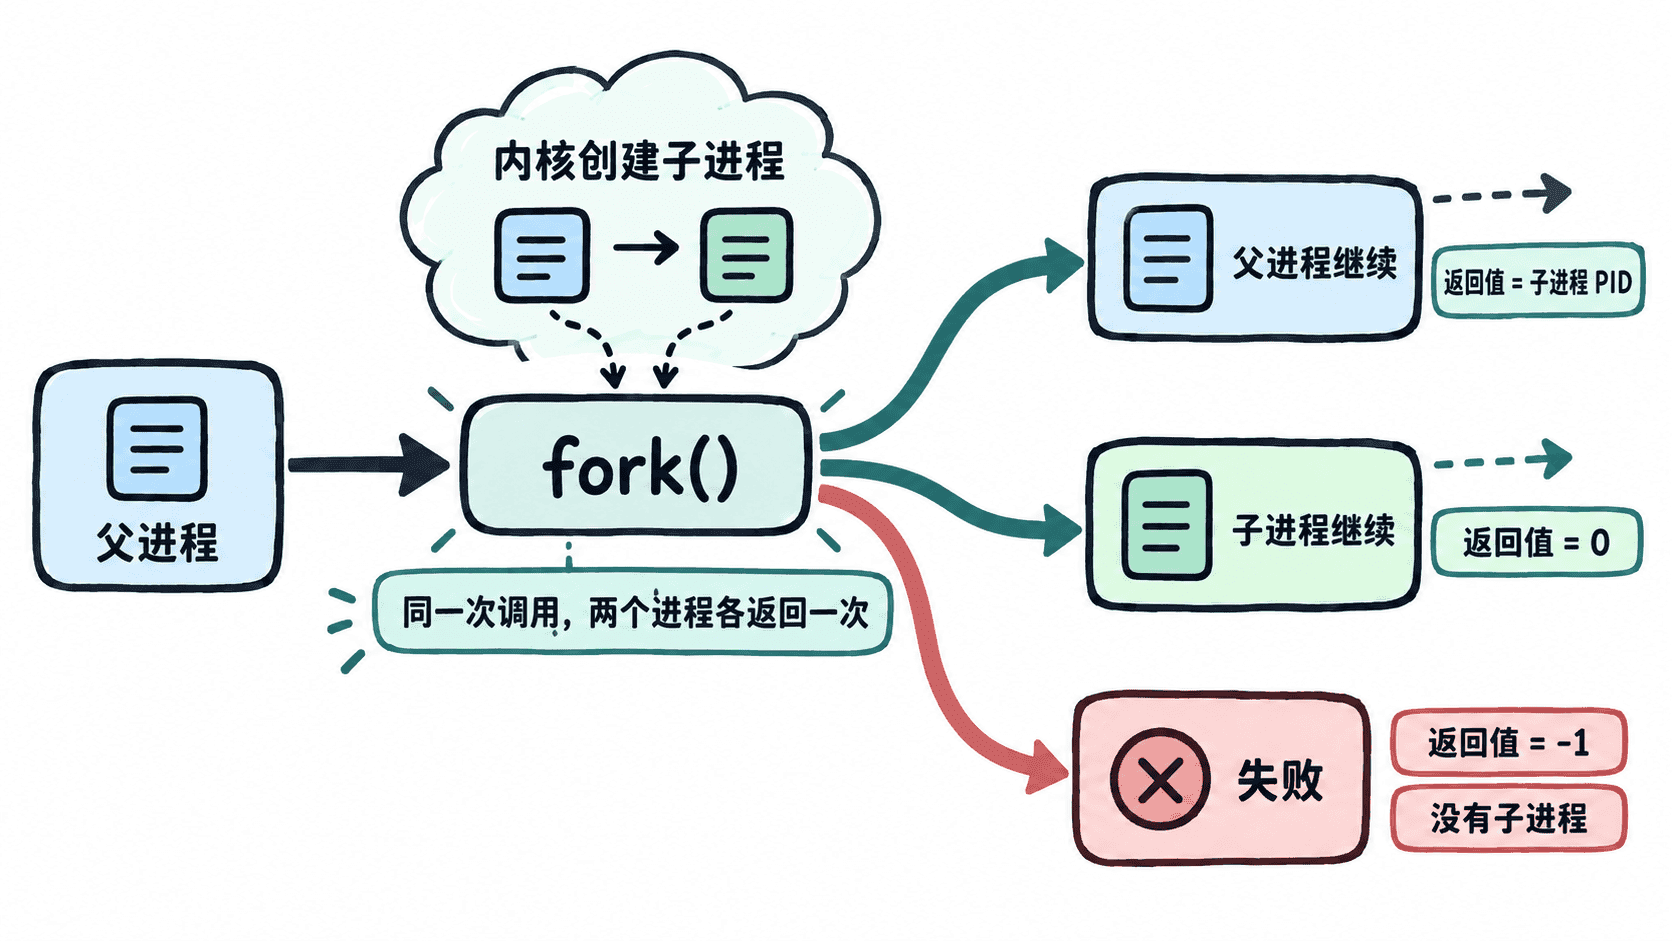
因此,判断分支的标准写法是:返回值小于 0 表示失败,等于 0 表示当前位于子进程,大于 0 表示当前位于父进程。子进程若要知道自己的 PID,应调用 getpid();父进程已经可以直接从 fork() 的返回值获得子进程 PID。
用返回值区分父进程和子进程
下面的程序在 fork() 前先输出父进程 PID,再分别打印父进程与子进程看到的返回值。fflush(stdout) 放在 fork() 前,是为了避免标准输出缓冲区也被复制后造成重复输出。
#include <stdio.h>
#include <stdlib.h>
#include <sys/types.h>
#include <sys/wait.h>
#include <unistd.h>

int main(void) {
    printf("before fork: pid=%ld\n", (long)getpid());
    fflush(stdout);

    pid_t pid = fork();
    if (pid < 0) {
        perror("fork");
        return EXIT_FAILURE;
    }

    if (pid == 0) {
        printf("child: pid=%ld, ppid=%ld, fork returned 0\n",
               (long)getpid(), (long)getppid());
        fflush(stdout);
        _exit(0);
    }

    printf("parent: pid=%ld, child=%ld, fork returned %ld\n",
           (long)getpid(), (long)pid, (long)pid);

    if (waitpid(pid, NULL, 0) < 0) {
        perror("waitpid");
        return EXIT_FAILURE;
    }

    puts("parent: child exited");
    return EXIT_SUCCESS;
}
预期结果
源码应能在提供 POSIX fork/waitpid 接口的系统上编译;运行后会出现 1 条 fork 前输出、1 条父进程输出、1 条子进程输出,以及父进程等待结束后的确认行。编译并运行:
cc -Wall -Wextra -O2 fork_demo.c -o fork_demo
./fork_demo
预期输出
before fork: pid=<ID>
parent: pid=<ID>, child=<ID>, fork returned <ID>
child: pid=<ID>, ppid=<ID>, fork returned 0
parent: child exited
<ID> 每次运行都可能不同,而且中间两行的先后顺序也可能互换;这不是异常,而是调度器决定父进程还是子进程先获得 CPU。最后一行一定发生在目标子进程退出之后,因为父进程调用了 waitpid()。
fork 不复制“接下来谁先运行”的顺序
fork() 只建立父子进程关系,不承诺调度顺序。即使父进程在源码中先进入某个分支,子进程仍可能先打印。需要建立确定的先后关系时,应使用 waitpid()、管道、信号量等同步机制,而不是依赖某次实验里恰好出现的输出顺序。
还要注意标准 I/O 缓冲:如果 fork() 前有尚未刷新的缓冲数据,这份缓冲区会随着用户态内存一起出现在子进程中,父子双方之后都刷新时可能看到重复文本。对需要在创建前立即可见的输出调用 fflush(),或使用明确的进程间同步,可以避免把缓冲行为误判成 fork() 又执行了一次。
记住返回值真正表达的含义
成功时,父进程拿到子进程 PID,是为了后续等待、发送信号或管理该子进程;子进程拿到 0,是为了能走入自己的执行分支。所谓“返回两次”,准确含义就是同一次系统调用成功后,在两个不同进程中各返回一次。