
大模型应用开发 / 系统课时
设计本地知识助手
设计本地知识助手
学习目标
完成本课后,你将能够:
- 把本地知识助手拆分为文档、索引、检索、生成和接口模块
- 为生成模型、嵌入模型和向量存储定义清晰职责
- 设计可追溯、可拒答和可替换的问答链路
- 形成后续实现所需的接口、数据结构和验收标准
项目目标与边界
本项目构建一个完全在本机或内网运行的知识助手。用户导入文本资料后,可以提问并获得基于资料的回答,同时看到引用来源。项目目标:
- 文档在本地处理。
- Ollama 提供嵌入与生成能力。
- 检索结果包含来源和文本块编号。
- 回答只能基于检索上下文。
- 资料不足时明确拒答。
- 后端提供可测试的 HTTP API。
- 后续可以通过 Compose 和反向代理部署。
第一版不包含 OCR、复杂权限、多租户、分布式向量库和生产级前端。先保证完整链路可运行,再逐步工程化。
整体架构
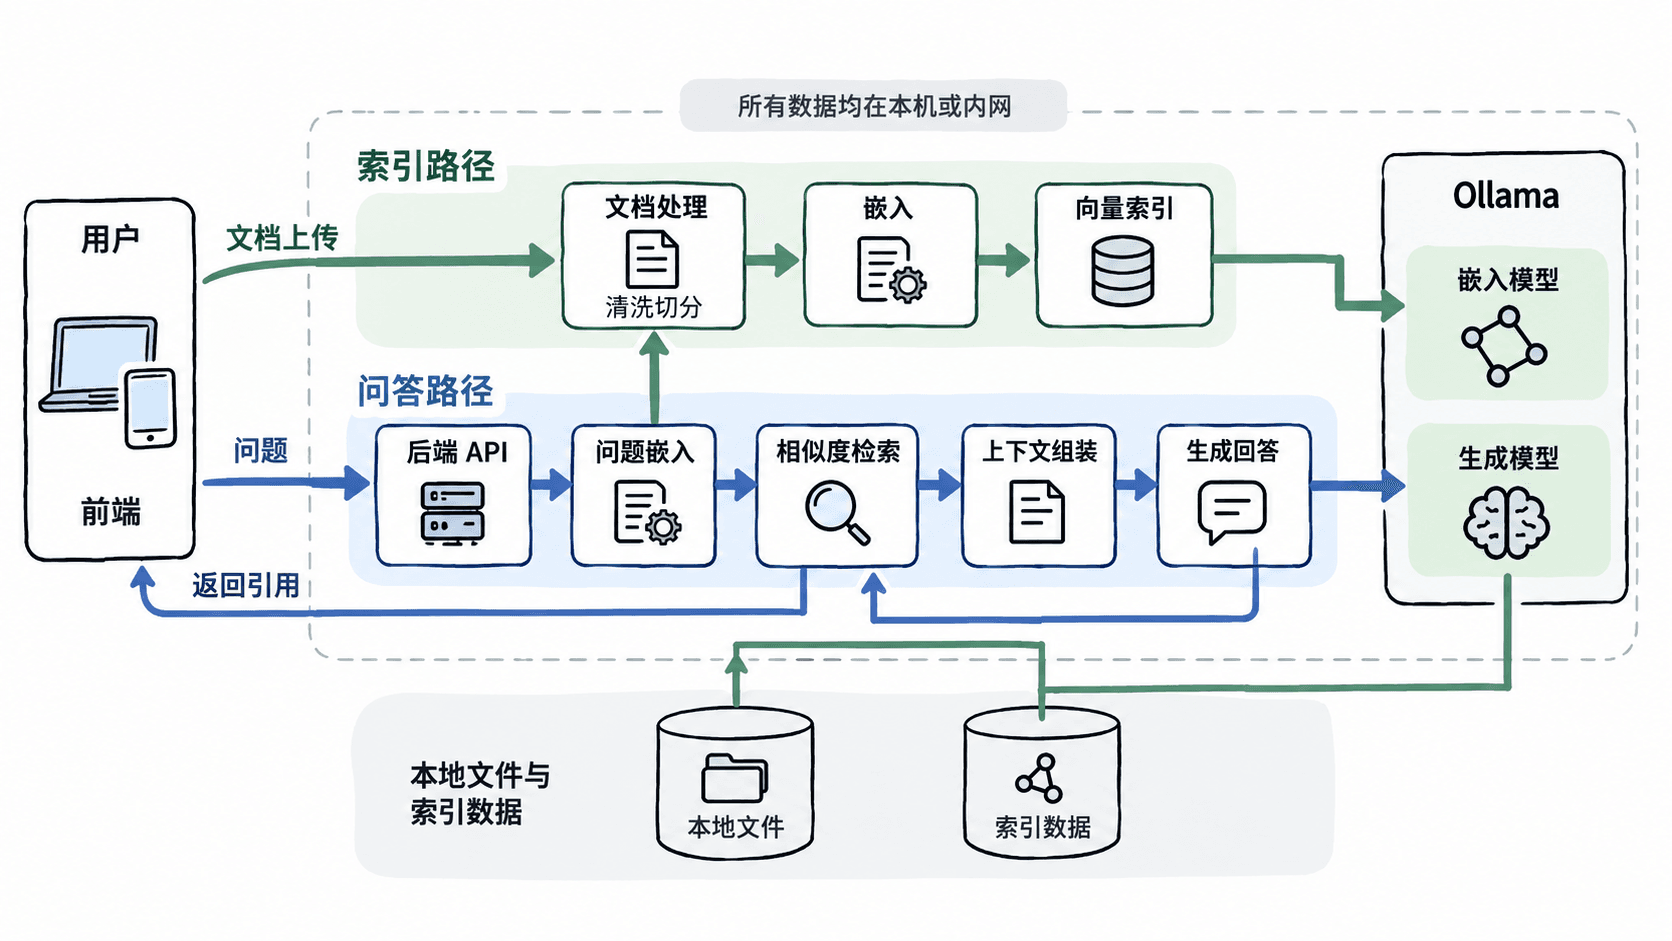
系统分为六个组件:
| 组件 | 职责 | 不应承担 |
|---|---|---|
| 文档接口 | 接收文本与元数据 | 不负责模型推理 |
| 文档处理器 | 清洗、切分、生成块 ID | 不负责最终回答 |
| 嵌入服务 | 把文本转换为向量 | 不直接判断答案 |
| 向量索引 | 保存向量、原文和来源 | 不修改原文 |
| 检索与提示词 | 选择上下文并约束回答 | 不训练模型 |
| 生成服务 | 基于上下文生成答案 | 不替代访问控制 |
清晰职责可以让嵌入模型、向量库或生成模型独立替换。
索引链路
文档导入按以下顺序执行:
原始文档
→ 文本解码
→ 清洗空白与无效字符
→ 按段落和长度切分
→ 生成稳定块 ID
→ 批量调用嵌入模型
→ 保存向量、原文与元数据
→ 返回索引统计
每个文本块至少保存:
chunk_idsourcetitletextembeddingcreated_atdocument_hashembedding_model
document_hash 用于识别重复文档,embedding_model 用于防止把不同维度或不同语义空间的向量混入同一索引。
问答链路
一次问题经历:
用户问题
→ 问题嵌入
→ 相似度检索
→ Top K 与阈值筛选
→ 组装带来源的上下文
→ 调用生成模型
→ 返回回答与引用
回答接口不能只返回一段字符串。推荐返回:
{
  "answer": "<ANSWER>",
  "sources": [
    {
      "chunk_id": "<CHUNK_ID>",
      "source": "<SOURCE>",
      "score": 0.0,
      "text": "<MATCHED_TEXT>"
    }
  ],
  "model": "<GENERATION_MODEL>",
  "retrieval_model": "<EMBEDDING_MODEL>",
  "request_id": "<REQUEST_ID>"
}score、文本和 ID 是动态值。来源信息用于人工核对和后续评测。
模型职责与选择
嵌入模型
要求:
- 适合目标语言
- 输出维度稳定
- 对文档和问题使用同一模型
- 批量接口稳定
- 在目标设备上有足够吞吐
生成模型
要求:
- 指令遵循稳定
- 能按资料回答和拒答
- 支持目标上下文长度
- 中文表达符合业务要求
- 生成速度满足交互需求
嵌入和生成是两种任务,不应默认使用同一个模型。更换嵌入模型后需要重建全部索引;更换生成模型通常不需要重建向量。
索引存储选择
第一版可使用内存加 JSON 文件持久化,便于理解完整算法。数据量增大后再切换向量数据库。
| 方案 | 优点 | 限制 |
|---|---|---|
| 内存列表 | 最简单,便于教学 | 重启丢失,检索为线性扫描 |
| JSON 文件 | 可查看、无外部服务 | 写入和并发能力有限 |
| SQLite 扩展 | 单文件、事务方便 | 向量能力取决于扩展 |
| 专用向量库 | 索引、过滤和扩展能力强 | 增加部署和运维复杂度 |
接口层应封装 add()、search()、delete() 和 stats(),使存储实现可替换。
检索与拒答规则
仅取 Top K 不足以保证相关。应同时使用:
- Top K 上限
- 最低相似度阈值
- 来源过滤
- 重复块去除
- 单来源最大块数
- 上下文总 Token 限制
拒答条件:
- 没有检索结果
- 最高相似度低于阈值
- 上下文不包含问题所需事实
- 来源冲突且无法确定
- 用户要求超出资料范围
系统提示词应明确:“只根据资料回答;资料不足时说明无法从当前资料确定。”但最终可靠性还要通过评测和来源核验保证。
API 设计
第一版提供三个端点:
| 方法 | 路径 | 用途 |
|---|---|---|
POST |
/documents |
导入文本并建立索引 |
POST |
/ask |
检索并生成回答 |
GET |
/health |
检查后端与 Ollama |
POST /documents 请求:
{
  "source": "employee-handbook.txt",
  "title": "员工手册",
  "text": "<DOCUMENT_TEXT>"
}
POST /ask 请求:
{
  "question": "<QUESTION>",
  "top_k": 4
}
配置项包括:
OLLAMA_BASE_URLGENERATION_MODELEMBEDDING_MODELINDEX_PATHCHUNK_SIZECHUNK_OVERLAPMIN_SCORE
配置使用环境变量,不把模型名称和路径散落在业务代码中。
非功能要求
上线前至少考虑:
- 文档大小和类型限制
- 请求认证
- 访问日志脱敏
- 索引备份
- 上传文件恶意内容检查
- 模型和索引版本
- 并发写入控制
- 请求超时与取消
- 来源权限过滤
- 健康检查
- 容量和磁盘告警
本地部署控制了数据路径,但不自动提供这些工程能力。
项目验收标准
项目完成后应满足:
- Ollama 健康检查通过。
- 能导入一份包含多个段落的文档。
- 索引中保存原文、来源和向量。
- 已知问题能检索到正确文本块。
- 回答返回来源。
- 资料外问题明确拒答。
- 重启后索引可以恢复。
- 更换生成模型不需要重建索引。
- 更换嵌入模型时系统阻止使用旧索引。
- 接口错误返回明确状态码和消息。
本课练习
练习 1:绘制系统边界
任务目标:明确每个组件的职责。输入或初始条件:使用本课六个组件。实现要求:画出索引与问答两条数据流。验收条件:每个组件都有输入、输出和不负责的内容。
练习 2:定义索引记录
任务目标:设计可追溯的数据结构。输入或初始条件:文档来自多个文件和版本。实现要求:定义块 ID、来源、哈希、模型和时间字段。验收条件:能够定位回答引用的原始文本。
练习 3:制定拒答规则
任务目标:减少脱离资料的回答。输入或初始条件:准备资料内、资料外和资料冲突三类问题。实现要求:定义检索阈值、提示词和接口结果。验收条件:三类问题都有明确处理策略。