
大模型应用开发 / 系统课时
理解 RAG 工作流程
理解 RAG 工作流程
学习目标
完成本课后,你将能够:
- 说明 RAG 为什么需要检索而不是只依赖模型记忆
- 描述离线索引和在线问答两条链路
- 区分嵌入模型、生成模型和向量存储的职责
- 识别召回错误与生成错误
RAG 解决什么问题
检索增强生成(RAG)先从知识库找到与问题相关的资料,再把资料作为上下文交给生成模型。它适合内部文档、频繁更新知识和需要来源引用的问答。
RAG 不会把文档永久训练进模型。每次请求仍需要检索并提交相关文本。
完整工作流程
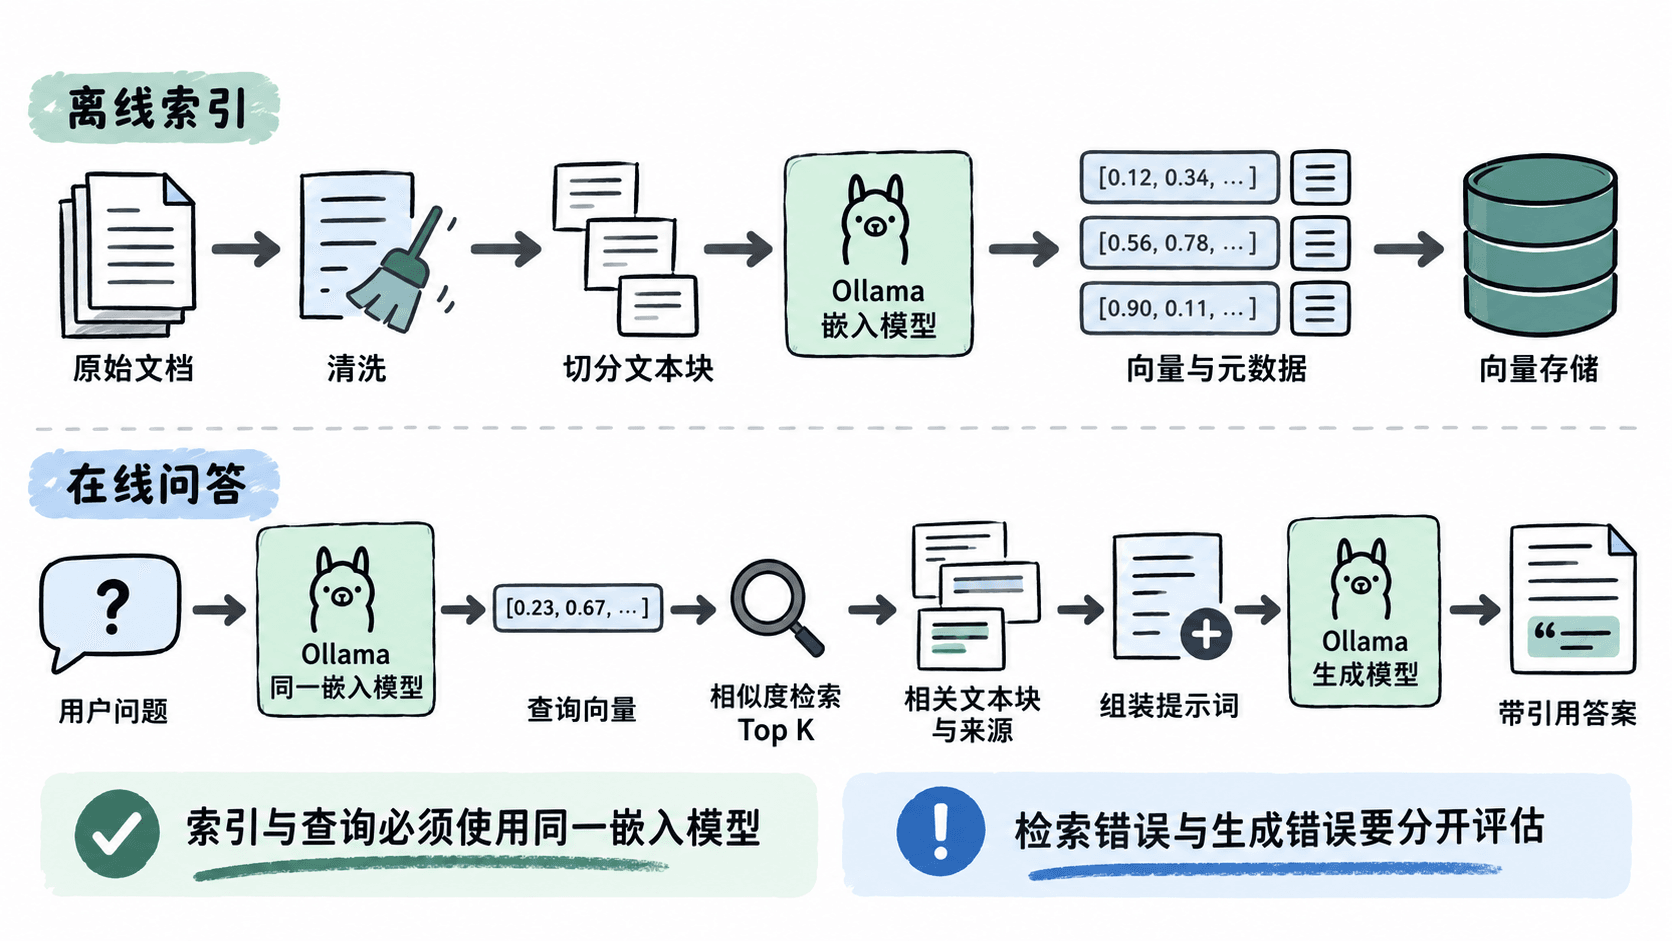
离线索引链路
离线阶段:
- 读取文档。
- 清理导航、页眉、重复空白等噪声。
- 按标题和长度切分。
- 为每个文本块生成嵌入。
- 保存向量、原文和元数据。
- 记录嵌入模型版本。
- 建立更新与删除机制。
元数据至少包含文档 ID、来源、标题、块序号和更新时间。
在线问答链路
在线阶段:
- 接收用户问题。
- 使用同一嵌入模型生成查询向量。
- 在向量存储中检索候选文本块。
- 根据分数、权限和元数据过滤。
- 组装来源与问题。
- 调用生成模型。
- 返回答案和引用。
- 记录检索与回答质量。
权限过滤必须在把文本交给模型之前完成。
组件职责
| 组件 | 职责 |
|---|---|
| 文档解析器 | 把 PDF、Markdown、网页等变为文本 |
| 切分器 | 生成适合检索的文本块 |
| 嵌入模型 | 把文本和查询转为向量 |
| 向量存储 | 保存并搜索向量 |
| 检索器 | Top K、过滤、去重和重排 |
| 生成模型 | 根据检索上下文回答 |
| 应用服务 | 权限、日志、缓存、引用和错误处理 |
Ollama 可提供嵌入模型和生成模型运行服务,但不自动完成全部知识库工程。
两类主要错误
检索错误:
- 相关文档没有被召回
- 无关块排名过高
- 权限过滤错误
- 文档版本过期
- 切分破坏语义
生成错误:
- 忽略检索资料
- 混合多个来源
- 编造资料中不存在的结论
- 引用错位
- 无资料时仍强行回答
评估时先检查检索结果,再检查模型回答。
RAG 与长上下文
把整库文档放入超长上下文通常会带来高内存、长预填充、噪声干扰和成本。RAG 通过检索缩小上下文,但会引入召回错误。实际系统可以组合:
- 元数据过滤
- 向量检索
- 关键词检索
- 重排
- 长上下文
- 对话摘要
选择取决于数据规模和准确性要求。
最小验收标准
一个可用 RAG 原型至少做到:
- 文档可以新增、更新和删除。
- 查询返回相关文本块。
- 回答只基于提供资料。
- 答案包含可追溯来源。
- 无资料时明确拒答。
- 用户只能检索有权限的文档。
- 索引模型和版本可追踪。
本课练习
练习 1:绘制组件图
任务目标:理解各组件职责。输入或初始条件:选择一个内部文档问答场景。实现要求:画出索引与查询链路。验收条件:嵌入模型和生成模型分开标注。
练习 2:分析失败案例
任务目标:区分检索与生成问题。输入或初始条件:准备一个错误答案及其检索结果。实现要求:判断根因并提出修复。验收条件:不把所有问题归因于生成模型。
练习 3:定义知识库验收
任务目标:建立可执行标准。输入或初始条件:准备 20 个真实问题。实现要求:定义召回、引用、拒答和权限指标。验收条件:每项可通过数据计算。
按自己的节奏,确认真正理解。