
大模型应用开发 / 系统课时
本地推理的工作流程
本地推理的工作流程
学习目标
完成本课后,你将能够:
- 描述一次本地模型请求从输入到输出的完整链路
- 区分模型下载、模型加载和文本生成三个阶段
- 解释 Token、上下文窗口和 KV Cache 在推理中的作用
- 根据不同阶段判断首次请求慢、持续占用内存等现象的原因
一次请求经历哪些阶段
用户在终端输入问题,或应用向 Ollama API 发送请求后,通常会经历以下阶段:
- 定位目标模型。
- 检查本地是否已有模型文件。
- 将模型权重加载到系统内存或显存。
- 按模型模板组织系统消息、历史消息和当前问题。
- 将文本转换为 Token。
- 执行预填充计算,处理已有上下文。
- 逐个生成新的 Token。
- 将 Token 解码为文本并流式返回。
- 根据驻留策略保留或卸载模型。
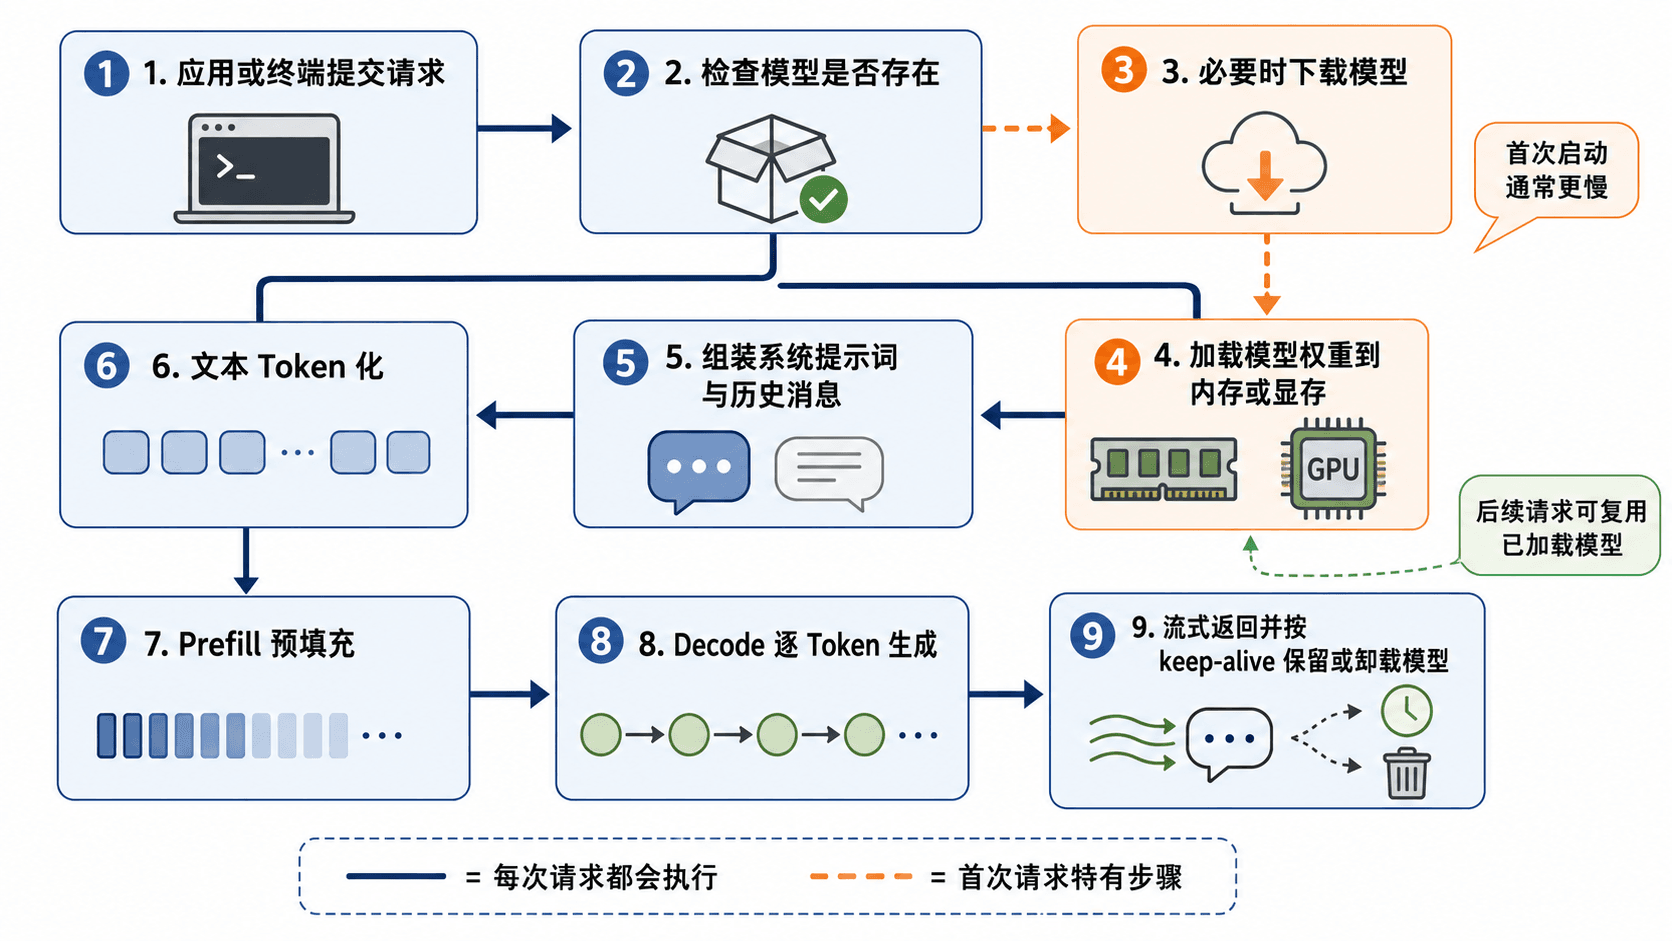
阶段一:定位和获取模型
请求中必须指定模型名称。Ollama 首先检查本地模型存储中是否存在对应名称和标签。
如果模型已经存在,可以进入加载阶段。如果模型不存在,使用 ollama run 时通常会先拉取模型;通过 API 请求一个本地不存在的模型时,则可能直接返回模型不存在错误,需要先执行下载。模型下载与模型运行是两个不同动作:
| 动作 | 主要工作 | 典型资源 |
|---|---|---|
| 下载模型 | 从模型仓库获取清单和数据分层并写入磁盘 | 网络、磁盘 |
| 加载模型 | 将模型权重映射或复制到可用内存 | 系统内存、显存 |
| 执行推理 | 对输入进行计算并逐步生成 Token | CPU、GPU、内存带宽 |
因此,下载完成只说明磁盘上已有模型文件,不代表模型已经进入内存。
阶段二:加载模型权重
模型开始运行时,Ollama 会根据模型大小、量化等级、可用显存和硬件支持情况决定权重放置位置。常见状态包括:
- 完全加载到 GPU 显存
- 部分加载到 GPU,剩余部分位于系统内存
- 完全使用 CPU 和系统内存
模型加载会产生明显的启动延迟。第一次请求通常比后续请求慢,是因为第一次请求可能同时包含模型加载和上下文预填充。模型在内存中保持驻留时,后续请求可以跳过大部分加载过程。可以使用以下命令查看当前已加载模型:
ollama ps预期输出示例:
NAME       ID          SIZE      PROCESSOR    CONTEXT    UNTIL
<MODEL>    <MODEL_ID>  <SIZE>    <PROCESSOR>  <CONTEXT>  <UNTIL>
实际列名和内容可能随 Ollama 版本变化。重点检查模型名称、处理器分布和预计卸载时间。
阶段三:组装提示词
应用提交的内容不一定会原样送入模型。Ollama 会根据模型模板,将以下信息组织成模型能够识别的输入格式:
- 系统消息
- 历史用户消息
- 历史助手消息
- 当前用户问题
- 工具定义或图片信息
- 模型要求的特殊起止标记
不同模型使用的模板可能不同。直接把一个模型的模板套到另一个模型上,可能导致角色混乱、输出异常或无法正确停止生成。
阶段四:文本转换为 Token
模型不直接处理汉字或英文单词,而是处理 Token ID。分词器会把文本拆成模型词表中的单元,再转换为数字。
例如,“本地模型部署”可能被拆成多个 Token,但具体拆分结果取决于模型使用的分词器,不能简单理解为“一个汉字等于一个 Token”或“一个英文单词等于一个 Token”。Token 数量会直接影响:
- 上下文占用
- 预填充时间
- KV Cache 大小
- 可继续生成的长度
- 请求成本和吞吐量
阶段五:Prefill 预填充
预填充阶段会一次性处理系统提示词、历史消息和当前输入,建立后续生成需要的内部状态。
输入越长,预填充计算通常越多。长文档问答首字返回慢,往往不是模型“没有开始工作”,而是模型正在处理大量输入 Token。预填充阶段关注两个指标:
- 首字延迟:从提交请求到收到第一个输出 Token 的时间
- 输入处理速度:每秒处理多少输入 Token
阶段六:Decode 逐 Token 生成
预填充完成后,模型开始逐步预测下一个 Token。每生成一个 Token,都要结合当前上下文继续计算,再把新 Token 加入上下文。
这一阶段通常决定用户看到的持续输出速度。生成速度常用“每秒输出 Token 数”衡量。
流式输出并不代表模型一次生成了整段文本。更常见的过程是:
预测下一个 Token
→ 更新上下文状态
→ 返回新增内容
→ 再预测下一个 Token
→ 直到遇到停止条件
停止条件可能包括:
- 生成结束标记
- 命中停止词
- 达到最大输出长度
- 客户端取消请求
- 服务端异常
- 上下文达到限制
上下文窗口与 KV Cache
上下文窗口限制一次推理可以处理的 Token 总量。总量通常包括系统提示词、历史消息、当前输入和已经生成的输出。
KV Cache 保存注意力计算中的中间结果,使模型生成后续 Token 时不必重复计算全部历史内容。它能提升生成效率,但会消耗内存或显存。上下文越长,通常意味着:
- 可以保留更多历史信息
- 预填充时间增加
- KV Cache 占用增加
- 可支持的并发请求减少
- 发生内存不足的概率上升
因此,不应在所有任务中盲目把上下文设置到设备可支持的最大值。
流式返回与完整返回
Ollama API 通常可以逐块返回生成结果,也可以关闭流式响应后一次返回完整结果。
| 方式 | 优点 | 代价 |
|---|---|---|
| 流式返回 | 用户更早看到内容,适合聊天界面 | 客户端需要持续解析数据块 |
| 完整返回 | 解析简单,适合短任务和自动化处理 | 必须等待生成结束后才能看到内容 |
流式返回只改变结果传输方式,不会降低模型实际需要的计算量。
模型何时被卸载
请求完成后,Ollama 可以让模型继续驻留一段时间,以减少下一次请求的加载延迟。也可以立即卸载模型,释放内存和显存。这形成一个典型取舍:
- 保持驻留:后续请求更快,但持续占用资源
- 立即卸载:释放资源,但下一次请求需要重新加载
可以使用以下命令主动停止已加载模型:
ollama stop <MODEL>预期结果:
命令正常结束,随后执行 ollama ps 时不再显示 <MODEL>。<MODEL> 替换为实际模型名称。
根据现象定位阶段
| 现象 | 优先检查的阶段 |
|---|---|
| 模型下载长时间没有进度 | 网络、模型仓库、磁盘空间 |
| 首次请求很慢,后续请求明显变快 | 模型加载、首次预填充 |
| 输入文档越长,首字越慢 | Token 数量、预填充、上下文 |
| 输出开始后速度一直较慢 | Decode 计算、GPU 使用情况、模型规模 |
| 请求结束后显存仍被占用 | 模型驻留策略 |
| 对话进行一段时间后忘记早期内容 | 上下文窗口、历史裁剪 |
| 直接返回模型不存在 | 本地模型清单、名称和标签 |
本课练习
练习 1:绘制请求链路
任务目标:掌握本地推理阶段。初始条件:一个聊天应用通过 API 向本机 Ollama 提交问题。
实现要求:画出从请求进入到结果返回的流程,并标出磁盘、内存、显存和网络分别在哪些阶段参与。
验收条件:至少包含模型定位、加载、Token 化、预填充、生成和返回六个阶段。
练习 2:分析首次请求慢
任务目标:区分模型加载和文本生成耗时。初始条件:同一个模型第一次响应需要 18 秒,第二次只需要 4 秒,输入内容相同。实现要求:给出最可能原因,并设计验证步骤。
验收条件:验证步骤必须包含 ollama ps、模型驻留状态和重复请求对比。
练习 3:优化长对话
任务目标:理解上下文增长的影响。初始条件:对话轮数增加后,首字延迟持续上升,显存占用也增加。
实现要求:提出历史裁剪、摘要、上下文长度和会话重建方面的优化方案。
验收条件:至少给出 3 项措施,并说明每项措施解决的具体问题。