
大模型应用开发 / 系统课时
模型参数量与量化等级
模型参数量与量化等级
学习目标
完成本课后,你将能够:
- 解释参数量、数值精度和量化的含义
- 根据模型标签识别常见参数规模和量化等级
- 粗略估算模型权重的存储与内存需求
- 在质量、速度和资源占用之间选择合适的模型版本
参数量表示什么
模型参数是训练后保存的数值,决定模型内部如何处理输入并生成输出。模型名称中的 1b、7b、14b、32b 等通常表示参数数量级:
1b:约 10 亿参数7b:约 70 亿参数14b:约 140 亿参数32b:约 320 亿参数
参数更多通常意味着模型容量更大,但不能直接得出“参数越多一定越好”的结论。模型架构、训练数据、训练方法、任务类型、上下文能力和对齐方式都会影响最终表现。
同一系列中,大模型通常具备更强的复杂任务能力,但也需要更多存储、内存、显存和计算时间。
数值精度决定单个参数占用
参数需要使用某种数值格式保存。不同精度占用空间不同:
| 格式 | 理论位宽 | 每个参数理论占用 | 特点 |
|---|---|---|---|
| FP32 | 32 bit | 4 字节 | 精度高,资源占用大 |
| FP16/BF16 | 16 bit | 2 字节 | 常用于训练和高精度推理 |
| INT8 | 8 bit | 约 1 字节 | 资源占用降低 |
| 4-bit 量化 | 约 4 bit | 约 0.5 字节 | 本地推理常见,体积更小 |
理论权重大小可以粗略计算:
权重理论大小
≈ 参数数量 × 位宽 ÷ 8
例如,7B 参数模型以 FP16 保存:
7,000,000,000 × 16 ÷ 8
≈ 14 GB
如果使用 4-bit 量化:
7,000,000,000 × 4 ÷ 8
≈ 3.5 GB
实际文件大小不会与理论值完全一致,因为还包含量化分组、元数据、词表和其他结构。
什么是量化
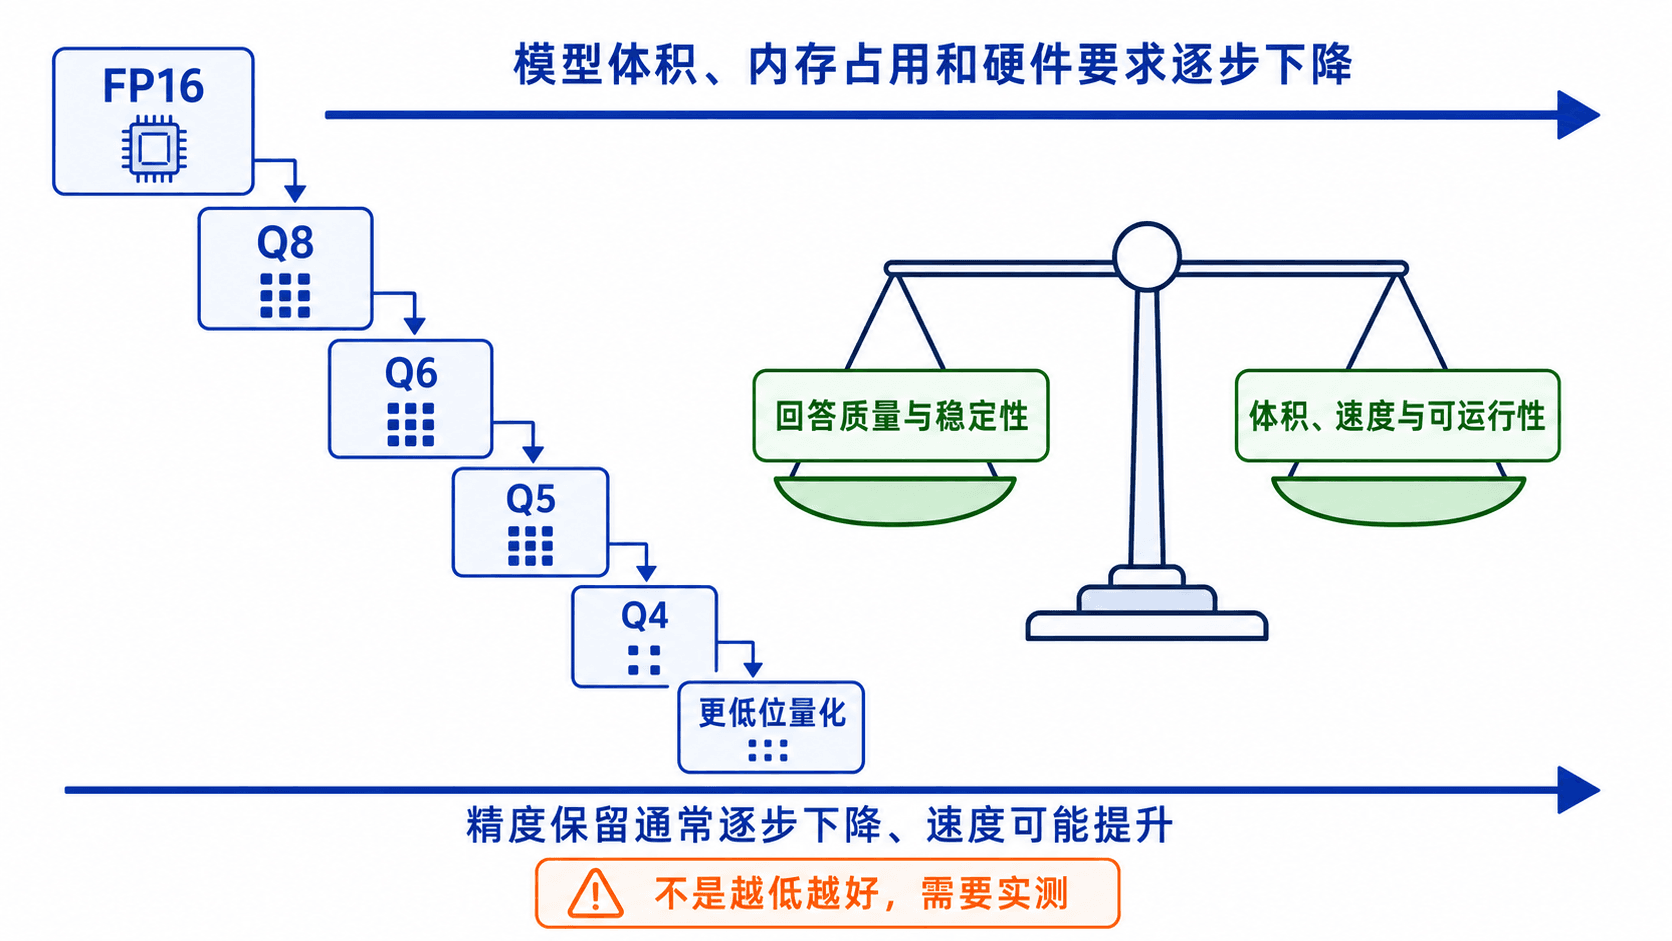
量化是把模型参数从较高精度转换为较低位宽表示的方法。它的目标是减少模型文件大小、内存占用和计算成本,使模型可以在资源有限的设备上运行。量化会带来典型取舍:
- 位宽降低,模型更小
- 内存和显存需求下降
- 加载速度可能改善
- 推理吞吐可能提升
- 部分任务的输出质量可能下降
量化不是压缩包。模型运行时会直接使用量化后的权重格式执行计算,而不是先还原成完整 FP16 文件。
读懂常见量化标签
Ollama 模型详情中可能显示类似以下量化等级:
Q4_K_M可以把它分为三个部分理解:
Q4:主体使用约 4-bit 量化K:采用 K-quant 系列量化方法M:该系列中的一种混合配置
不同模型库可能提供 Q4_K_M、Q5_K_M、Q6_K、Q8_0 等变体。数字通常越高,精度保留和资源占用也越高,但不能只根据名称判断最终回答质量。
对多数本地入门设备,Q4_K_M 常被用作质量和资源之间的起点;对质量要求更高且资源充足的设备,可以测试更高位量化版本。
查看模型的参数量和量化等级
下载模型后,可以使用:
ollama show <MODEL>预期输出中通常会包含模型架构、参数规模、上下文长度、嵌入长度和量化等级等信息。示意如下:
Model
  architecture        <ARCHITECTURE>
  parameters          <PARAMETER_SIZE>
  context length      <CONTEXT_LENGTH>
  embedding length    <EMBEDDING_LENGTH>
  quantization        <QUANTIZATION_LEVEL>
<MODEL> 替换为实际模型名称,具体字段和格式可能随模型与 Ollama 版本变化。也可以通过模型列表 API 查看本地模型详情:
curl http://localhost:11434/api/tags预期响应结构示例:
{
  "models": [
    {
      "name": "<MODEL>",
      "size": 0,
      "details": {
        "parameter_size": "<PARAMETER_SIZE>",
        "quantization_level": "<QUANTIZATION_LEVEL>"
      }
    }
  ]
}
size 的实际值为模型文件字节数,不会固定为 0。这里使用 0 表示需要以真实响应为准。
参数量与量化共同决定基础占用
模型选择不能只看参数量,也不能只看量化等级。例如:
| 模型版本 | 参数规模 | 量化 | 资源趋势 |
|---|---|---|---|
| A | 7B | Q8 | 参数较少,但量化位宽较高 |
| B | 14B | Q4 | 参数更多,但单参数占用较低 |
| C | 32B | Q4 | 模型容量更大,整体占用仍显著增加 |
7B Q8 和 14B Q4 的理论权重体积可能接近,但它们的模型能力、计算量和运行表现并不相同。参数更多的模型即使文件大小接近,也可能需要更多计算。
运行占用为什么高于模型文件
运行时资源还要包含:
- 模型元数据
- KV Cache
- 输入和输出缓冲区
- 运行后端工作区
- 并发请求状态
- Ollama 服务进程
- 操作系统和业务应用
因此,判断设备能否运行模型时,应给模型文件大小之外留出明显余量。
上下文越长、并发越高,额外占用通常越大。不能使用“模型文件刚好小于显存”作为可靠的可运行判断标准。
量化等级如何选择
1. 先确定模型能力是否满足任务
先比较模型系列、参数规模和任务表现,再比较量化。一个不适合任务的模型,即使使用高精度版本也可能无法解决问题。
2. 以能稳定运行的版本为起点
选择能在设备上稳定加载,并能为上下文和应用预留资源的量化版本。不要让模型权重占满全部内存或显存。
3. 使用真实任务评测
准备一组固定测试问题,比较不同量化版本:
- 事实准确性
- 指令遵循
- 中文表达
- 代码正确性
- 结构化输出成功率
- 首字延迟
- 生成速度
- 峰值内存和显存
4. 不为追求体积盲目降低量化
极低位量化可能在复杂推理、代码生成、长文本和小概率知识上产生更明显的质量损失。只有经过任务评测后才能判断是否可接受。
一个可执行的选择流程
- 明确任务需要对话、代码、推理、视觉还是嵌入能力。
- 从模型系列中选择多个候选参数规模。
- 排除设备完全无法容纳的版本。
- 从中等量化版本开始测试。
- 记录质量、速度、内存和显存。
- 资源有余量且质量不足时,测试更大模型或更高位量化。
- 资源紧张时,测试更小模型、较低位量化或更短上下文。
- 固定最终模型名称、标签和评测结果。
常见错误
错误 1:只看参数量选模型
原因:参数量不能代表训练质量、任务适配和量化损失。修复:使用固定业务样例进行模型评测。
错误 2:把模型文件大小当作显存需求
原因:运行时还需要 KV Cache 和工作区。修复:实际加载模型,并记录峰值显存和目标上下文下的占用。
错误 3:认为 Q4 一定比 Q8 快一倍
原因:实际速度受硬件、实现、内存带宽和模型架构影响。
修复:在目标设备上测试首字延迟和每秒输出 Token。
错误 4:模型能启动就直接上线
原因:低并发短问题能够运行,不代表长上下文和多用户情况下稳定。
修复:使用目标上下文、输出长度和并发量进行压力测试。
本课练习
练习 1:计算理论权重大小
任务目标:掌握参数量与位宽的换算。初始条件:一个 8B 参数模型分别使用 FP16、INT8 和 4-bit 表示。实现要求:计算三种格式的理论权重大小。
验收条件:写出计算过程,并明确实际运行占用会高于理论值。
练习 2:比较两个候选版本
任务目标:建立模型选择标准。初始条件:设备能够运行 7B Q8 和 14B Q4 两个版本。
实现要求:设计一组包含质量、速度和资源指标的对比测试。
验收条件:至少包含 5 个任务质量指标和 3 个性能指标。
练习 3:制定量化升级策略
任务目标:在资源允许时提高质量。初始条件:当前使用 Q4 版本,显存仍有余量,但代码生成质量不稳定。实现要求:说明下一步测试顺序和停止升级的判断标准。
验收条件:方案必须包含更高位量化、固定测试集、显存安全余量和性能回退条件。