
大模型应用开发 / 系统课时
Ollama 的定位与适用场景
Ollama 的定位与适用场景
学习目标
完成本课后,你将能够:
- 准确说明 Ollama 在本地大模型技术栈中的位置
- 区分 Ollama、模型文件、聊天界面和应用框架的职责
- 根据隐私、网络、硬件和运维条件判断是否适合使用 Ollama
- 识别不应把 Ollama 当作模型训练平台或完整业务系统的场景
Ollama 解决的核心问题
直接在个人电脑或服务器上运行大语言模型,通常要处理模型格式、运行库、GPU 驱动、推理参数、服务端口和模型文件管理等问题。Ollama 将这些环节封装为统一的命令行工具和本地服务,使开发者可以用较少的配置完成模型下载、启动、对话和 API 调用。
Ollama 的核心价值不是“创造一个新的大模型”,而是降低已有模型在本地设备上的运行与接入成本。安装完成后,开发者通常可以通过一条命令运行模型,也可以通过本地 HTTP API 将模型接入自己的程序。
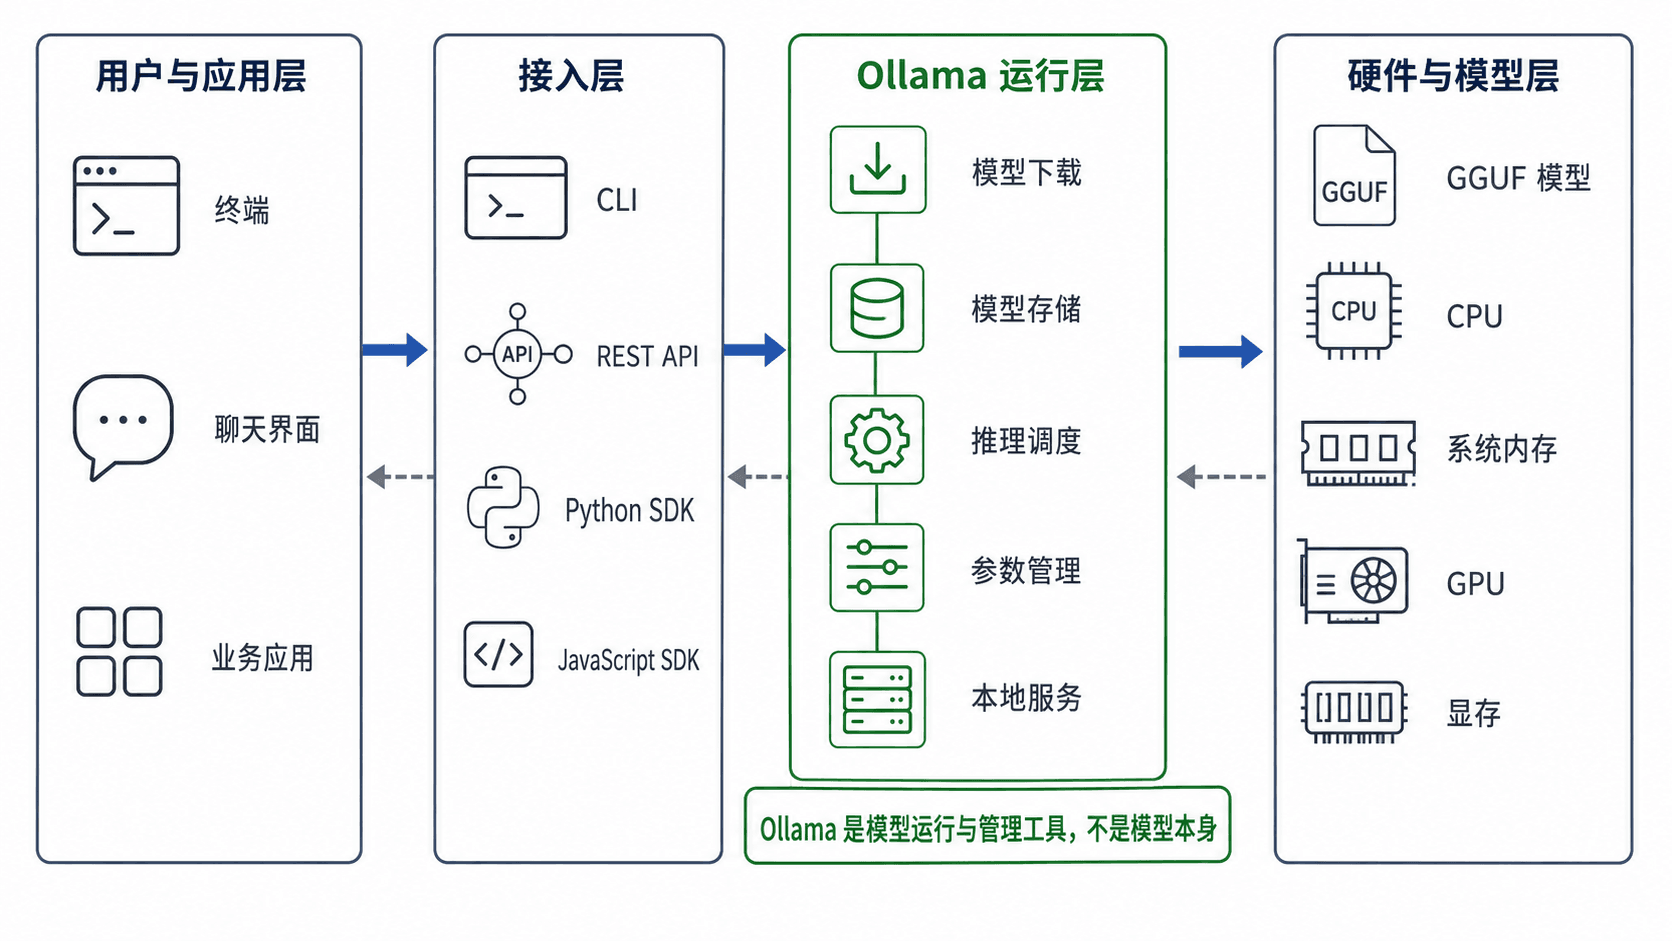
Ollama 在技术栈中的职责
可以把本地大模型应用拆成四个层次:
| 层次 | 典型内容 | Ollama 是否负责 |
|---|---|---|
| 模型层 | Gemma、Qwen、Llama 等模型权重 | 不负责训练模型,但负责获取、保存和加载可用模型 |
| 推理运行层 | 模型加载、Token 生成、CPU/GPU 调度 | 负责 |
| 接入层 | CLI、本地 HTTP API、官方 SDK | 负责 |
| 业务应用层 | 聊天页面、知识库、Agent、权限和审计 | 不直接负责,需要由应用实现或接入其他工具 |
Ollama 主要覆盖“推理运行层”和“接入层”。它会管理模型文件,并在本机启动服务,但不会自动替你完成用户系统、业务数据库、访问控制、知识库检索和生产监控。
Ollama 不是什么
1. Ollama 不是大模型本身
运行 ollama run <MODEL> 时,Ollama 负责下载并运行指定模型。模型的知识、语言能力、推理水平和上下文能力主要由模型本身决定。更换 Ollama 版本不会自动让同一个模型具备完全不同的知识能力。
2. Ollama 不是模型训练平台
Ollama 可以导入模型、量化模型、加载适配器并通过 Modelfile 固化配置,但它不等同于完整的预训练或微调框架。需要训练模型时,通常仍要使用 PyTorch、Transformers、PEFT、DeepSpeed 等训练工具,再把产物导入 Ollama。
3. Ollama 不是完整聊天产品
Ollama 提供交互式命令行和 API,但完整聊天产品通常还需要:
- 用户登录和权限控制
- 会话历史持久化
- 文件上传与解析
- 内容审核
- 请求限流
- 监控告警
- 多用户资源隔离
4. Ollama 不保证所有模型都能在任意设备上流畅运行
模型能否启动以及生成速度如何,取决于模型大小、量化等级、上下文长度、系统内存、显存和硬件支持情况。能够下载模型不等于当前设备一定能高效运行模型。
典型适用场景
1. 个人学习与原型验证
学习者可以在本机快速体验不同模型,比较回答质量、提示词效果和推理参数,而不必先搭建复杂的推理服务。适用判断:
- 需要快速验证模型能力
- 请求量较低
- 可以接受单机资源限制
- 希望减少外部 API 依赖
2. 隐私敏感的本地处理
当输入包含内部文档、源代码、会议记录或未公开业务数据时,本地推理可以减少数据离开设备或内网的机会。
需要注意:本地部署只是降低外发风险,不代表系统自动安全。远程监听、日志、聊天界面、反向代理和第三方插件仍可能产生新的数据暴露路径。
3. 离线或弱网络环境
模型下载完成后,本地模型可以在无互联网环境中继续运行。适合实验室、封闭网络、现场设备和网络不稳定的开发环境。离线前应确认:
- 模型已完整下载
- 运行依赖已安装
- 应用不会强制调用外部服务
- 文档、依赖包和配置已准备
4. 开发阶段的本地 API 替代
应用可以先通过 Ollama 的本地 API 完成聊天、结构化输出、嵌入或工具调用功能,再根据上线需求决定继续本地部署还是切换到其他模型服务。
5. 企业内网模型服务
企业可以在受控服务器上运行 Ollama,供少量内部工具调用。此时必须补充认证、TLS、访问控制、限流、日志和资源隔离,不能直接把默认端口暴露到公网。
不适合直接使用 Ollama 的场景
以下情况不应仅靠默认 Ollama 服务直接上线:
- 需要大规模并发、严格服务等级协议和自动扩缩容
- 需要跨机多 GPU 分布式推理
- 需要完整的多租户计费、权限和审计
- 硬件无法容纳目标模型
- 必须使用尚未被当前运行环境支持的模型能力
- 团队没有能力维护驱动、磁盘、模型版本和服务安全
这并不代表 Ollama 完全不能参与这些系统,而是需要在它外部增加网关、调度、认证、监控和业务服务,或选择更适合大规模推理的基础设施。
使用 Ollama 的判断清单
满足越多条件,越适合优先使用 Ollama:
- 数据希望留在本机或企业内网
- 已有可用的 CPU、内存或 GPU 资源
- 并发规模较小或可以排队
- 能接受模型首次加载时间
- 需要快速切换和验证多个模型
- 应用可以通过本地 API 或 SDK 接入
- 团队能够维护模型文件和运行环境
以下任一条件成立时,应先做专项评估:
- 目标模型需要的内存或显存超过设备能力
- 服务必须直接对公网开放
- 请求峰值不可预测
- 业务要求高可用和跨节点容灾
- 输入包含必须审计的敏感数据
本课练习
练习 1:判断工具职责
任务目标:区分 Ollama 与模型、聊天界面和业务应用。
初始条件:某团队已经安装 Ollama,并运行了一个模型,但希望自动获得用户登录、历史会话和权限管理。
实现要求:写出 Ollama 已经解决的能力和仍需开发的能力。
验收条件:至少列出 3 项 Ollama 负责的能力和 3 项业务系统负责的能力。
练习 2:分析本地部署价值
任务目标:判断一个内部代码问答工具是否适合本地运行。
初始条件:代码不能发送到外部服务,使用人数为 8 人,服务器拥有一张可用 GPU。
实现要求:从隐私、硬件、并发和运维四个维度给出结论。
验收条件:结论中必须同时包含适合使用的原因和上线前必须补充的措施。
练习 3:识别不合理方案
任务目标:发现默认部署方案的风险。初始条件:开发者准备把 Ollama 默认端口直接映射到公网,让所有客户调用。
实现要求:列出安全、稳定性和资源方面的风险,并提出替代架构。
验收条件:至少包含认证、HTTPS、限流和访问范围四项整改措施。