
游戏客户端架构 / 系统课时
骨骼太多会怎样影响运行时开销
骨骼太多会怎样影响运行时开销
角色骨骼数量增加后,动画不一定立即变卡,但姿态计算、动画混合、蒙皮变形和内存访问都可能产生额外成本。本课通过一套可重复的性能测试,拆开这些开销,判断瓶颈究竟来自骨骼数量、动画层数,还是实际参与蒙皮的顶点。
学习目标
- 区分动画采样、骨骼更新、层混合与蒙皮的运行时成本。
- 使用可重复的测试数据分析骨骼数量与动画层数的影响。
- 建立角色动画性能检查项,避免只凭骨骼总数判断性能。
一帧角色动画究竟做了哪些计算
一个采用骨骼蒙皮的角色,通常需要先取得动画姿态,再通过骨骼层级计算最终变换,最后把变换应用到网格顶点。存在多个动画层、IK 或约束时,中间还会增加姿态处理步骤。
典型执行关系如下图。实际引擎可能使用并行任务、缓存、GPU 蒙皮或不同的更新顺序,但分析成本时仍可按计算职责拆分。
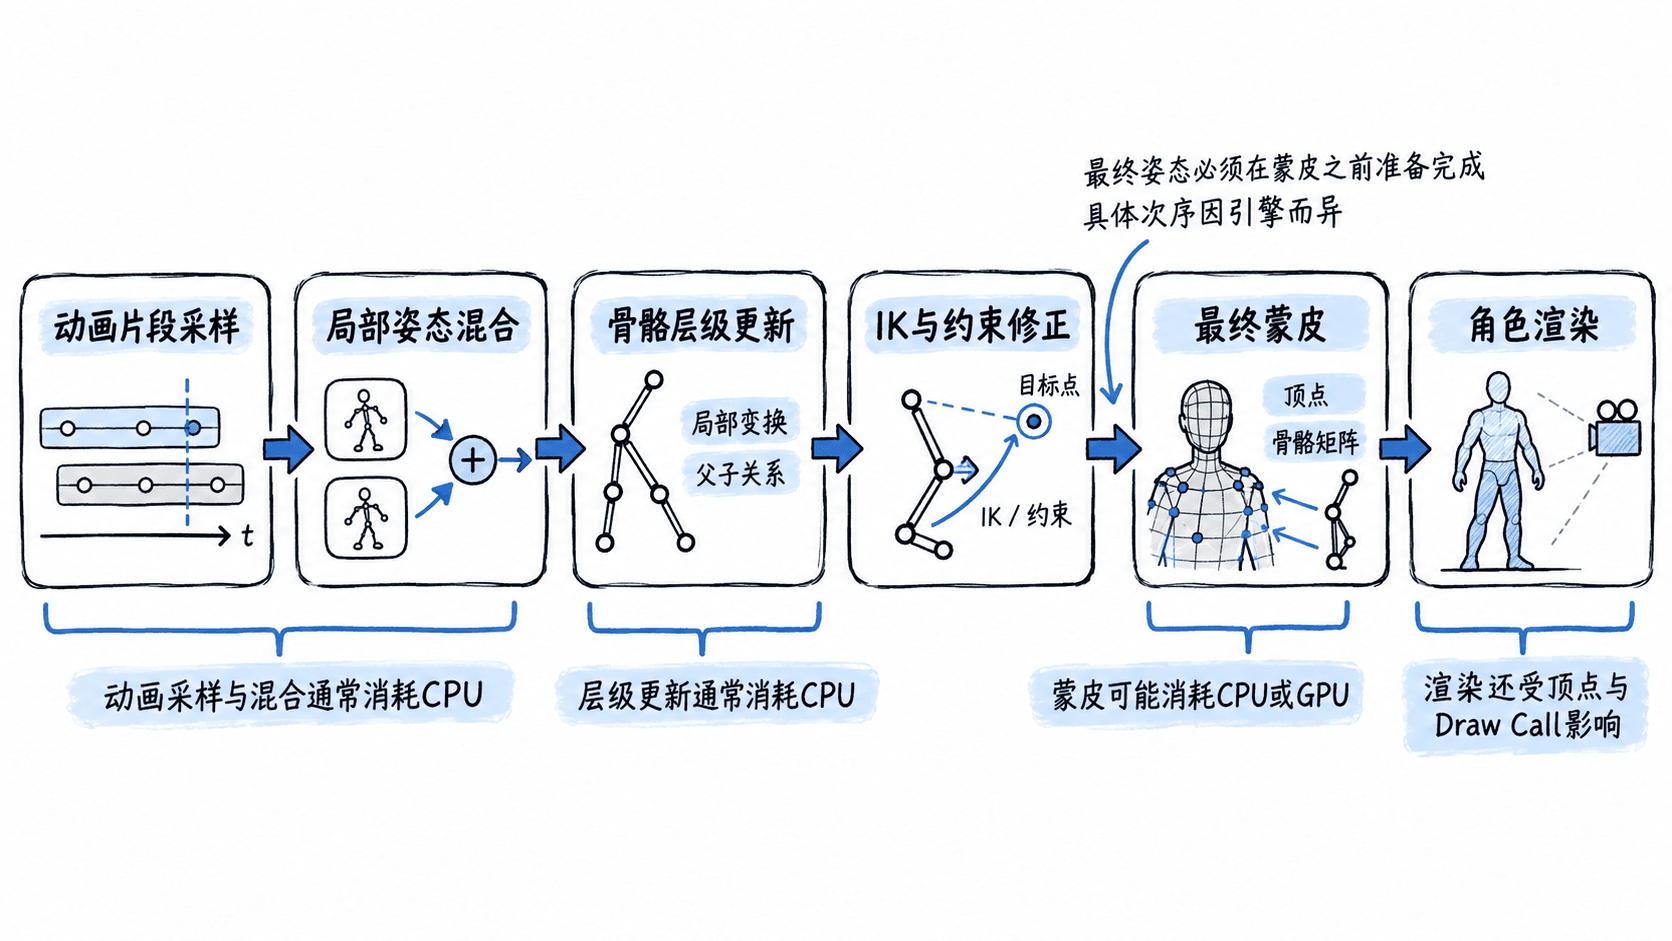
主要成本可以分成四类:
| 计算环节 | 主要影响因素 | 常见表现 |
|---|---|---|
| 动画采样 | 活跃动画片段、动画轨道、采样方式 | 活跃片段越多,采样工作通常越多 |
| 姿态混合 | 参与混合的骨骼、层数、混合方式 | 多层全身混合增加姿态计算 |
| 骨骼更新 | 活跃骨骼数量、层级依赖、约束 | 世界或模型空间变换计算增加 |
| 蒙皮变形 | 顶点数、每顶点有效骨骼影响数、执行方式 | CPU或GPU蒙皮成本上升 |
需要特别区分:骨骼数量并不等于蒙皮计算量。一个有大量辅助骨骼但网格很简单的角色,与骨骼较少、网格密集且每个顶点受多根骨骼影响的角色,性能瓶颈可能完全不同。
骨骼数量为什么会放大成本
骨骼通常组织成父子层级。子骨骼的最终变换需要依赖父骨骼,因此不能随意忽略层级顺序。以矩阵形式表示,常见的模型空间骨骼变换关系为:
根骨骼则以自身局部变换作为模型空间变换。这个公式描述的是典型层级更新关系,不包括某些引擎额外引入的坐标空间转换。
当活跃骨骼数量为 时,单次完整层级遍历通常具有 的计算规模。若每层都对全部骨骼做混合,且活跃动画层数为 ,混合工作量通常近似为 ,但具体实现还会受到轨道稀疏性、遮罩和缓存策略影响。
蒙皮时,顶点通常使用若干个骨骼变换的加权结果:
其中 是该顶点参与计算的骨骼影响数, 是绑定姿态的逆变换, 是当前对应空间的骨骼变换。表达式省略了法线处理及具体引擎的空间转换。
如果顶点数量为 、每顶点平均有效影响数为 ,蒙皮计算规模通常近似为 。GPU 蒙皮还需要关注骨骼矩阵传输、带宽与着色器实现。
因此,减少十根骨骼是否有效,要看它们是否参与活跃姿态求值、约束计算和实际蒙皮,不能简单地按骨骼数量比例预测帧率变化。
用可重复测试拆分性能成本
测试时固定角色网格、动画片段长度、相机距离、角色数量和运行设备,每次只修改一个变量。至少分别比较骨骼数量、动画层数和蒙皮影响数。
建议记录引擎性能分析器中的动画采样、姿态混合、层级更新、IK 和蒙皮阶段耗时。如果引擎把多个阶段合并显示,还应结合独立开关、CPU采样或GPU时间线判断,不能直接把整帧耗时都算给骨骼。
下面的 Python 示例用于分析已经采集好的测试数据。它不是游戏引擎性能测试器,而是帮助识别不同测试场景的耗时变化。
保存为 analyze_animation_cost.py:
from statistics import mean

# 每组数据假设由相同设备、相同场景下的多次稳定采样得到。
samples = {
    "baseline": [0.80, 0.82, 0.78],
    "more_bones": [1.05, 1.08, 1.02],
    "more_layers": [1.30, 1.28, 1.32],
    "more_influences": [1.12, 1.10, 1.14],
}

baseline = mean(samples["baseline"])

for name, values in samples.items():
    average = mean(values)
    delta = average - baseline
    print(f"{name}: {average:.2f} ms, delta={delta:+.2f} ms")
预期输出:
baseline: 0.80 ms, delta=+0.00 ms
more_bones: 1.05 ms, delta=+0.25 ms
more_layers: 1.30 ms, delta=+0.50 ms
more_influences: 1.12 ms, delta=+0.32 ms
这些数值仅用于演示计算方法,不代表任何引擎或硬件的真实基准。这里的 ms 假设对应同一个明确的被测指标;如果混合了CPU动画耗时和GPU蒙皮耗时,就不能直接比较差值。
该示例显示增加动画层的测试组变化最大,但只能说明这一组实验的差异,不能据此断言动画层永远比骨骼数量昂贵。应继续检查混合权重、遮罩覆盖范围及采样任务是否发生变化。
根据瓶颈选择优化方法
骨骼相关优化应建立在测量结果上,而不是首先删除骨骼。
如果动画采样耗时高,可以减少同时激活的动画片段,检查不可见角色是否仍在完整采样,并确认是否支持降低远距离角色的动画更新频率。
如果姿态混合耗时高,优先检查是否存在权重为零却仍参与计算的层、重复的全身混合,以及本应限制在上半身却覆盖整个骨架的遮罩。
如果层级更新耗时高,考虑减少不必要的辅助骨骼与实时约束,对远距离角色采用简化骨架。不过,删除骨骼可能影响动画重定向、挂点、IK 与已有蒙皮权重,需要重新验证功能。
如果蒙皮阶段昂贵,则重点检查网格顶点数、有效骨骼影响数、CPU或GPU蒙皮模式,以及角色实例数量。部分引擎支持对低细节模型减少骨骼影响,但具体限制必须以引擎和目标平台为准。
建立角色动画性能检查项
可以把一次性能检查分成以下几步:
- 固定硬件、画质、角色数量与镜头,先完成稳定预热。
- 分别记录CPU动画任务、GPU蒙皮及整帧耗时,避免混用统计口径。
- 单独增减活跃骨骼、混合层、IK约束或顶点影响数。
- 观察平均耗时、峰值及运行波动,确认是否稳定复现。
- 优化后回归检查动作外观、事件触发、武器挂点和状态切换。
对拥有多个角色的场景,还要分别测量单角色与大量实例的成本。单个角色增加少量计算可能不明显,但同时更新上百个角色时,总动画任务与内存访问成本可能成为瓶颈。
最终应形成一张包含设备、角色数量、动画层数、骨骼数量、顶点影响数及各阶段耗时的基准记录。性能优化的目标不是追求最少骨骼,而是在画面质量和动作表现满足要求的前提下,降低被实际测量证实的关键开销。