
图形渲染与 Shader / 系统课时
GPU 时间超预算怎么砍
GPU 时间超预算怎么砍
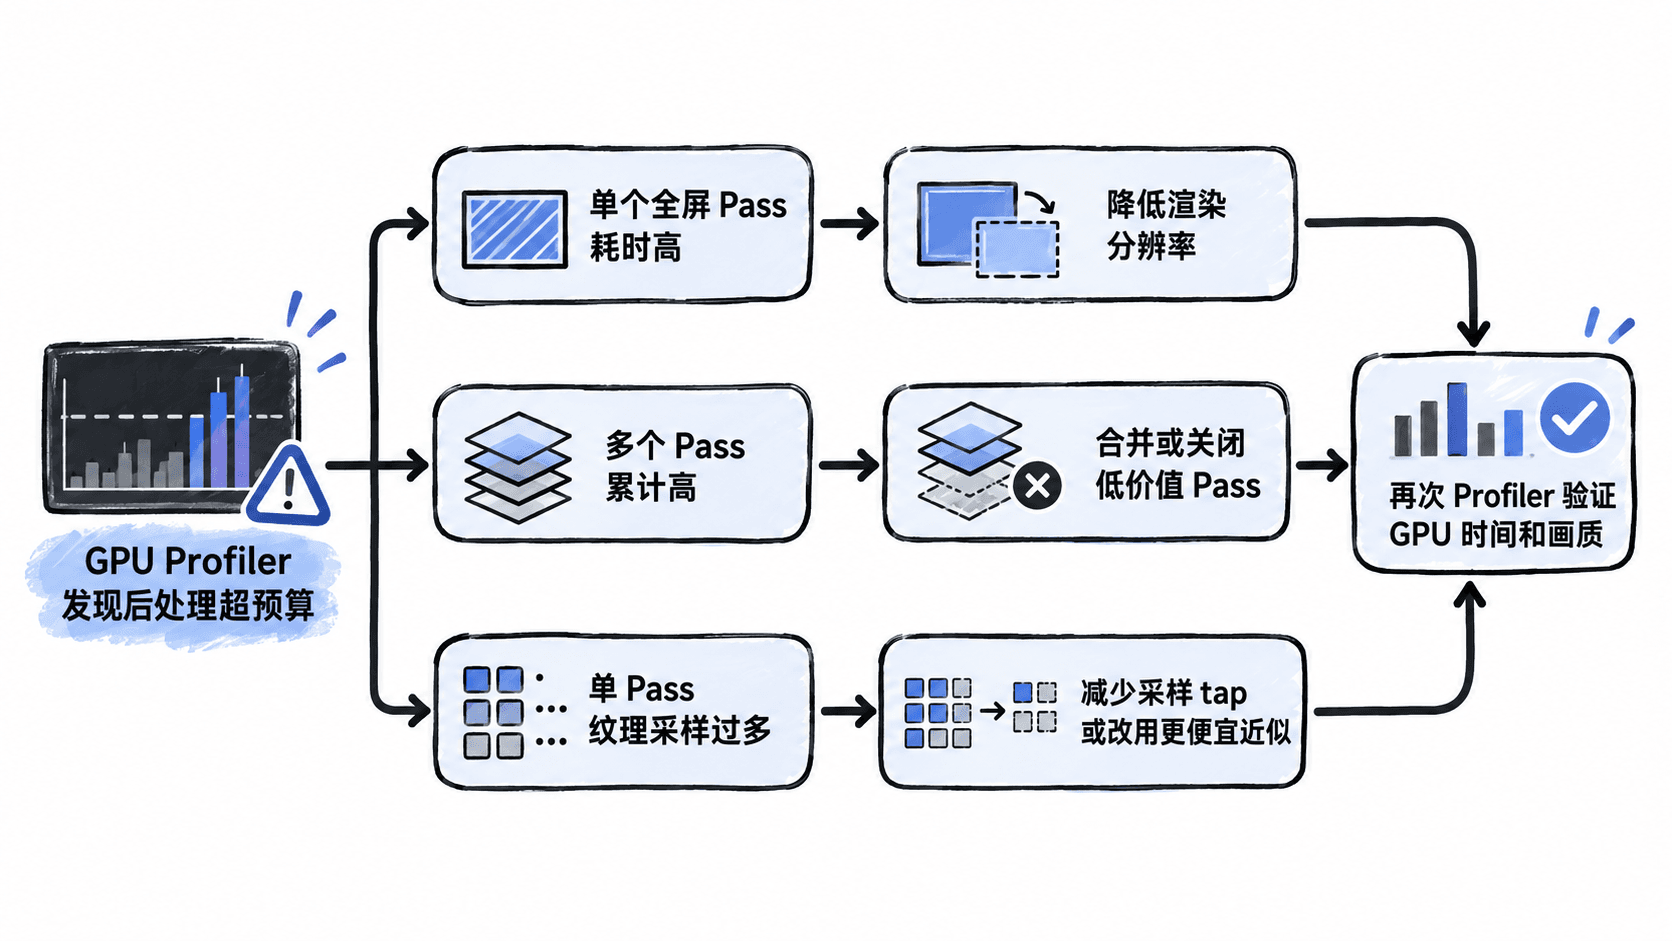
后处理超出 GPU 预算时,最忌讳凭感觉关闭效果。本篇给出一条可复用的削减顺序:先用 GPU Profiler 找到真正昂贵的 Pass,再从分辨率、Pass 数量和纹理采样三个维度逐级降本,并用画面与帧时间共同验收。
学习目标
- 能根据 GPU Profiler 判断后处理瓶颈落在哪个 Pass
- 能按分辨率、Pass 数量、采样次数的优先级制定削减方案
- 能在性能收益与画质损失之间做可验证的取舍
先确认钱花在哪个 Pass
先记录目标设备上的 GPU 帧时间,再展开后处理阶段查看每个 Pass 的耗时。不要只看整条后处理总耗时,因为 Bloom、景深、运动模糊和调色的成本结构不同;同一个效果在不同分辨率、带宽和 GPU 架构上也可能有完全不同的排序。
如果某个全屏 Pass 占据明显大头,先检查它的渲染目标尺寸、读写纹理数量和每像素采样次数。若多个 Pass 单项都不高但总和超预算,则更像是 Pass 数量、频繁切换 Render Target 或反复全屏读写造成的累计成本。
第一刀通常砍分辨率
很多后处理是全屏算法,像素数直接决定工作量。把某个效果从全分辨率改为半分辨率,宽高各减半,像素数量会降到原来的四分之一,因此 Bloom 模糊、景深散景等本身就允许一定柔化的效果经常优先受益。
降分辨率的代价是边缘变软、细节丢失和上采样伪影,所以不要把所有 Pass 一起降。优先处理本来就带模糊属性的效果;锐化、UI 合成、最终色调映射这类对像素精度敏感的阶段通常要更谨慎。
第二刀砍 Pass 和重复读写
后处理链越长,越容易产生重复的全屏读写。两个都只是做简单颜色变换的 Pass,如果业务和着色器结构允许,可以合并到一次采样和一次输出中;不影响玩法反馈的弱特效,则可以直接按质量档位关闭。
合并前要确认依赖关系。例如 Bloom 需要读取高亮结果,Tonemapping 又依赖 HDR 输入,两者不能因为“都是全屏”就机械拼在一起。只有输入域兼容、顺序调整不会破坏中间结果时,合并才安全。
第三刀砍采样数量
当 Profiler 指向某个模糊或卷积 Pass 时,采样次数通常是最直接的成本来源。下面是一个 HLSL 片段示例,依赖引擎已经提供源纹理、线性采样器和单像素纹理尺寸,用 4 个邻域采样演示如何替代更高 tap 数的模糊核。
Texture2D SourceTex;
SamplerState LinearSampler;

float4 Blur4Tap(float2 uv, float2 texelSize)
{
    float2 offset = texelSize * 1.5;

    // 用四个对角采样覆盖邻域,降低纹理读取次数。
    float4 c0 = SourceTex.Sample(LinearSampler, uv + float2(-offset.x, -offset.y));
    float4 c1 = SourceTex.Sample(LinearSampler, uv + float2( offset.x, -offset.y));
    float4 c2 = SourceTex.Sample(LinearSampler, uv + float2(-offset.x,  offset.y));
    float4 c3 = SourceTex.Sample(LinearSampler, uv + float2( offset.x,  offset.y));

    return (c0 + c1 + c2 + c3) * 0.25;
}
预期结果:在相同渲染目标上,相比 9-tap 或更高采样数的模糊实现,每像素纹理读取会减少;GPU 时间通常随之下降,但模糊核形状和细节质量也会改变,具体收益必须以目标设备 Profiler 为准。
采样优化不只等于“少取几次”。还可以利用双线性过滤一次混合邻近 texel、把可分离二维卷积拆成水平和垂直两遍,或者在低分辨率缓冲上工作。选择哪种方式,取决于瓶颈究竟是算力、带宽还是 Pass 数量。
用固定预算做验收
优化前后必须在同一场景、同一分辨率、同一画质档位和相近镜头条件下对比。先看 GPU 总帧时间是否回到预算,再看最贵 Pass 是否真的下降;最后检查闪烁、边缘、光晕范围和运动状态下的稳定性,避免只在静止截图里判断。
可以把削减顺序固定成:先定位最贵 Pass,再尝试降低分辨率,其次减少或合并 Pass,最后压缩采样和算法复杂度。每做一次修改就重新测量,这样才能知道省下来的 GPU 时间究竟来自哪一刀,而不是把画质一起砍掉却仍不知道瓶颈在哪。