
架构与系统设计 / 系统课时
从遗留代码绘制变化热点
从遗留代码绘制变化热点
面对遗留代码,最危险的做法是凭“看起来很乱”决定重构范围。本课把修改历史、条件分支、依赖扩散和职责混杂转成可观察证据,最终得到一张变化热点图,用它判断哪里最值得优先投入重构成本。
学习目标
- 从提交历史和代码结构中识别高频变化区域
- 判断一次修改会沿哪些依赖关系扩散
- 用变化频率、扩散范围和业务风险确定重构优先级
先找经常变而且容易扩散的地方
变化热点不是“代码最丑的类”,而是经常被修改,并且每次修改容易牵连其他模块的区域。一个多年未修改的旧类即使结构不漂亮,也未必值得立即重构;相反,一个每周都因新需求增加分支、同时被多个模块直接依赖的服务,通常更需要处理。
可以先用三个维度判断热点强度:
| 维度 | 观察什么 | 风险信号 |
|---|---|---|
| 变化频率 | 文件或模块多久修改一次 | 同一文件反复出现在需求提交中 |
| 修改扩散 | 一次需求要改多少位置 | 一个业务变化需要同步修改多个类 |
| 失败影响 | 修改错误会影响什么 | 核心交易、数据一致性或公共能力受影响 |
不要急着给三个维度计算精确分数。它们首先是一套筛选语言,用来把“这里感觉难维护”变成可以复核的判断。
用修改历史找到第一批候选
版本历史能回答一个很直接的问题:哪些文件一直在变。下面的命令统计 Git 历史中出现频率较高的文件,适合在 Unix 类环境中快速获得第一批候选。
git log --format= --name-only | sed '/^$/d' | sort | uniq -c | sort -nr | head -10预期输出
<COUNT> src/main/java/.../OrderService.java
<COUNT> src/main/java/.../PaymentService.java
<COUNT> src/main/java/.../NotificationService.java
<COUNT> 和文件路径由实际仓库决定。这个结果只能说明“经常被改”,不能单独证明设计存在问题,还需要继续观察为什么每次都要改它。
接着查看高频文件内部是否反复出现按类型、渠道或状态扩张的条件分支。例如下面的片段中,每增加一种支付渠道都需要修改同一个方法。
// 片段示例:依赖已有的 alipay、wechatPay 和 bankCard 客户端对象
public PaymentResult pay(String channel, Order order) {
    if ("ALIPAY".equals(channel)) {
        return alipay.pay(order);
    } else if ("WECHAT".equals(channel)) {
        return wechatPay.pay(order);
    } else if ("BANK_CARD".equals(channel)) {
        return bankCard.pay(order);
    }
    throw new IllegalArgumentException("unsupported channel");
}
这段代码本身并不能直接推出“必须使用策略模式”。真正值得记录的证据是:渠道列表是否持续扩张、这个判断是否散落在多处,以及每次新增渠道是否还要同步修改订单、退款或通知逻辑。
沿依赖方向检查修改扩散
高频修改文件只是热点中心候选,还要沿依赖方向观察变化会不会传播。尤其关注三类关系:上层业务是否直接依赖多个具体实现、同一个类是否同时承担判断与执行职责、下游接口变化是否迫使大量调用方一起修改。
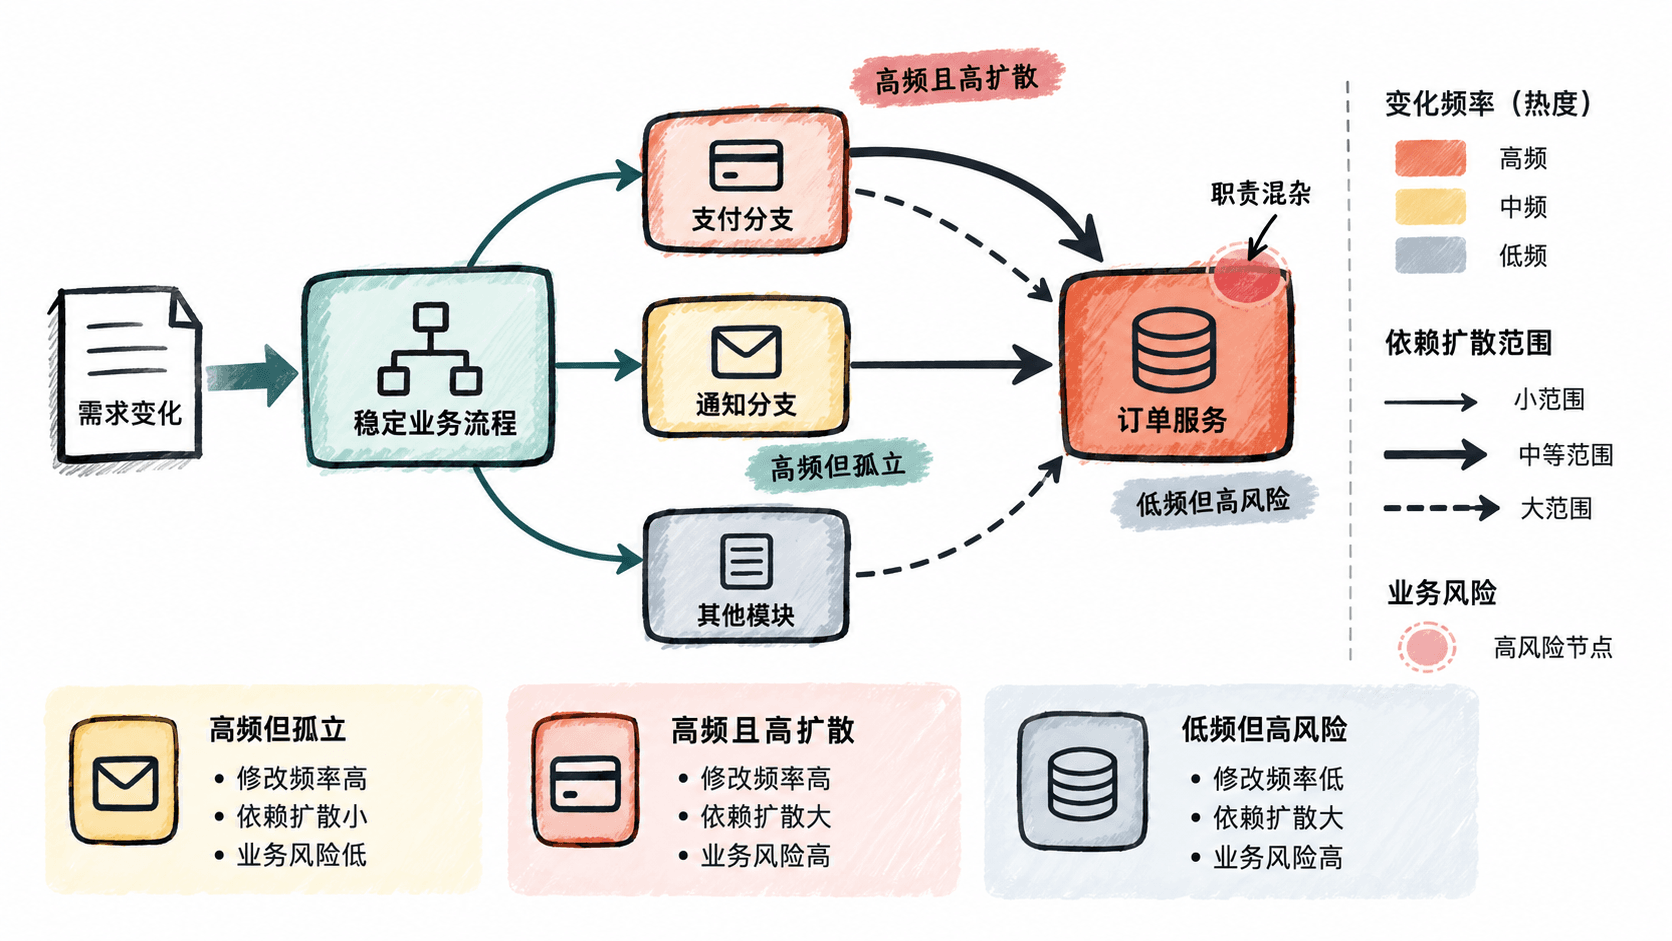
画图时不必追求完整类图。只保留与变化有关的节点和箭头:需求从哪里进入、哪些模块需要一起修改、哪些依赖跨越了原本的职责边界。热点图的目标是帮助评审修改路径,而不是复刻整个系统结构。
把职责混杂作为放大信号
一个类同时负责业务判断、对象创建、外部调用、重试、日志和通知时,需求变化很容易落到同一个位置。此时真正的问题不只是“类太长”,而是不同变化原因被绑定在一起。
评审时可以追问:支付渠道增加为什么要改订单流程?通知模板变化为什么会进入支付类?更换第三方 SDK 为什么会影响业务规则?如果这些问题频繁出现,说明变化边界与职责边界没有对齐。
按收益安排重构顺序
完成热点图后,可以把候选区域按“变化频率”和“修改影响”组合判断。高频且高扩散的区域通常优先;低频但涉及资金、权限或核心数据的区域需要单独评估风险;高频但完全局部化的代码,则可能只需要小规模整理。
重构目标也应针对热点来源,而不是提前指定模式名称。条件分支持续扩张时,目标可能是隔离变化策略;对象创建牵连业务流程时,目标可能是收敛创建责任;外部 SDK 变化不断传入核心代码时,目标则可能是建立稳定边界。
一张有效的热点图最终应该能回答两个问题:下一次同类需求最可能改哪里,以及怎样缩小它的修改范围。能回答这两个问题,后续的模式评审才有可靠输入。