
架构与系统设计 / 系统课时
解释器处理小型规则表达式
解释器处理小型规则表达式
当业务出现“地区等于 MY 且金额大于 100”这类可配置条件时,可以把规则拆成表达式对象,再由统一上下文完成求值。本篇用一个最小可运行示例展示解释器模式的结构、解析过程,以及规则复杂后为什么应及时换成成熟解析器。
学习目标
- 理解终结符表达式、组合表达式与上下文各自负责什么
- 能把一条简单规则映射为对象树并执行求值
- 能判断解释器模式何时仍合适、何时应换用解析工具
把规则拆成可组合对象
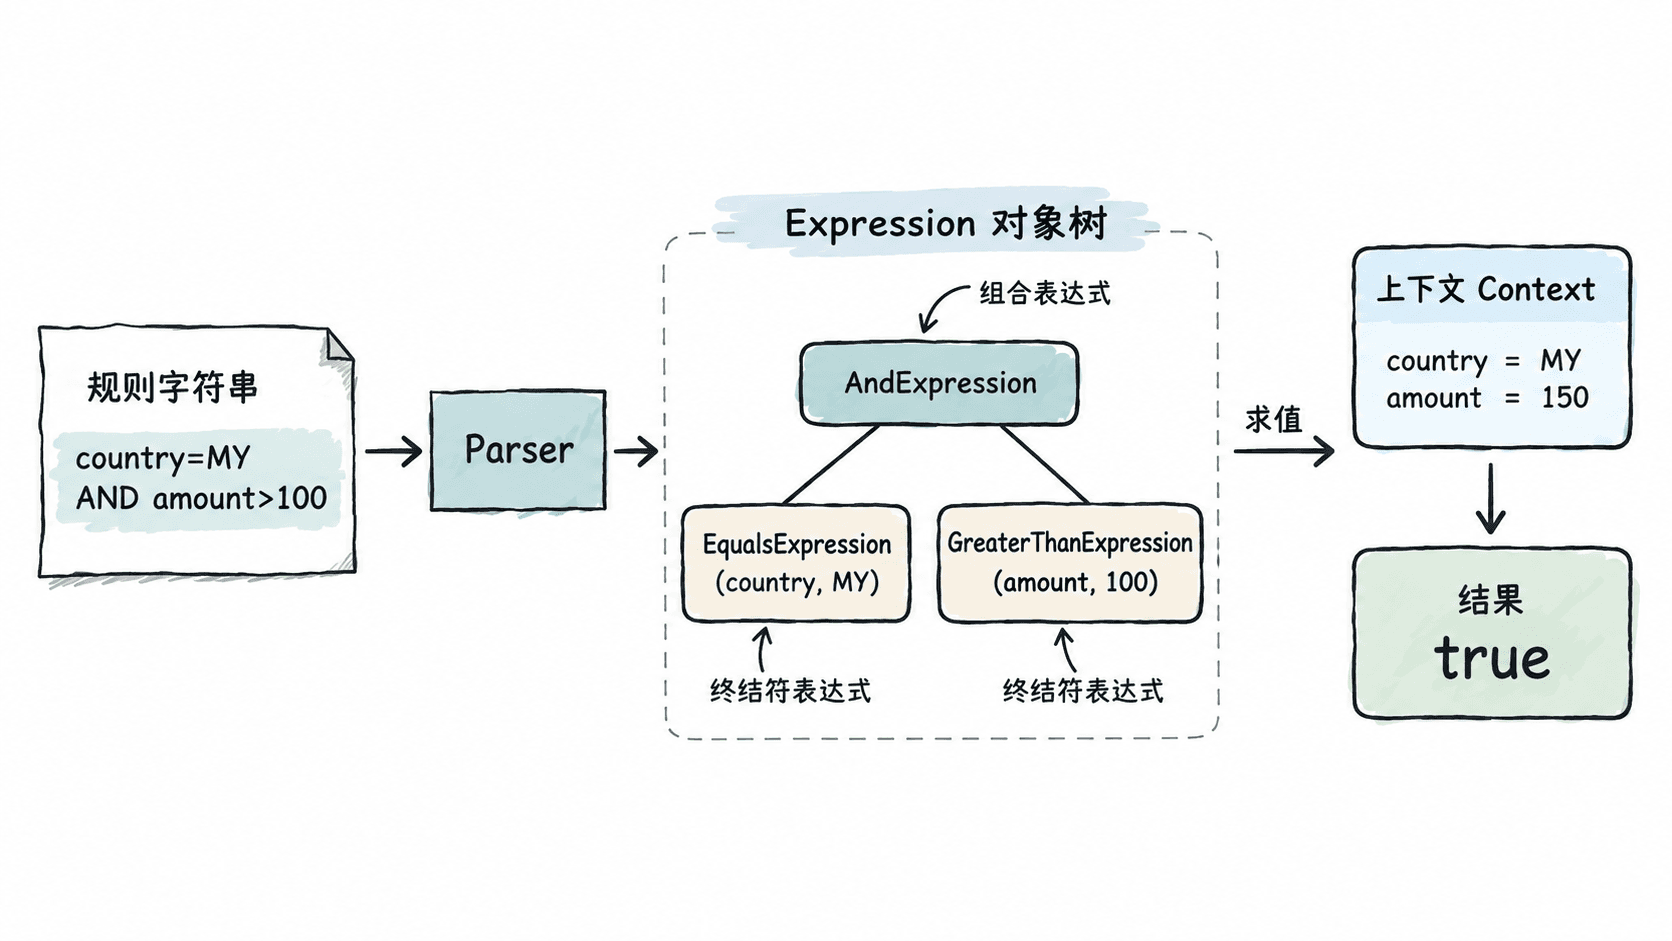
解释器模式适合“小语法、小规模、可组合”的规则。关键不是把字符串塞进大量 if,而是先把每种语义映射为实现同一接口的对象:比较节点负责具体判断,组合节点负责连接子表达式,上下文只提供求值所需的数据。
例如规则 country=MY AND amount>100 可以拆成一个 AND 节点,它有两个子节点:country=MY 与 amount>100。这样新增另一种比较操作时,通常只需要增加新的表达式类,而不是改动整条执行流程。
用最小解释器执行规则
下面的 Java 示例只支持 =、> 和一个 AND,目的是把解释器模式的职责边界讲清楚,而不是实现完整表达式语言。
import java.util.HashMap;
import java.util.Map;

public class MiniRuleInterpreter {
    interface Expression {
        boolean interpret(Map<String, String> context);
    }

    static class EqualsExpression implements Expression {
        private final String key;
        private final String expected;

        EqualsExpression(String key, String expected) {
            this.key = key;
            this.expected = expected;
        }

        public boolean interpret(Map<String, String> context) {
            return expected.equals(context.get(key));
        }
    }

    static class GreaterThanExpression implements Expression {
        private final String key;
        private final double threshold;

        GreaterThanExpression(String key, double threshold) {
            this.key = key;
            this.threshold = threshold;
        }

        public boolean interpret(Map<String, String> context) {
            String value = context.get(key);
            return value != null && Double.parseDouble(value) > threshold;
        }
    }

    static class AndExpression implements Expression {
        private final Expression left;
        private final Expression right;

        AndExpression(Expression left, Expression right) {
            this.left = left;
            this.right = right;
        }

        public boolean interpret(Map<String, String> context) {
            return left.interpret(context) && right.interpret(context);
        }
    }

    static Expression parse(String rule) {
        String[] parts = rule.split(" AND ");
        if (parts.length != 2) {
            throw new IllegalArgumentException("只支持一个 AND");
        }
        return new AndExpression(parseTerminal(parts[0]), parseTerminal(parts[1]));
    }

    static Expression parseTerminal(String text) {
        if (text.contains("=")) {
            String[] parts = text.split("=", 2);
            return new EqualsExpression(parts[0], parts[1]);
        }
        if (text.contains(">")) {
            String[] parts = text.split(">", 2);
            return new GreaterThanExpression(parts[0], Double.parseDouble(parts[1]));
        }
        throw new IllegalArgumentException("不支持的表达式: " + text);
    }

    public static void main(String[] args) {
        Expression rule = parse("country=MY AND amount>100");

        Map<String, String> accepted = new HashMap<>();
        accepted.put("country", "MY");
        accepted.put("amount", "180");

        Map<String, String> rejected = new HashMap<>();
        rejected.put("country", "MY");
        rejected.put("amount", "80");

        System.out.println(rule.interpret(accepted));
        System.out.println(rule.interpret(rejected));
    }
}
预期输出
true
false这个示例里,parse 负责把文本转换成对象结构,interpret 只负责求值。把解析与执行分开后,测试也更容易:既可以测试字符串能否生成正确结构,也可以直接构造表达式对象测试业务判断。
控制语法边界
解释器模式的成本会随语法能力快速增加。只要开始出现括号、AND 与 OR 优先级、字符串转义、函数调用、错误位置提示,就不再只是“多写几个表达式类”,而是进入词法分析、语法分析和抽象语法树设计问题。
什么时候值得使用
解释器模式适合规则数量有限、语法稳定、业务方确实需要组合条件的场景,例如权限条件、促销门槛或简单过滤器。它的价值在于让语义节点可独立扩展和测试,而不是为了“看起来像 DSL”。
当需求只是两三个固定条件,普通策略对象或显式条件判断更直接;当语法已经成长为真正语言,则应把解析交给专业工具。判断标准不是类的数量,而是语法复杂度是否已经超过团队愿意自行维护的边界。