
架构与系统设计 / 系统课时
享元模式复用大批共享状态
享元模式复用大批共享状态
当系统要创建海量细粒度对象时,真正昂贵的往往不是对象数量本身,而是这些对象反复携带相同数据。本节用树木渲染示例拆分内部状态与外部状态,并判断什么时候共享值得引入额外复杂度。
学习目标
- 区分享元对象中的内部状态与由调用方提供的外部状态
- 使用工厂缓存可共享对象,验证多个实例确实复用了同一份状态
- 结合对象数量、重复率和状态可变性判断享元模式是否值得采用
先找出真正重复的数据
假设地图上有几十万棵树。每棵树的位置不同,但同一树种的名称、颜色、纹理配置却高度重复。如果把全部信息都放进每个树对象,重复数据会随对象数量线性增长。
享元模式把“可共享且稳定”的部分提取为内部状态,由享元对象保存;把“每次使用都可能不同”的部分留在外部,由调用方在调用时提供。内部状态通常应当不可变,否则一个调用方修改共享对象,会影响所有复用它的对象。
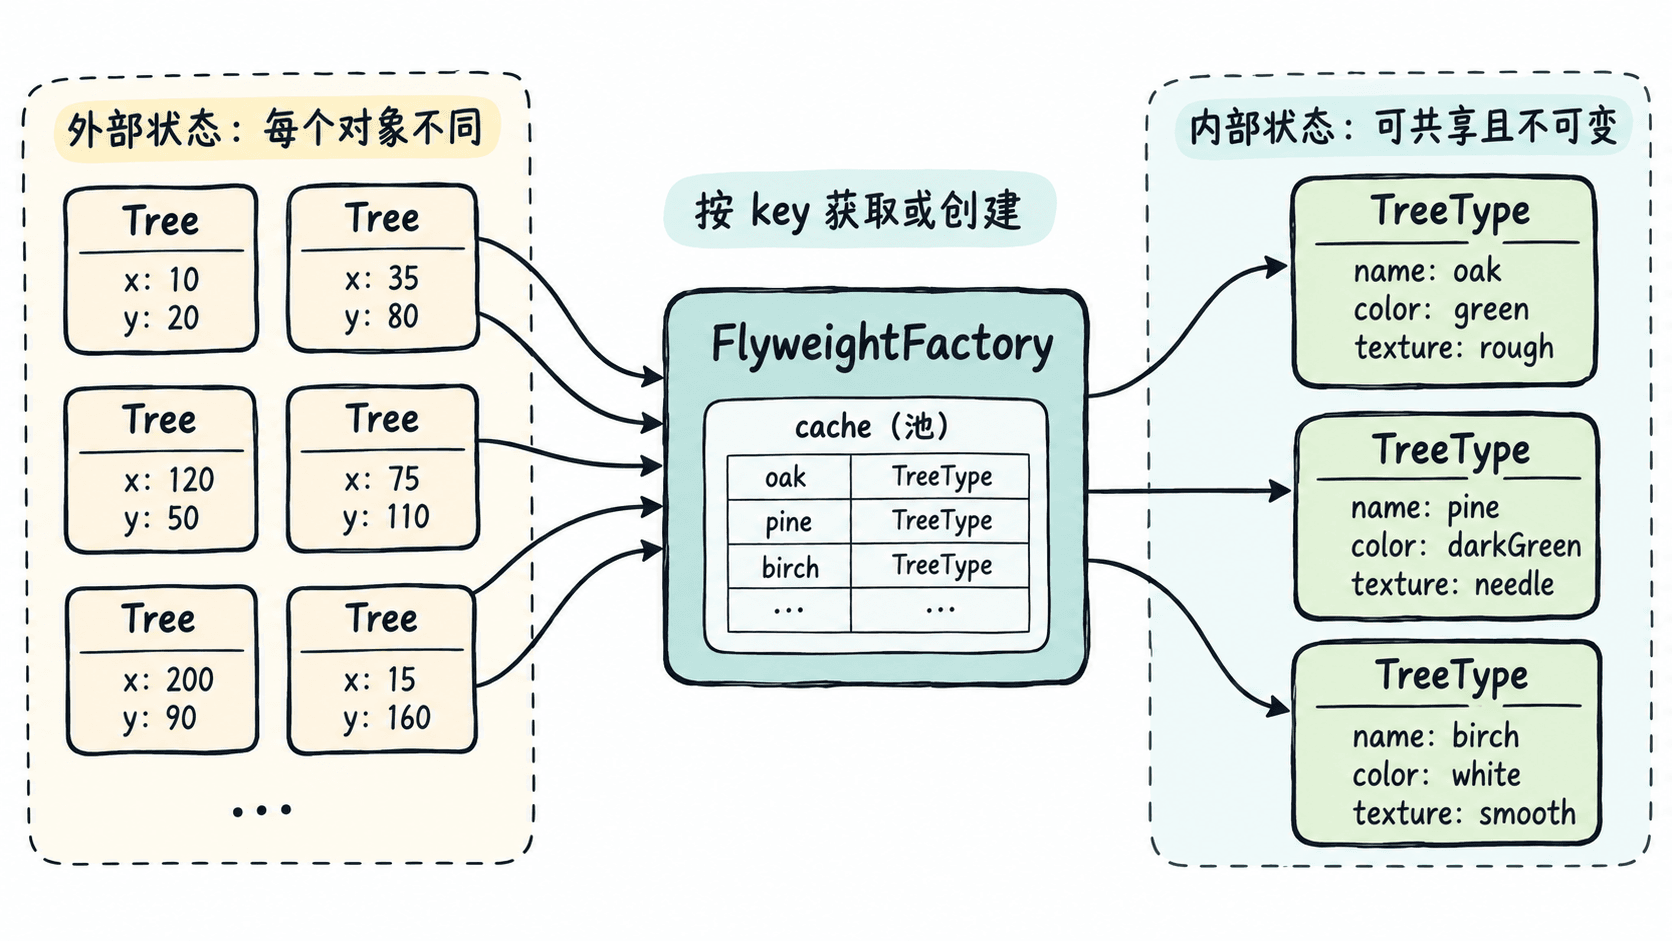
判断边界时可以问两个问题:这个字段是否在大量对象之间重复?它是否能在对象创建后保持稳定?只有同时满足,才适合放进共享享元。
用工厂缓存共享对象
下面把树种信息放进不可变的 TreeType,把坐标留在 Tree 中。工厂按树种名称缓存 TreeType,同一种树不会重复创建共享状态。
import java.util.HashMap;
import java.util.Map;

public class FlyweightDemo {
    record TreeType(String name, String color, String texture) {
    }

    static final class TreeTypeFactory {
        private final Map<String, TreeType> cache = new HashMap<>();

        TreeType get(String name, String color, String texture) {
            return cache.computeIfAbsent(
                name,
                key -> new TreeType(name, color, texture)
            );
        }

        int sharedTypeCount() {
            return cache.size();
        }
    }

    record Tree(int x, int y, TreeType type) {
    }

    public static void main(String[] args) {
        TreeTypeFactory factory = new TreeTypeFactory();

        TreeType oak = factory.get("Oak", "green", "oak.png");
        TreeType pine = factory.get("Pine", "dark-green", "pine.png");

        Tree[] trees = {
            new Tree(10, 20, oak),
            new Tree(30, 40, oak),
            new Tree(50, 60, pine),
            new Tree(70, 80, factory.get("Oak", "green", "oak.png"))
        };

        System.out.println("树实例: " + trees.length);
        System.out.println("共享 TreeType: " + factory.sharedTypeCount());
        System.out.println("Oak 是否复用: " + (oak == trees[3].type()));
    }
}
预期输出
树实例: 4
共享 TreeType: 2
Oak 是否复用: true
示例中的四个 Tree 仍然各自存在,因为坐标不同;被压缩的是重复的 TreeType。这也是享元模式常被误解的地方:它不是“把所有对象都变成单例”,而是只共享对象中稳定且重复的那一部分。
缓存键必须覆盖全部内部状态
享元工厂通过键判断“这是不是同一个共享对象”。如果键只使用 name,却允许同名树种拥有不同颜色或纹理,那么工厂可能错误地复用不兼容状态。
示例为了突出机制,假设名称能唯一确定颜色和纹理。真实系统中应当让缓存键覆盖所有决定内部状态的字段,或者使用专门的不可变键对象。只要两个请求在内部状态上存在差异,就不应返回同一个享元实例。
先测量,再决定是否引入享元
享元模式适合“大量对象 × 高重复状态 × 单份状态占用不小”的场景,例如字形元数据、地图图标样式、游戏中的模型与材质描述。若对象只有几百个,或者可共享字段很少,引入缓存工厂、键设计和生命周期管理反而会增加复杂度。
评估时至少比较三项:对象总量、内部状态重复率、共享后真正节省的内存。还要考虑取享元时的哈希查找、缓存常驻和调试成本。现代运行时对小对象的分配已经很快,因此“对象多”本身不足以证明需要享元。
当性能分析确认重复状态占据明显内存,并且这些状态能够安全地保持不可变时,再把它们抽成享元;这样共享是基于测量结果,而不是为了使用模式而使用模式。