
通信工程 / 系统课时
链路故障排查
链路故障排查
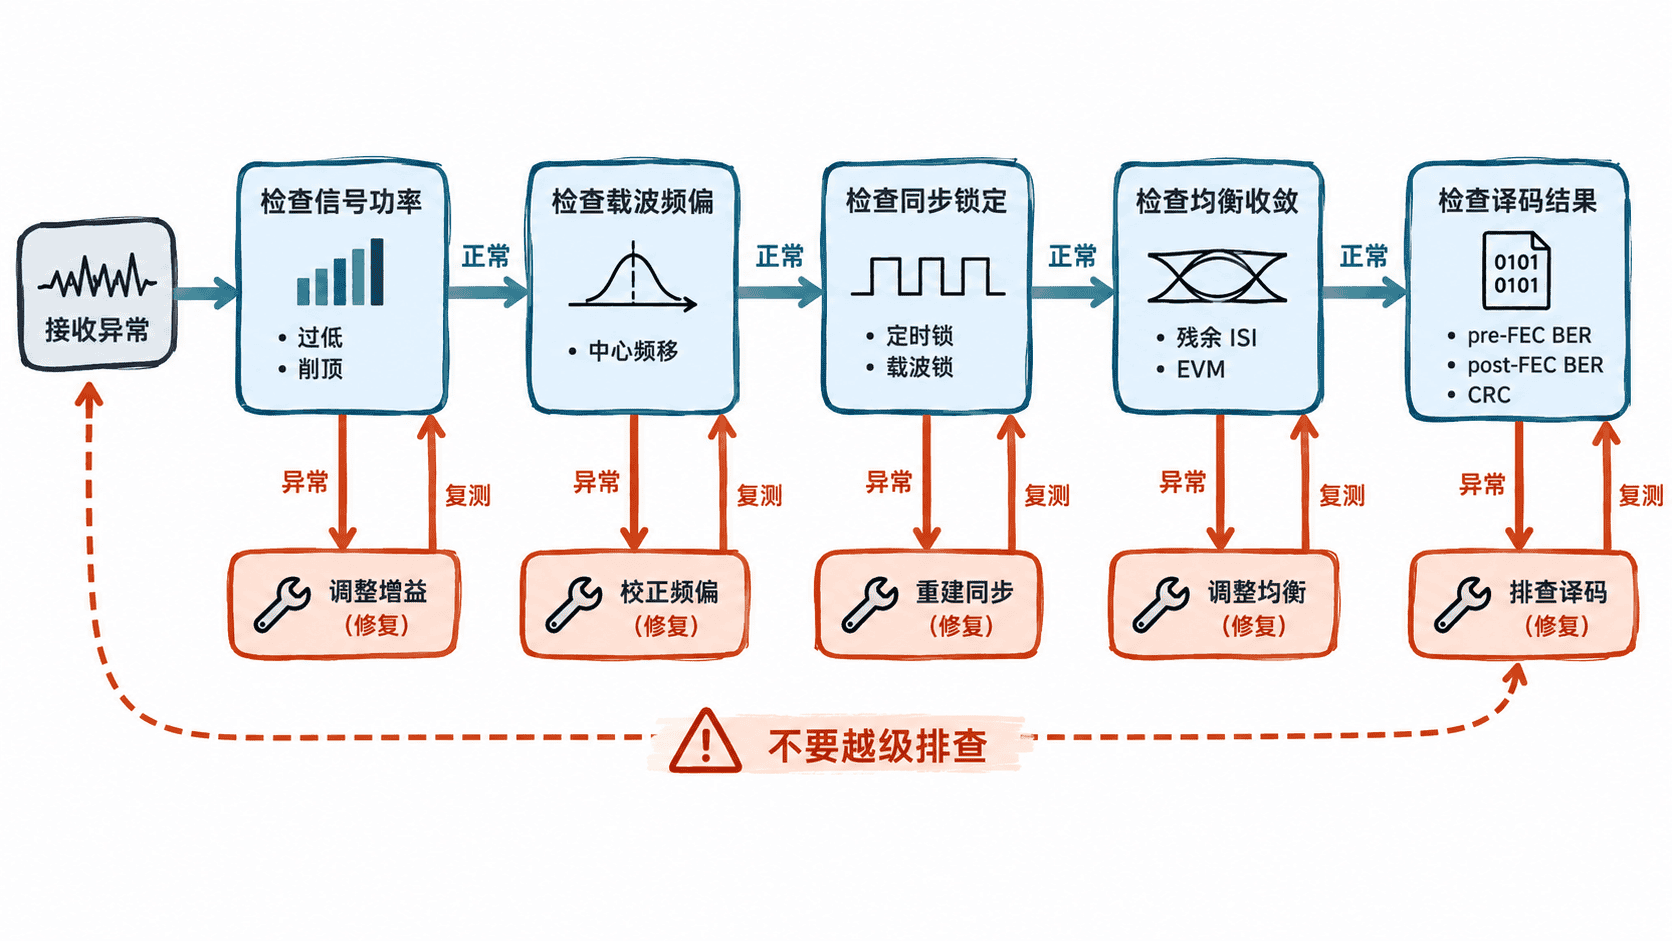
通信链路异常时,最容易浪费时间的做法是直接调均衡器或译码器。本节建立固定排查顺序:先看信号功率,再看频偏、同步、均衡,最后检查译码,让每一步都以前一步“已经正常”为前提。
学习目标
- 按功率、频偏、同步、均衡、译码的顺序定位链路异常
- 根据观测指标判断故障属于前端、同步还是基带处理阶段
- 修改参数后用同一组指标复测,确认问题确实被消除
为什么必须按层排查
接收链路是级联关系。前端功率不对会影响频偏估计和同步;同步未锁定时,均衡器看到的训练目标也可能失真;均衡输出尚未稳定时,译码器得到的软信息再复杂也无法补救。因此排查顺序要从“最靠近信号源头、影响面最大”的环节开始。
先排除功率与频偏
先确认接收功率处在前端和 ADC 的可用范围。功率过低会抬高等效噪声占比,功率过高则可能造成削顶。除了平均功率,还要看削顶比例和 AGC 是否已经顶到上下限;如果这里异常,后续所有基带指标都先暂停解释。
功率正常后检查频偏。常用判断是把频偏除以符号率得到归一化频偏,因为同样的 1 kHz 偏差在不同符号率下影响完全不同。若频谱整体平移、星座持续旋转或载波环长时间无法锁定,先修正本振设置、采样时钟或粗频偏估计。
下面的最小示例把实测指标放进固定顺序,只返回第一个应优先处理的问题。阈值只是仿真实验示例,实际系统应根据调制方式、环路带宽和设备动态范围重新标定。
def first_fault(m):
    if m["rssi_dbfs"] < -70:
        return "优先排查:接收功率过低"
    if m["clipping_ratio"] > 0.001:
        return "优先排查:前端或 ADC 削顶"

    norm_cfo = abs(m["freq_offset_hz"]) / m["symbol_rate"]
    if norm_cfo > 0.01:
        return f"优先排查:频偏过大({norm_cfo:.2%} 符号率)"
    if m["sync_peak_ratio"] < 3.0:
        return "优先排查:定时或帧同步未可靠锁定"
    if m["evm_pct"] > 10.0:
        return "优先排查:均衡后 EVM 过高"
    if m["pre_fec_ber"] > 1e-3 and m["post_fec_ber"] > 1e-6:
        return "优先排查:译码配置或软信息质量"
    return "未发现越过阈值的首要故障"

metrics = {
    "rssi_dbfs": -52.0,
    "clipping_ratio": 0.0,
    "freq_offset_hz": 1800.0,
    "symbol_rate": 100000.0,
    "sync_peak_ratio": 8.5,
    "evm_pct": 7.2,
    "pre_fec_ber": 1.1e-2,
    "post_fec_ber": 0.0,
}

print(first_fault(metrics))
预期输出
优先排查:频偏过大(1.80% 符号率)再检查同步与均衡
频偏进入可跟踪范围后,再观察定时同步、帧同步和载波同步是否稳定锁定。不要只看一个“LOCK”布尔值,还要看相关峰值是否明显、锁定是否反复掉线、残余相位是否随时间漂移。同步不稳时,优先处理训练序列、环路参数、采样率和信噪比,而不是继续向后调译码器。
同步稳定后再看均衡器。重点检查抽头是否收敛、EVM 是否下降、眼图是否打开,以及关闭均衡器后问题是否明显加重。若均衡器发散或 EVM 持续恶化,应核对步长、训练序列、判决导向切换时机和信道时变速度。
最后检查译码与数据链
只有星座已经聚拢、EVM 和 pre-FEC BER 达到设计范围后,才进入译码检查。此时重点比较 pre-FEC BER、post-FEC BER、CRC 通过率和软信息分布。如果 pre-FEC 很差,根因通常仍在前级;如果 pre-FEC 已经很好但 post-FEC 反而异常,就要核对码率、交织方式、比特映射、LLR 符号方向和帧边界。
修复后不要只看“业务恢复”。至少重复记录接收功率、归一化频偏、同步质量、EVM、pre-FEC BER 和 post-FEC BER,并与故障前后对比。只有首个异常点恢复正常,而且后续指标也随之改善,才能说明修复命中了真实根因。
用首个异常点约束后续动作
一条实用规则是:一旦找到第一个明显异常的链路阶段,就先停止向后解释。 功率异常时不要讨论译码,频偏异常时不要调均衡,未同步时不要相信星座形态,均衡未收敛时不要用 post-FEC BER 评价编码性能。
这样的排查顺序把复杂通信链路拆成可验证的门禁:功率决定信号是否可用,频偏决定载波是否能跟踪,同步决定采样与帧边界是否可信,均衡决定残余信道失真是否被压下,译码最后验证比特可靠性。每次只处理最靠前的异常点,定位会更快,也更不容易把多个问题互相混淆。