
通信工程 / 系统课时
非均匀量化与压扩
非均匀量化与压扩
均匀量化对所有幅度使用相同量化间隔,小信号因此更容易被量化误差淹没。本篇从这一问题出发,理解非均匀量化为何有效,并掌握 A 律、μ 律通过“先压缩、后量化、再扩展”改善小信号质量的机制。
学习目标
- 解释均匀量化对小信号不利的原因
- 理解压缩、均匀量化和扩展组成的压扩流程
- 区分 A 律与 μ 律的基本特点和应用思路
为什么小信号更需要细量化
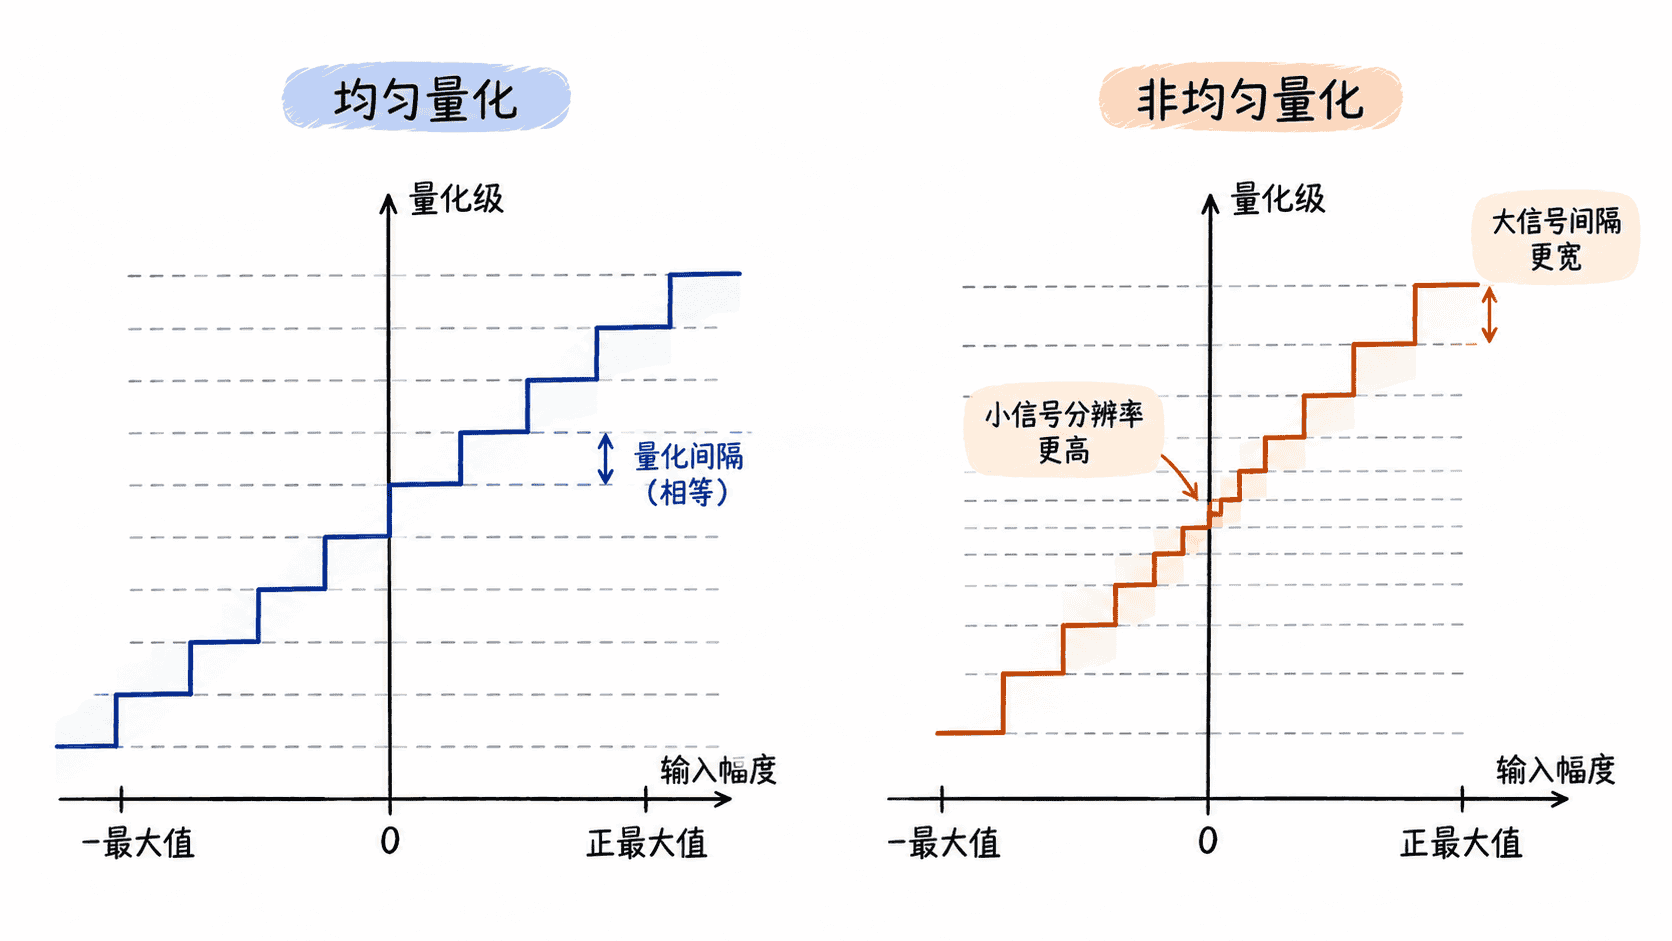
设均匀量化器的量化间隔为 。无论输入幅度大小,相邻量化级之间都相差 。对于幅度很大的信号,这个误差只占信号幅度的一小部分;对于接近零点的小信号,同样大小的误差却可能占据很高比例,因此信号与量化噪声之比明显下降。
非均匀量化的核心就是让靠近零点的量化间隔更密,大幅度区域的量化间隔更疏。这样无需无限增加总量化级数,也能把有限的编码资源优先分配给较弱的信号。
压扩如何实现非均匀量化
工程中通常不直接制造一个间隔不断变化的量化器,而是在发送端先对信号做非线性压缩,再使用普通的均匀量化器。压缩函数会放大小幅度区域的相对变化,同时压缩大幅度区域的变化范围。
接收端完成译码后,再使用与压缩函数互逆的扩展函数恢复幅度关系。完整链路可以概括为:模拟输入 → 压缩 → 均匀量化与编码 → 译码 → 扩展 → 模拟输出。
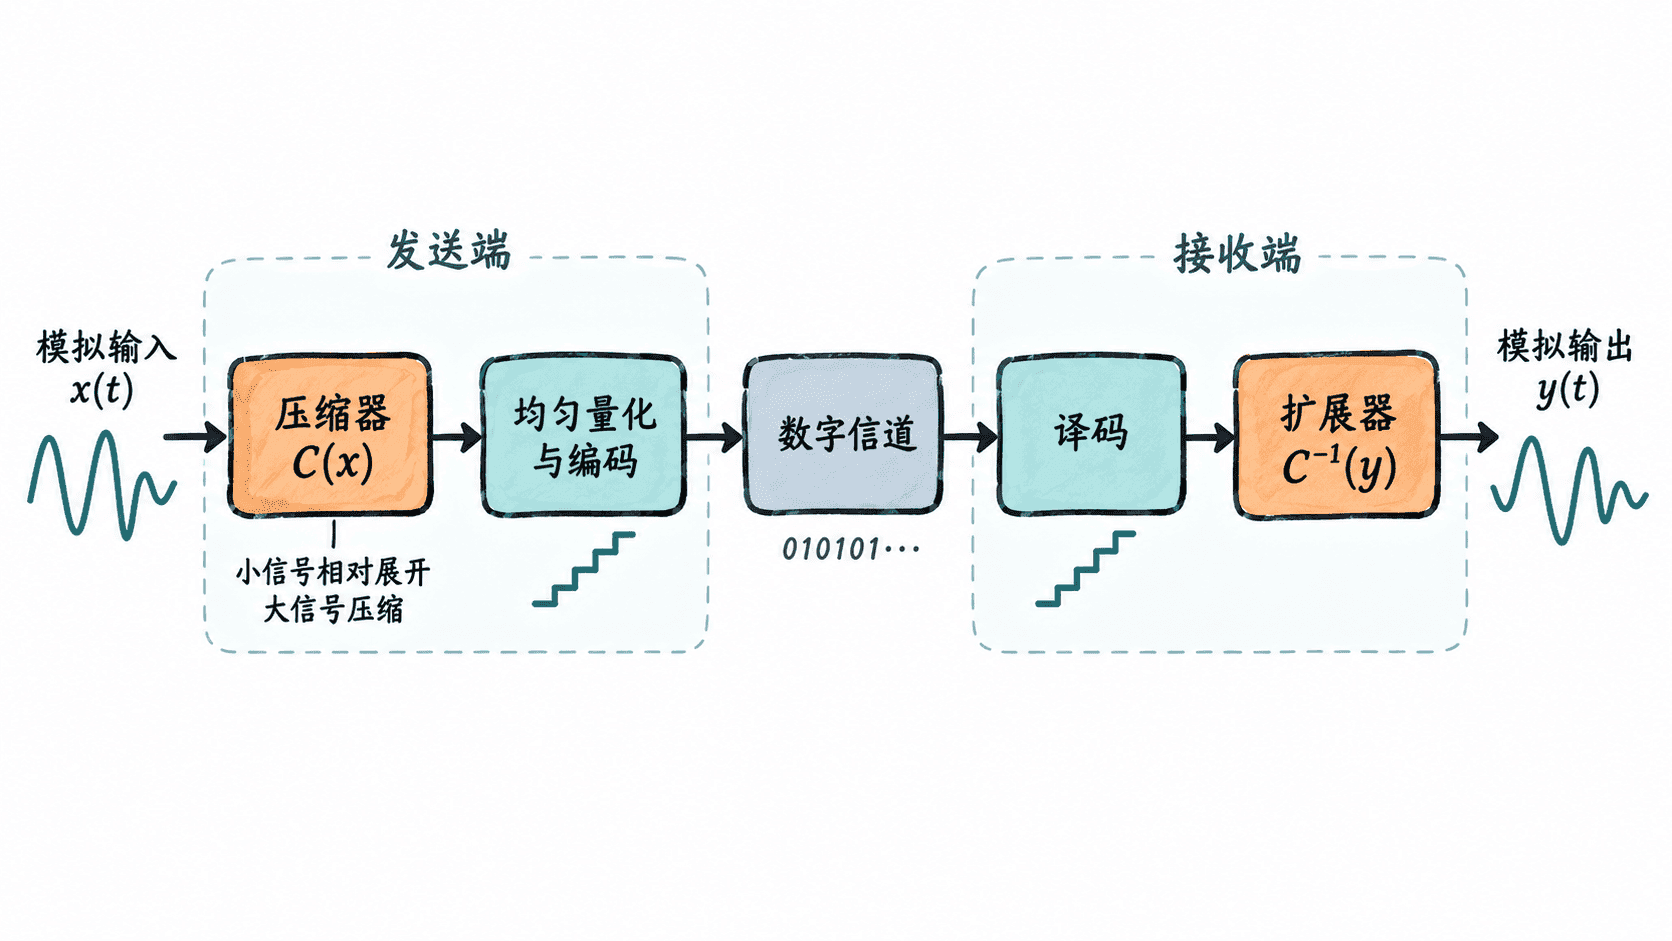
这种方法的关键并不是减少量化误差的绝对上限,而是重新分配误差:小信号获得更细的等效量化间隔,大信号则容忍更粗的间隔,从而使不同幅度下的主观质量和信噪表现更加均衡。
A 律与 μ 律
A 律和 μ 律都是对数型压扩规律。它们在零点附近斜率较大,对小信号具有较强的展开作用;输入幅度增大后,曲线逐渐变平,使大信号占用的动态范围受到压缩。
μ 律常用参数为 。归一化输入满足 时,可用下面的关系理解其压缩特性:
A 律的标准参数通常取 ,其曲线在零点附近采用近似线性段,随后进入对数压缩区域。实际数字电话系统往往使用分段线性电路或查表方式实现,而不是实时计算理想对数函数。
| 对比项 | A 律 | μ 律 |
|---|---|---|
| 典型参数 | ||
| 曲线特点 | 小信号区含近似线性段,随后对数压缩 | 采用连续的对数型压缩规律 |
| 共同目标 | 提高小信号的等效量化精度 | 提高小信号的等效量化精度 |
| 常见标准体系 | 欧洲等地区的数字电话系统 | 北美、日本等地区的数字电话系统 |
怎样判断压扩是否有价值
压扩特别适合动态范围大、又关注弱信号质量的语音通信。判断其作用时,不要只看量化级总数,而要观察压缩后不同输入幅度对应了多少编码区间:零点附近占用更多码字,就意味着小信号获得了更高的幅度分辨率。
非均匀量化的本质可以记成一句话:不是给所有幅度同样的精度,而是把更多精度留给最容易受到量化噪声影响的小信号。