
通信工程 / 系统课时
统计时分复用
统计时分复用
统计时分复用不再为每个终端永久保留固定时隙,而是把链路容量优先分给当前真正有数据的输入。本节从缓冲与调度过程出发,分析这种按需分配为什么能提高突发业务的链路利用率,以及负载升高时为什么会付出排队时延。
学习目标
- 解释统计时分复用按需分配输出时隙的工作过程
- 比较统计时分复用与同步时分复用的容量利用方式
- 判断业务负载、缓冲队列和传输时延之间的关系
从固定时隙改成按需发送
同步时分复用中,每个输入在一帧里都有固定位置,即使没有数据也可能保留空时隙。统计时分复用则先观察哪些输入真正产生了数据,只为活跃输入组织输出单元,因此同一条高速链路可以在不同时间服务不同数量的终端。
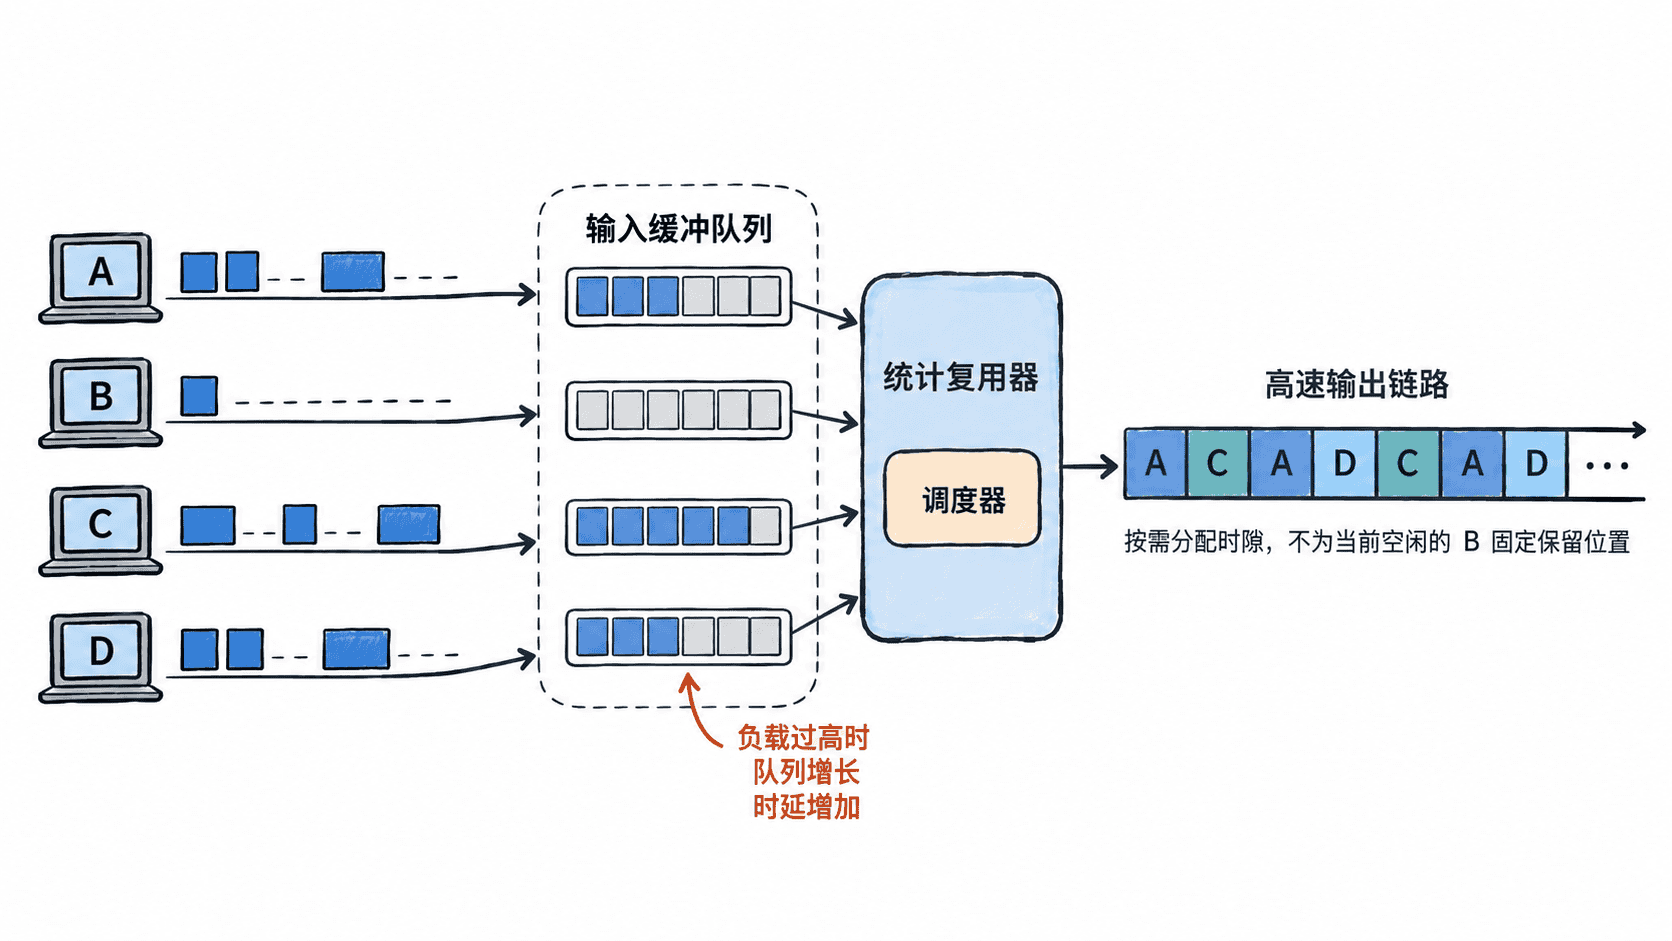
由于输出位置不再与某个输入永久绑定,接收端通常不能只靠“第几个时隙”判断数据属于谁。输出数据单元需要携带地址、逻辑信道号或其他来源标识,使解复用器能够把它送往正确目的端。
利用率为什么会提高
假设有 4 个终端,每个终端的峰值码率都是 64 kbit/s,但平均只有 25% 的时间处于发送状态。同步时分复用如果始终为四路保留峰值容量,仅业务部分就需要:
而四个终端的平均有效输入速率为:
统计时分复用能够利用各终端“并非总是同时忙”的统计特性,使链路容量不必简单等于所有终端峰值码率之和。例如配置 128 kbit/s 的业务传输能力时,在上述平均负载下仍有约一半平均容量余量,可以吸收一定程度的流量波动。
缓冲区把容量优势换成了时延
统计复用器通常需要缓冲区。当某一时刻到达的数据量小于链路可发送的数据量时,数据几乎可以立即得到服务;当多个终端同时突发,瞬时到达速率超过输出能力时,多出来的数据就必须暂存在队列中。
因此它具有明显的负载相关特征:平均负载较低时,链路空闲容量较多,排队时延很小;平均负载逐渐接近链路能力时,短暂突发更容易造成队列积累;如果长期输入速率超过输出服务能力,队列会持续增长,有限缓冲最终导致数据丢失。
这里的关键不是“统计复用一定更快”,而是它允许用可变时延换取更高的容量共享效率。设计系统时需要同时给吞吐量、允许时延和缓冲容量留出余量。
与同步时分复用的核心区别
| 比较项 | 同步时分复用 | 统计时分复用 |
|---|---|---|
| 时隙分配 | 每路固定、周期出现 | 按当前业务需求动态分配 |
| 空闲终端 | 仍可能占有保留时隙 | 通常不占输出容量 |
| 数据身份 | 可由帧中固定位置确定 | 通常需要地址或信道标识 |
| 时延特征 | 较稳定、容易预测 | 会受排队和负载影响 |
| 适合业务 | 持续、稳定速率 | 突发、间歇性数据 |
选择时不能只看平均利用率。如果业务要求严格固定的传输节拍和确定性时延,同步时分复用的固定资源反而更有价值;如果大量终端具有明显的突发性,而且允许一定排队时延,统计时分复用通常能够用较少的链路容量承载更多终端。
判断是否进入拥塞状态
观察统计复用系统时,可以把“到达速率、输出速率、队列长度”连起来判断。偶尔出现队列并不等于故障,因为缓冲本来就是为了吸收短时突发;真正需要警惕的是队列长期无法回落。
当平均到达速率持续低于输出能力时,突发结束后队列应逐渐清空。如果队列长度长期增长,说明当前服务能力已经无法覆盖实际业务负载,此时继续增加缓冲只能延后丢包发生时间,不能解决容量不足的问题。统计时分复用的收益来自业务的统计互补,而不是凭空创造链路带宽。