
原生移动开发 / 系统课时
处理失败重试与退避
处理失败重试与退避
本篇解决后台任务遇到网络波动、临时服务异常时“应该直接失败,还是稍后再试”的问题。你将区分 Result.success()、Result.failure() 和 Result.retry(),并配置退避策略,让临时故障不会立即形成高频重试。
学习目标
- 能根据任务结果选择成功、失败或重试
- 能配置线性或指数退避策略
- 能区分临时异常与不可恢复错误,避免错误地无限重试
三种结果分别代表什么
Worker 最终通过 Result 告诉 WorkManager 这次执行应该如何结束。Result.success() 表示任务完成;Result.failure() 表示任务已经执行但无法通过再次尝试解决;Result.retry() 表示当前失败更像临时问题,应该按既定退避策略再次调度。
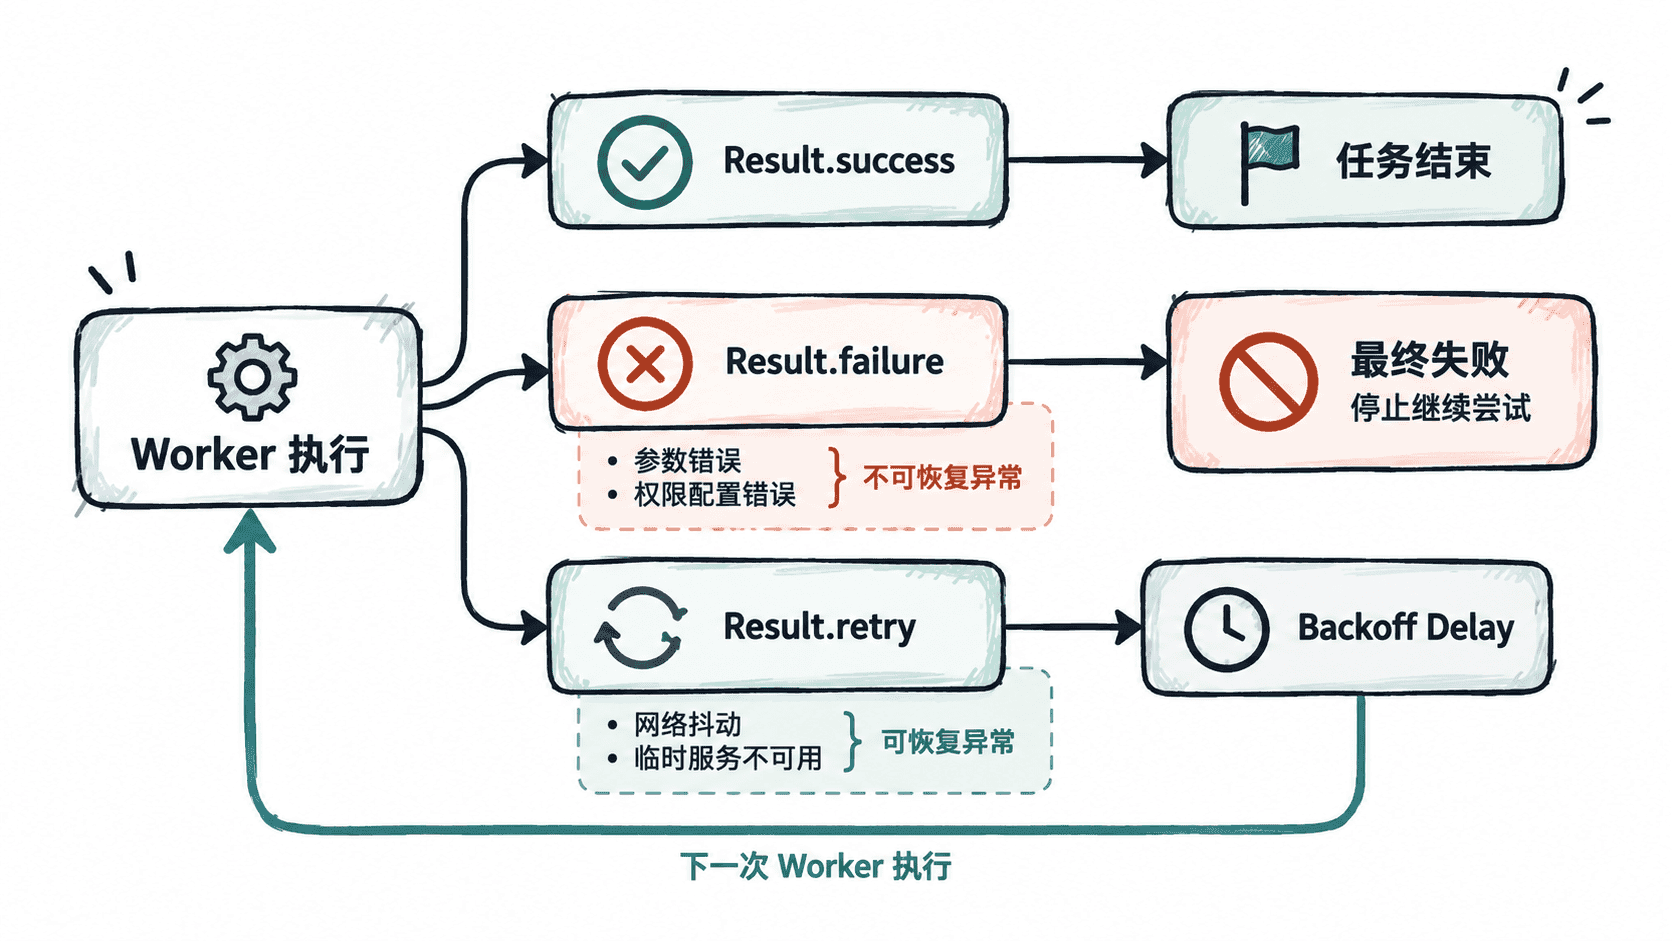
可以把判断原则简单理解为:重试是等待条件变化,失败是等待也没有意义。例如一次 HTTP 请求因为暂时断网失败,通常适合返回 Result.retry();如果服务端明确返回请求参数非法,则继续请求往往只会重复失败,更适合返回 Result.failure()。
配置退避策略
WorkManager 支持线性和指数两种退避方式。指数退避会让连续失败后的等待时间逐步拉长,适合网络抖动或临时服务不可用场景,可以减少短时间内重复请求带来的压力。设置退避时,最短退避时间不能低于 WorkManager 允许的最小值。
import androidx.work.BackoffPolicy
import androidx.work.CoroutineWorker
import androidx.work.OneTimeWorkRequestBuilder
import androidx.work.Result
import androidx.work.WorkerParameters
import java.util.concurrent.TimeUnit
import android.content.Context

class SyncWorker(
    appContext: Context,
    workerParams: WorkerParameters
) : CoroutineWorker(appContext, workerParams) {

    override suspend fun doWork(): Result {
        val succeeded = performSync()

        return when {
            succeeded -> Result.success()
            shouldRetry() -> Result.retry()
            else -> Result.failure()
        }
    }

    private suspend fun performSync(): Boolean {
        // 这里代表业务同步逻辑;真实项目中应由网络或数据库操作返回结果。
        return true
    }

    private fun shouldRetry(): Boolean = true
}

val request = OneTimeWorkRequestBuilder<SyncWorker>()
    .setBackoffCriteria(
        BackoffPolicy.EXPONENTIAL,
        10,
        TimeUnit.SECONDS
    )
    .build()
预期结果
创建成功后,SyncWorker 返回 Result.retry() 时不会立即连续执行,而是按照 EXPONENTIAL 退避策略等待后再次调度;返回 success 或 failure 时分别进入对应的完成状态。正确区分临时错误与永久错误
重试策略真正重要的不是“失败就重试”,而是判断失败是否可能自行恢复。常见临时错误包括网络暂时不可用、服务端短时不可用、连接超时等;常见不可恢复错误包括请求参数非法、认证配置错误、业务数据本身不满足约束等。
可以把业务异常先归类,再决定返回值:
| 异常类型 | 常见处理 | 原因 |
|---|---|---|
| 网络暂时断开 | Result.retry() |
条件可能恢复 |
| 请求超时 | Result.retry() |
下一次可能成功 |
| 服务端临时不可用 | Result.retry() |
适合等待后再试 |
| 参数格式错误 | Result.failure() |
重试不会改变输入 |
| 本地配置错误 | Result.failure() |
需要人工或代码修复 |
不要让重试掩盖真实故障
退避只能降低重试频率,不能修复永久错误。如果一个任务每次都因为同一参数校验失败而返回 Result.retry(),它可能长期占用调度资源,却没有任何成功机会。因此,重试条件应该尽量建立在明确的可恢复信号上。
最终可以用一个简单规则检查实现:任务真正完成就返回 success,明确无法恢复就返回 failure,只把可能因等待而恢复的异常交给 retry,再用退避控制下一次尝试的时间间隔。这样 WorkManager 才能承担可靠调度,而不是变成快速重复失败的循环器。