
原生移动开发 / 系统课时
处理 Service 进程被回收
处理 Service 进程被回收
Service 所在进程被系统回收后,任务不会因为设置了 START_STICKY 就自动完整恢复。你需要先区分系统会重新创建什么、不会保存什么,再决定哪些状态放在持久化存储中、哪些状态必须在 onStartCommand() 中重新初始化。
学习目标
- 理解
START_STICKY、START_NOT_STICKY和START_REDELIVER_INTENT的行为差异 - 明确 Service 重建后可依赖与不可依赖的状态
- 能为可恢复任务设计持久化、幂等和重新初始化策略
返回值真正控制什么
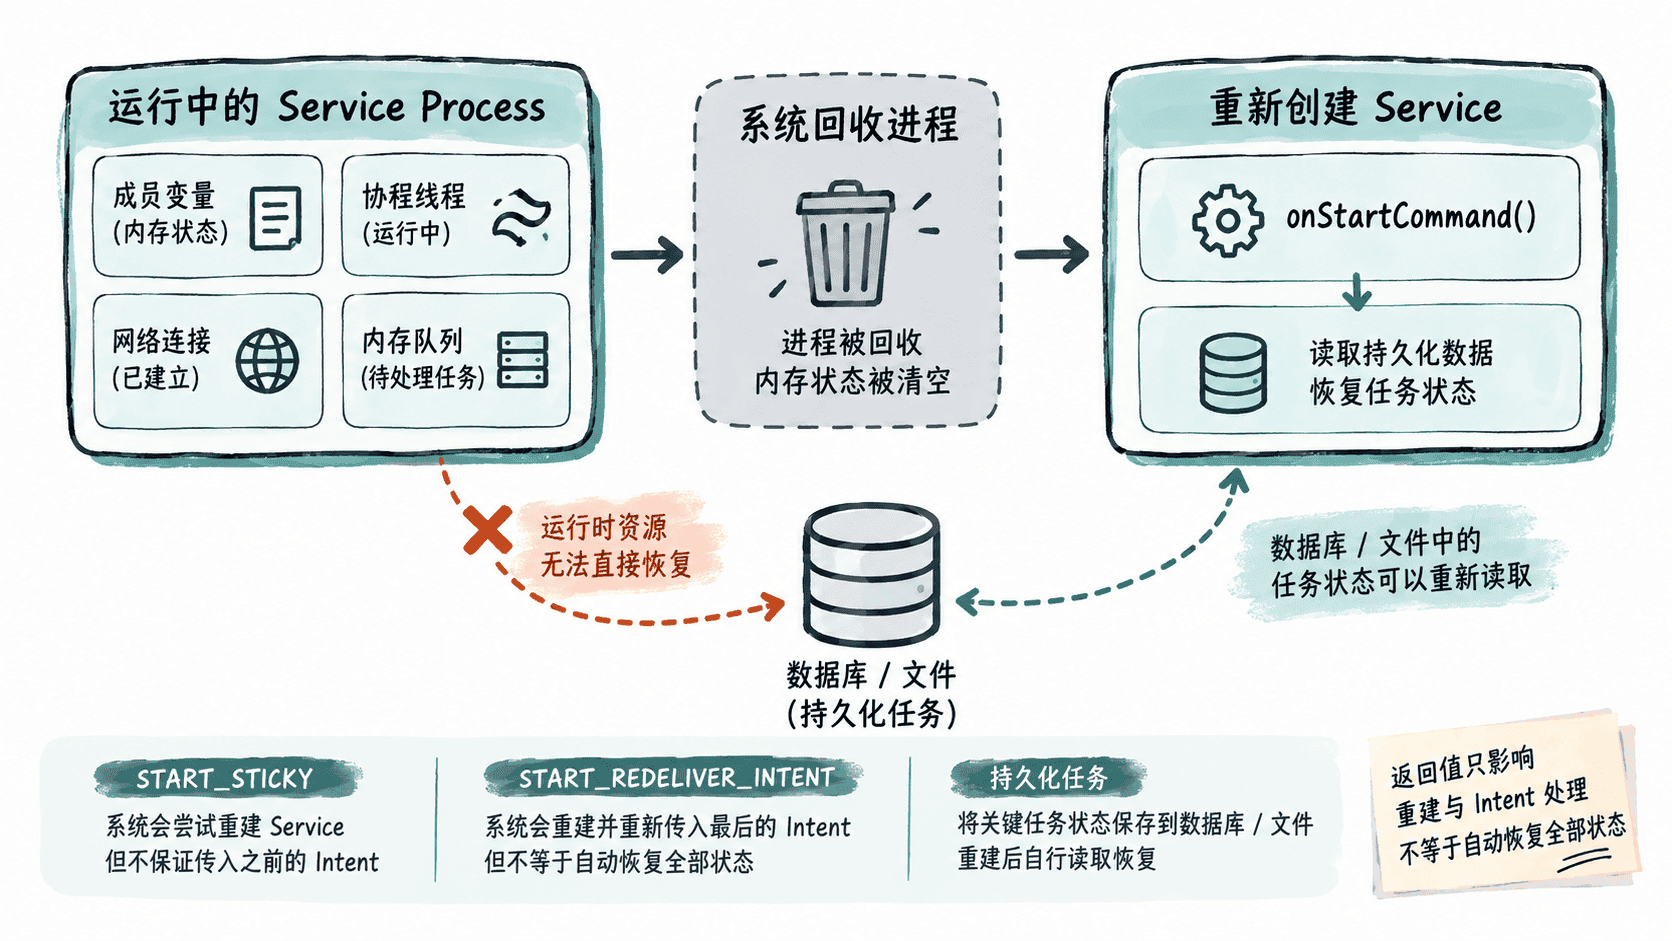
onStartCommand() 的返回值主要告诉系统:Service 进程被杀死后,是否需要尝试重新创建 Service,以及待处理的启动 Intent 如何处理。它不是“保证 Service 永久在线”的开关,也不会替你恢复线程、成员变量或网络连接。
| 返回值 | Service 被回收后的典型行为 | 是否适合依赖原 Intent |
|---|---|---|
START_NOT_STICKY |
没有新的启动请求时,不主动重建 | 不应依赖 |
START_STICKY |
在条件允许时尝试重新创建 Service,但通常不会保留原来的 Intent | 不应依赖 |
START_REDELIVER_INTENT |
尝试重新创建 Service,并重新投递最近一次启动 Intent | 可以依赖,但仍需保证处理逻辑幂等 |
因此,START_STICKY 适合“服务还应该继续存在,但之前那次具体命令可以重新计算”的场景。例如持续执行一个后台同步循环。对于“必须继续处理这一条具体任务”的场景,则更应关注可恢复任务记录,而不是只靠 Service 返回值。
重建时哪些状态会消失
假设 Service 进程被杀死,之后系统重新创建 Service。新的 Service 实例拥有新的进程内存,所以以下内容不能直接依赖:
private var currentJob: Job?这类成员变量- 内存中的队列、缓存、计数器
- 已创建但未持久化的临时对象
- 线程、协程、Socket、数据库连接等运行时资源
能够跨进程生命周期保留下来的,通常是持久化数据,例如数据库记录、文件或其他可靠存储。系统重新创建 Service 后,应把这些数据重新读取并初始化运行状态。
一个最小的处理示例
下面的 Kotlin 示例演示一种常见策略:使用 START_STICKY 让 Service 在需要时重建,但启动后重新从持久化层读取任务,而不是依赖成员变量保存任务状态。示例中的 TaskStore 是片段示例,需要由实际项目中的数据库或文件存储实现。
import android.app.Service
import android.content.Intent
import android.os.IBinder

class SyncService : Service() {
    private val store = TaskStore()

    override fun onStartCommand(intent: Intent?, flags: Int, startId: Int): Int {
        // 进程重建后重新读取可执行状态,避免依赖旧实例的内存变量。
        val pendingTask = store.findPendingTask()
        if (pendingTask != null) {
            runSync(pendingTask)
        }
        return START_STICKY
    }

    private fun runSync(task: Task) {
        // 真实项目中应保证重复执行不会产生重复业务副作用。
        store.markRunning(task.id)
    }

    override fun onBind(intent: Intent?): IBinder? = null
}

data class Task(val id: String)

class TaskStore {
    fun findPendingTask(): Task? = null // 片段示例:实际应从持久化存储读取
    fun markRunning(id: String) { /* 片段示例:实际应更新持久化状态 */ }
}
预期结果
Service 启动后读取持久化任务;即使旧 Service 实例的内存状态已经丢失,重建后的实例仍可从 TaskStore 获取待执行任务。不要把“重建”当成“恢复”
START_STICKY 不能保证任务一定继续执行,也不能保证 Service 在后台长期存活。系统资源紧张、后台限制、应用进程状态等因素都可能影响实际生命周期。因此真正需要可靠完成的任务,应把“任务是否已完成、执行到哪一步、是否可以重试”等信息持久化。
同时,恢复逻辑必须考虑幂等性。例如一次上传已经在服务器成功,但客户端进程恰好在确认结果前被杀死,Service 重建后可能再次发起上传。任务设计应使用业务唯一 ID、服务端去重或状态机,避免重复副作用。
什么时候选择其他返回值
当一次启动请求本身携带了必须继续处理的具体参数,可以考虑 START_REDELIVER_INTENT,但仍应让处理过程具备幂等能力。对于“被杀后无需自动恢复”的短期服务,则可以使用 START_NOT_STICKY。
最终判断标准很简单:返回值负责描述 Service 被回收后的重建意图,持久化负责保存业务状态,幂等负责保证重试安全。 把这三者分开,Service 被回收后才能真正做到可恢复。