
交互与用户体验 / 系统课时
以质量指标迭代对话体验
以质量指标迭代对话体验
一条回复即使显示得很快,也可能因为答案不可信、操作无法完成而让用户反复尝试。本课用五项质量指标建立可核对的统计口径,结合一组实际可复算的样例,完成问题分群、改动排序和上线验收。
学习目标
- 统一首字等待、任务完成、重试、引用查看和负向反馈的统计口径。
- 根据分群数据判断问题发生在等待、核验还是任务完成环节。
- 用预期收益和风险门槛制定一次可执行的对照实验。
固定指标口径,避免数字失真
先定义统计单位:一个“任务”是用户试图完成的同一个目标,多轮追问仍算同一任务;一条“回答”是一次可评价的助手回复。统计时记录客户端版本、任务类型、设备和网络类型,并单独报告无法判断结果的任务占比。
| 指标 | 计算口径 | 必须排除或补充的情况 |
|---|---|---|
| 首字等待时间 | 从用户点击“发送”到第一段非空、可读的助手正文出现在屏幕;同时报 p75、p95 与有效耗时记录数 | 只对观测到有效正文的尝试计算分位数;另报超时、失败、取消及埋点缺失 |
| 任务完成率 | 有明确成功证据的任务数 ÷ 可判定结果的任务数 | 不能把“回答结束”或“用户未再说话”直接当成功 |
| 重试率 | 至少一次主动重试或重新生成的任务数 ÷ 进入观测的全部合格任务数 | 网络层自动重连不算用户重试;改写问题另报“重述率” |
| 引用查看率 | 至少有一次引用点击的带引用回答数 ÷ 全部带引用回答数 | 无引用的回答不进分母;另记跳转是否成功 |
| 负向反馈率 | 至少出现一次负向反馈的可评价回答数 ÷ 全部可评价回答数 | 同一回答去重;并报参与反馈的回答数及反馈用户数 |
任务成功必须按场景验收:例如资料查找任务要求用户确认找到可用依据,文件导出任务要求服务端返回成功凭证。开放式问答如果缺少可核验证据,应记为“未知”,不能强行判成功。
用一周样本识别瓶颈
以下均为合成数据。七天纳入 1100 个合格任务,1000 个结果可判定,100 个结果未知。以每任务的首轮尝试统计,有 900/1100 测到有效首字。另有 1000 条可评价的主回答,其中 400 条带引用,200 条回答收到任何反馈。下表的目标只是本产品的示例目标,不是通用行业标准。
| 指标 | 当前观测 | 阶段目标 |
|---|---|---|
| 首字等待 p75 / p95 | 3.8 秒 / 7.5 秒(n = 900,假设观测值) | ≤2.5 秒 / ≤5.0 秒 |
| 任务完成率 | 720 / 1000 = 72% | ≥80% |
| 主动重试率 | 198 / 1100 = 18% | ≤12% |
| 引用查看率 | 96 / 400 = 24% | 不单独追求升高 |
| 负向反馈率 | 60 / 1000 = 6%;反馈参与 200 / 1000 = 20% | ≤4% |
仅看总完成率,会误以为所有场景都差不多。按目标类型拆分后,资料查找类为 140 / 250 = 56%,其余任务为 580 / 750 ≈ 77.3%。两组加总仍是 720 次成功。先比较两组未知率和用户构成,再用个案排查资料类回答的依据呈现、引用定位及后续操作,而不是给全站统一增加一个“重新生成”按钮。
还要交叉看移动端与桌面端、弱网与正常网络、首次提问与重试后的结果。每组同时展示分子和分母;样本只有十几条时不据此宣布结论。
沿用户路径定位交互改动
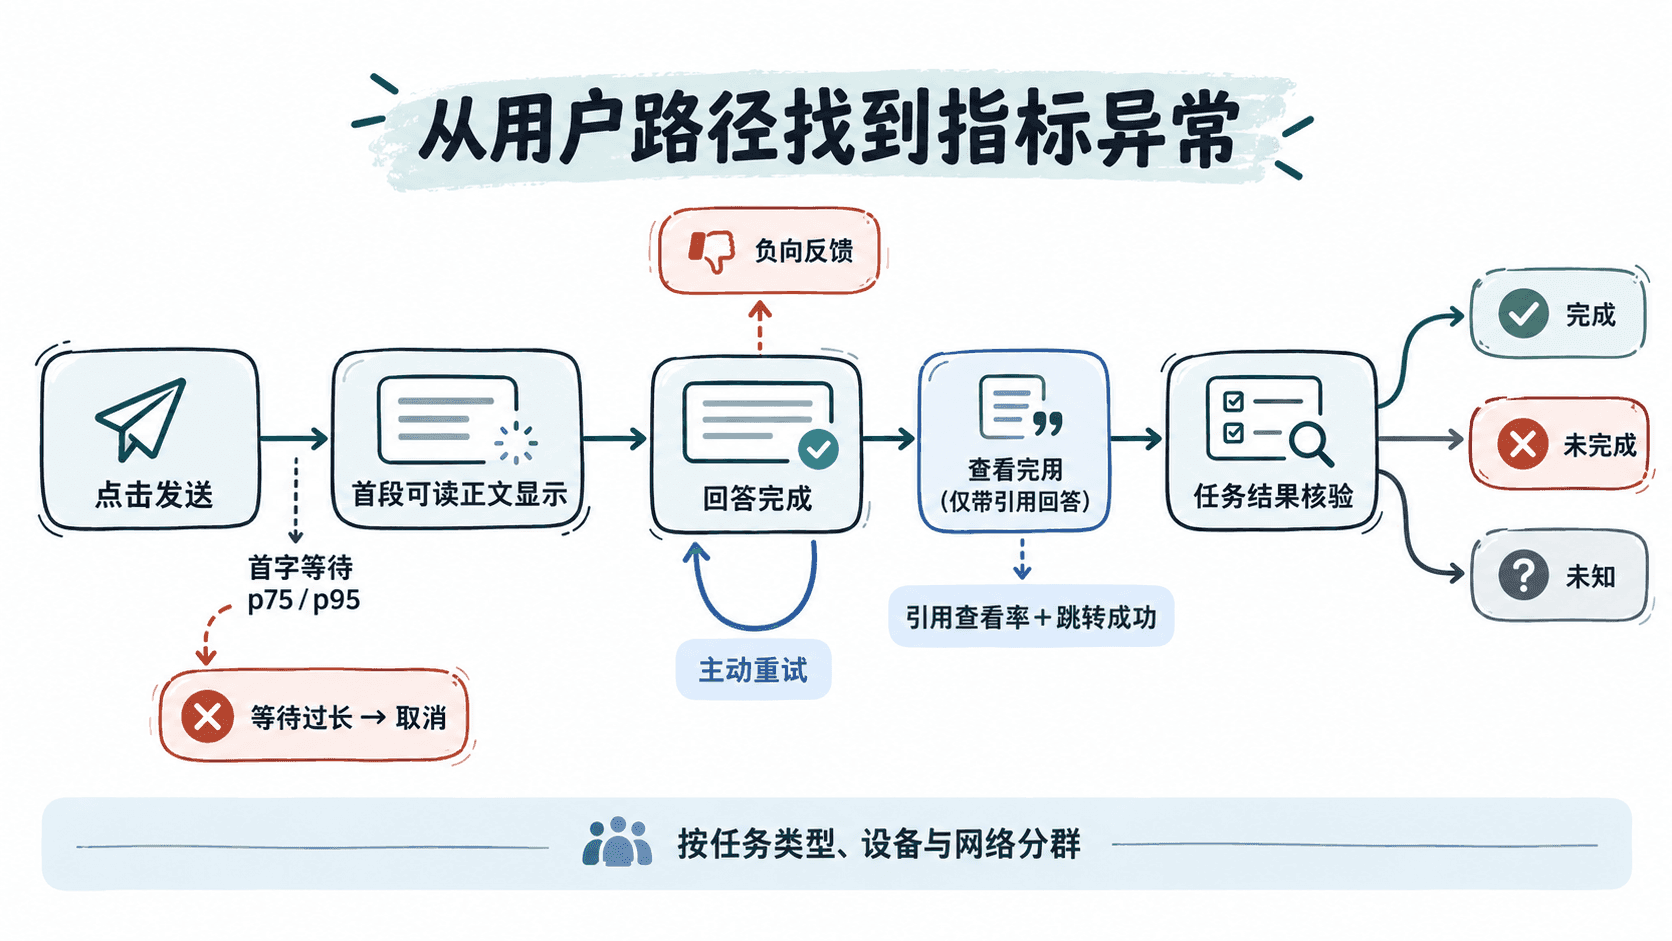
根据路径分别开改动单:首字慢时,用客户端同一单调时钟记录提交到正文提交渲染的耗时。DOM 提交或渲染帧只是上屏的近似,需明确代理事件和页面可见性规则。超过 600 毫秒仍未出现正文,可展示真实阶段的等待提示,并始终提供取消入口,但提示不能冒充首字,也不能靠动画“改善”指标。
资料任务完成率低时,优先修复“断言旁引用—来源摘要—原文定位”的核验链。查看率从 24% 升到 30% 不一定代表更好,可能是答案难以理解,迫使用户反复核查;需要连同跳转成功率、完成率一起看。跳转成功应指向对应来源的具体段落,而不只是打开一个网页。
重试率升高时,抽样区分回答不相关、引用打不开、工具失败和用户主动探索。对可恢复错误提供明确失败原因及重试入口;如果原任务可能产生付款、删除等副作用,先查询执行结果,不允许直接重复提交。
用可复算的收益排序
排序前先估计每项改动影响多少任务、能挽回多少成功,以及估计依据有多可靠。可用“优先级得分 = 每周受影响任务数 × 假设成功率增量 × 证据权重 ÷ 开发与验证人日”作粗排。
| 候选改动 | 受影响任务/周 | 假设成功率增量 | 证据权重 | 人日 | 排序得分 |
|---|---|---|---|---|---|
| 修复引用定位与来源预览 | 250 | 12 个百分点 | 0.70 | 3 | 250 × 0.12 × 0.70 ÷ 3 = 7.0 |
| 改善等待阶段提示与取消反馈 | 400 | 4 个百分点 | 0.80 | 2 | 400 × 0.04 × 0.80 ÷ 2 = 6.4 |
按本组假设先做引用链修复。得分只是排序假设,不是已实现的收益:成功率增量必须来自用户访谈、失败样本和小流量实验的证据。影响安全、隐私或错误扣费的问题不参与这种收益排序,应作为发布阻断项直接处理。
复算统计分母
下面的 Python 示例复算上表的比例。未知任务单独报告,并计算极端假设下的整体完成率范围。这个范围是缺失结果的敏感性分析,与抽样置信区间是两件事。分位数需要实际时延记录,无法用这些计数反推。
def rate(numerator, denominator):
    if type(numerator) is not int or type(denominator) is not int or not 0 <= numerator <= denominator:
        raise ValueError("invalid counts")
    return "无可用分母" if denominator == 0 else f"{numerator / denominator:.1%}"


eligible, known, completed = 1100, 1000, 720
unknown = eligible - known
print("可判定任务完成率", rate(completed, known))
print("结果未知率", rate(unknown, eligible))
print("整体完成率范围", rate(completed, eligible), "至", rate(completed + unknown, eligible))
print("主动重试率", rate(198, eligible))
print("引用查看率", rate(96, 400))
print("负向反馈率及参与率", rate(60, 1000), rate(200, 1000))
预期输出
可判定任务完成率 72.0%
结果未知率 9.1%
整体完成率范围 65.5% 至 74.5%
主动重试率 18.0%
引用查看率 24.0%
负向反馈率及参与率 6.0% 20.0%
对照验证与上线验收
将资料查找任务完成率定为主指标,用首字等待、负向反馈和跳转成功率作护栏。预先定义成功、未知、引用跳转成功和可评价回答。跳转成功率以有效尝试为分母,并报告点击后无结果回执的比例。测试引用组件时保留模型和提示词版本,避免混入其他变化。
- 预登记。写明主要指标、最小可检测效果、样本量、最短观察周期、成熟窗口、终止条件及分析方法。样本量按基线、误差水平、统计功效和随机化单位估计。七天可以覆盖本例的一周使用节律,不能单独保证样本充足。
- 小流量查链路。先在少量符合条件的流量验证埋点与授权。试运行数据是否进入正式分析须提前约定。正式阶段按稳定用户 ID 随机分配;同一用户多轮任务应看到同一组。团队共享界面时按团队分配,并让区间估计反映这种聚类。
- 核对样本质量。在看收益前检查实际组别比例是否偏离分配比例、事件是否丢失、两组未知率是否不同。核对整体分配人群的结果,避免只分析点击过引用的人。样本比例异常未解释时先排查分配和埋点。
- 按计划判定。本例可要求完成率点估计提升至少 5 个百分点且差异区间排除零,并核对跳转成功率至少 98%、首字 p95 恶化不超过 0.5 秒、负向反馈率恶化不超过 1 个百分点。该例的点估计门槛不表示真实提升已被证明达到 5 个百分点。护栏要预先说明如何使用区间和缺失数据判定。
- 处理中途变化。固定期限设计下,按事先约定的截止时间和样本规则分析;到期样本不足时记为不确定,或按预登记的延展方案处理。若计划中期判断收益,应使用预先定义的序贯方法。发现越权跳转、重复执行等安全问题可立即停止,并记录为安全停止。正式通过后分阶段扩量,沿用同一验收和回滚条件。
上线记录保留实验版本、单位、各组样本数、分母、未知率、区间、护栏及停止原因。小流量故障排查、正式对照检验和上线扩量应各自标记,避免把上线后的描述性变化当成实验因果结果。