
游戏叙事与剧情 / 系统课时
处理多语言文本与本地化
处理多语言文本与本地化
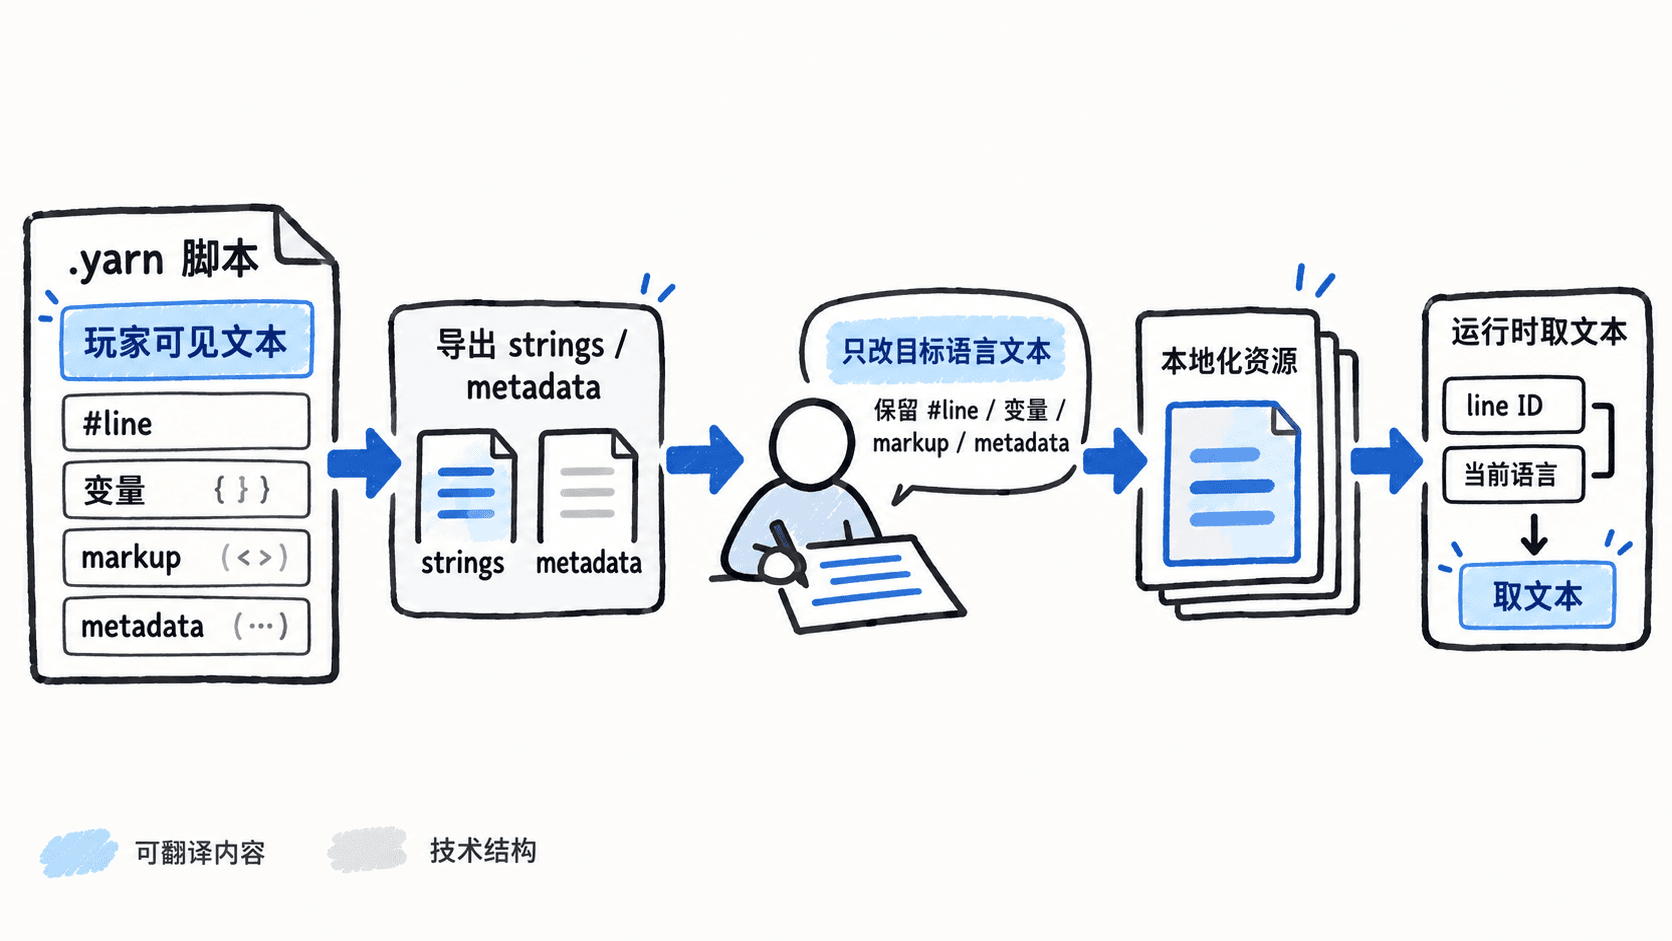
对话本地化最容易出问题的不是“译得不准”,而是翻译后丢了行标识、变量、标记或语境,导致运行时取错文本甚至显示异常。本节把 Yarn Spinner 的文本身份、翻译边界和回填检查串成一条可执行流程。
学习目标
- 理解
#line行标识在多语言匹配中的作用,并避免翻译时破坏它。 - 能区分可翻译文本与变量、标记、节点结构等不可随意改动的内容。
- 建立从源脚本、导出、翻译到回填验证的基本检查流程。
先固定“这句话是谁”
本地化系统需要把源语言中的一句话,与其他语言中的同一句话稳定对应起来。Yarn Spinner 使用每行或选项上的 #line 标识作为这种身份;文本可以变,身份不应因为翻译而改变。
下面是片段示例,需放在已经纳入 Yarn Project 的 .yarn 文件中,且变量 $playerName 已声明。重点不是固定某个 ID 值,而是让每条需要本地化的玩家可见文本都有唯一且稳定的行标识。
title: ShopGreeting
---
Clerk: 欢迎回来,{$playerName}。 #line:9b71c2
-> 看看商品 #line:3e8a41
-> 以后再说 #line:5a1f90
===
这段脚本进入本地化流程后,翻译人员应修改玩家看到的语言内容,而不要把 #line 当成句子的一部分重写。若项目让 Yarn Spinner 自动生成行标识,也应在导出翻译后避免无意义地删除并重新生成它们。
明确哪些内容可以翻译
真正需要翻译的是面向玩家的自然语言,但一行里往往还混有运行时结构。变量插值、Yarn 标记以及用于匹配内容的行 ID,都可能影响程序行为,因此翻译稿不能只做“整格覆盖”。
例如,源文本中包含玩家名变量时,译文可以调整语序,但必须保留动态值能够被正确替换。若团队使用自定义 markup,还要确认成对标记、属性和值是否允许翻译,不能由译者自行猜测。
把上下文一起交给翻译
孤立的一句“好吧”可能是接受、无奈、讽刺或拒绝。对话翻译除了原文,还需要角色、节点、场景和语气信息,否则语言正确也可能戏剧含义错误。
Yarn Spinner 的导出数据可以携带文件、节点、行号、评论或 metadata 等上下文。团队应把这些信息随翻译表一起交付,并约定哪些列只读。对于需要特殊语气的行,可在源脚本用项目约定的 metadata 标记,而不是在外部表格维护一份容易失步的备注。
用变更检测处理源文改写
本地化并不是一次性导出。源语言脚本继续迭代后,应使用项目支持的“更新已有 strings 文件”流程,让新增、删除和已改写的源句重新进入待翻译状态,而不是手工复制整张表覆盖旧译文。
检查时重点关注三类变化:新增行是否获得新 ID;仅修改措辞的旧行是否仍对应原 ID;已经删除的源文本是否从待发布资源中消失。这样才能把“剧情修改”转化为可追踪的翻译增量,而不是每次重做全量文本。
回填后验证运行时结果
完成翻译后,至少用一个包含变量、一个包含选项、一个包含 markup 的节点进行目标语言走查。验证的不只是“有没有翻译”,还包括变量是否替换、标记是否解析、选项是否仍指向原分支,以及字符长度变化后 UI 是否可读。
如果某个语言出现原文、空文本或错误行,优先检查行 ID 是否匹配、本地化资源是否更新、当前语言配置是否指向正确资源,再检查译文本身。这样能把“翻译问题”和“资源映射问题”分开定位。